
 Помощник сценариста▸
 AI Приложения
 AI Новости
JoyGen: фреймворк генерации 3D-видео говорящих лиц на основе аудио
JoyGen: фреймворк генерации 3D-видео говорящих лиц на основе аудиоОписание
JoyGen — это фреймворк для генерации 3D говорящих лиц в видео с аудиоуправлением, разработанный совместно JD Technology и Гонконгским университетом. Это инновационный двухэтапный фреймворк, основная идея которого заключается в управлении 3D-моделью с распознаванием глубины с помощью аудиовхода, что обеспечивает точную синхронизацию движения губ с аудио, позволяя точно воспроизводить движения губ и мимику говорящего, делая сгенерированное видео более реалистичным. Основные области применения — монтаж видео и виртуальное взаимодействие.
JoyGen обучен на наборе данных китайских говорящих лиц, содержащем 130 часов высококачественного видео. В сочетании с открытым набором данных HDTF (набор данных высокого разрешения с картами глубины) он поддерживает ввод на китайском и английском языках.
Кроме того, JoyGen учитывает эмоциональные характеристики аудио, что позволяет естественно передавать эмоциональные изменения персонажа в сгенерированной анимации, такие как улыбка или нахмуривание, что делает его очень мощным инструментом.
Ключевые функции JoyGen:
Многоязычная поддержка: JoyGen способен обрабатывать аудиовход на китайском, английском и других языках.
Высококачественное визуальное представление: благодаря детальной проработке мимики и движений губ генерируемое видео выглядит максимально реалистично.
Точная синхронизация губ: анализ аудиохарактеристик и технология карт глубины лица обеспечивают идеальное соответствие движений губ персонажа аудиоконтенту.
Оптимизация монтажа видео: позволяет не только генерировать новое видео, но и редактировать движения губ в существующих видео, без необходимости создавать всю видеопоследовательность с нуля.
Эффективная техническая архитектура: использует одношаговую архитектуру UNet, что значительно упрощает процесс монтажа видео.
Технические принципы:
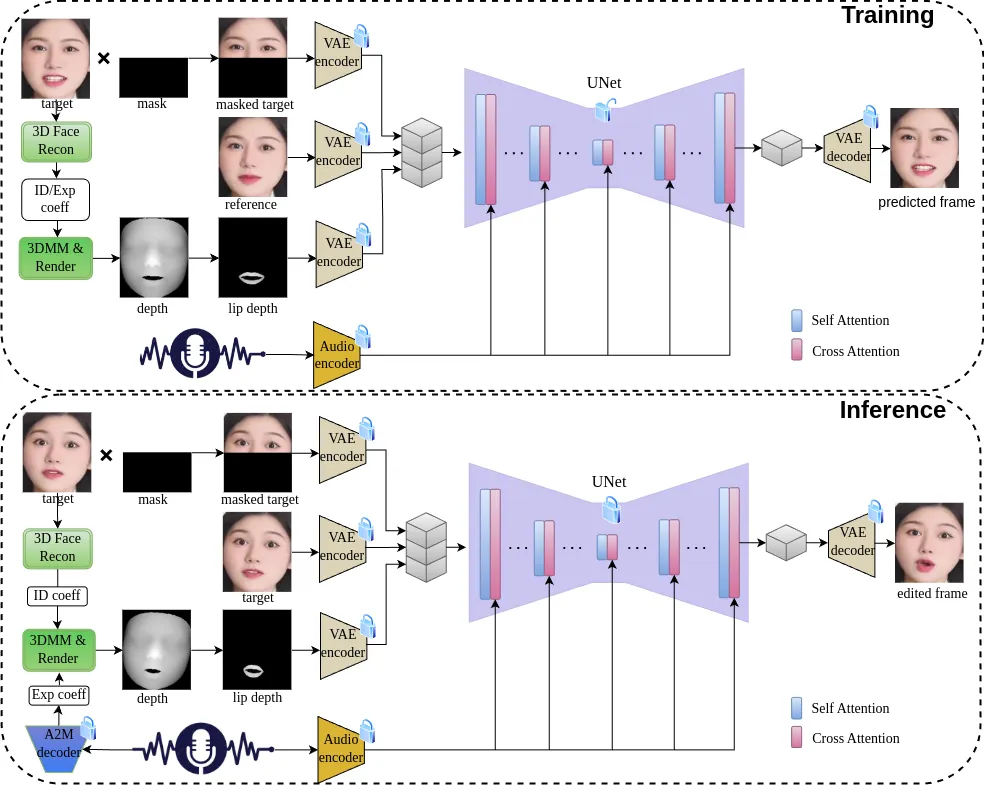
1. Генерация движений губ на основе аудио:
Используется 3D-модель реконструкции для извлечения идентификационных характеристик из изображений лица, определяющих уникальную структуру лица персонажа.
С помощью модели «аудио-в-движение» аудиосигнал преобразуется в коэффициенты выражения, управляющие движениями губ.
Объединение идентификационных характеристик и коэффициентов выражения с применением дифференцируемого рендеринга позволяет генерировать карты глубины лица, подготавливая данные для последующего синтеза видео.
2. Синтез визуального представления:
Одношаговая сеть UNet интегрирует аудиохарактеристики и карты глубины, напрямую генерируя видеокадры с точными движениями губ.
Внедрение механизма перекрёстного внимания обеспечивает высокую степень согласованности движений губ с аудиосигналом, усиливая синхронизацию.
Процесс оптимизации (например, функция потерь L1) гарантирует качество видео, обеспечивая точность как на уровне пикселей, так и в латентном пространстве.
Как использовать JoyGen:
Настройка среды: пользователю необходимо создать специальную среду conda и установить необходимые зависимости, включая такие специфические библиотеки, как Nvdiffrast.
Загрузка предобученных моделей: необходимо получить предобученные модели JoyGen, включая 3D-модель и модель «аудио-в-движение»; обычно эти ресурсы доступны на странице проекта на GitHub.
Запуск инференса: выполняя определённые скрипты с параметрами, пользователь может преобразовать аудиофайл в 3D-видео говорящего лица с реалистичной синхронизацией губ.
Применение JoyGen:
Виртуальные совещания: улучшение мимики во время виртуальных совещаний.
Кинопроизводство: создание спецэффектов в фильмах и на телевидении.
Образование: используется для создания живых обучающих видео.
ai-ассистенты: повышение степени человекоподобия в зоне взаимодействия ИИ-ассистента с пользователем.
JoyGen значительно упрощает сложный процесс генерации видео с лицами и играет очень важную роль в создании контента цифровых людей, виртуальных совещаниях, развлечениях и других областях.
GitHub: https://github.com/JOY-MM/JoyGen














