
 Помощник сценариста▸
 AI Приложения
 AI Новости
Tarsier: масштабная визуально-языковая модель от ByteDance
Tarsier: масштабная визуально-языковая модель от ByteDanceОписание
Tarsier — это серия крупномасштабных визуально-языковых моделей (LVLM), разработанная ByteDance и ориентированная на задачи понимания видео, включая описание видео, ответы на вопросы, локализацию событий и тестирование галлюцинаций.
Основные возможности Tarsier
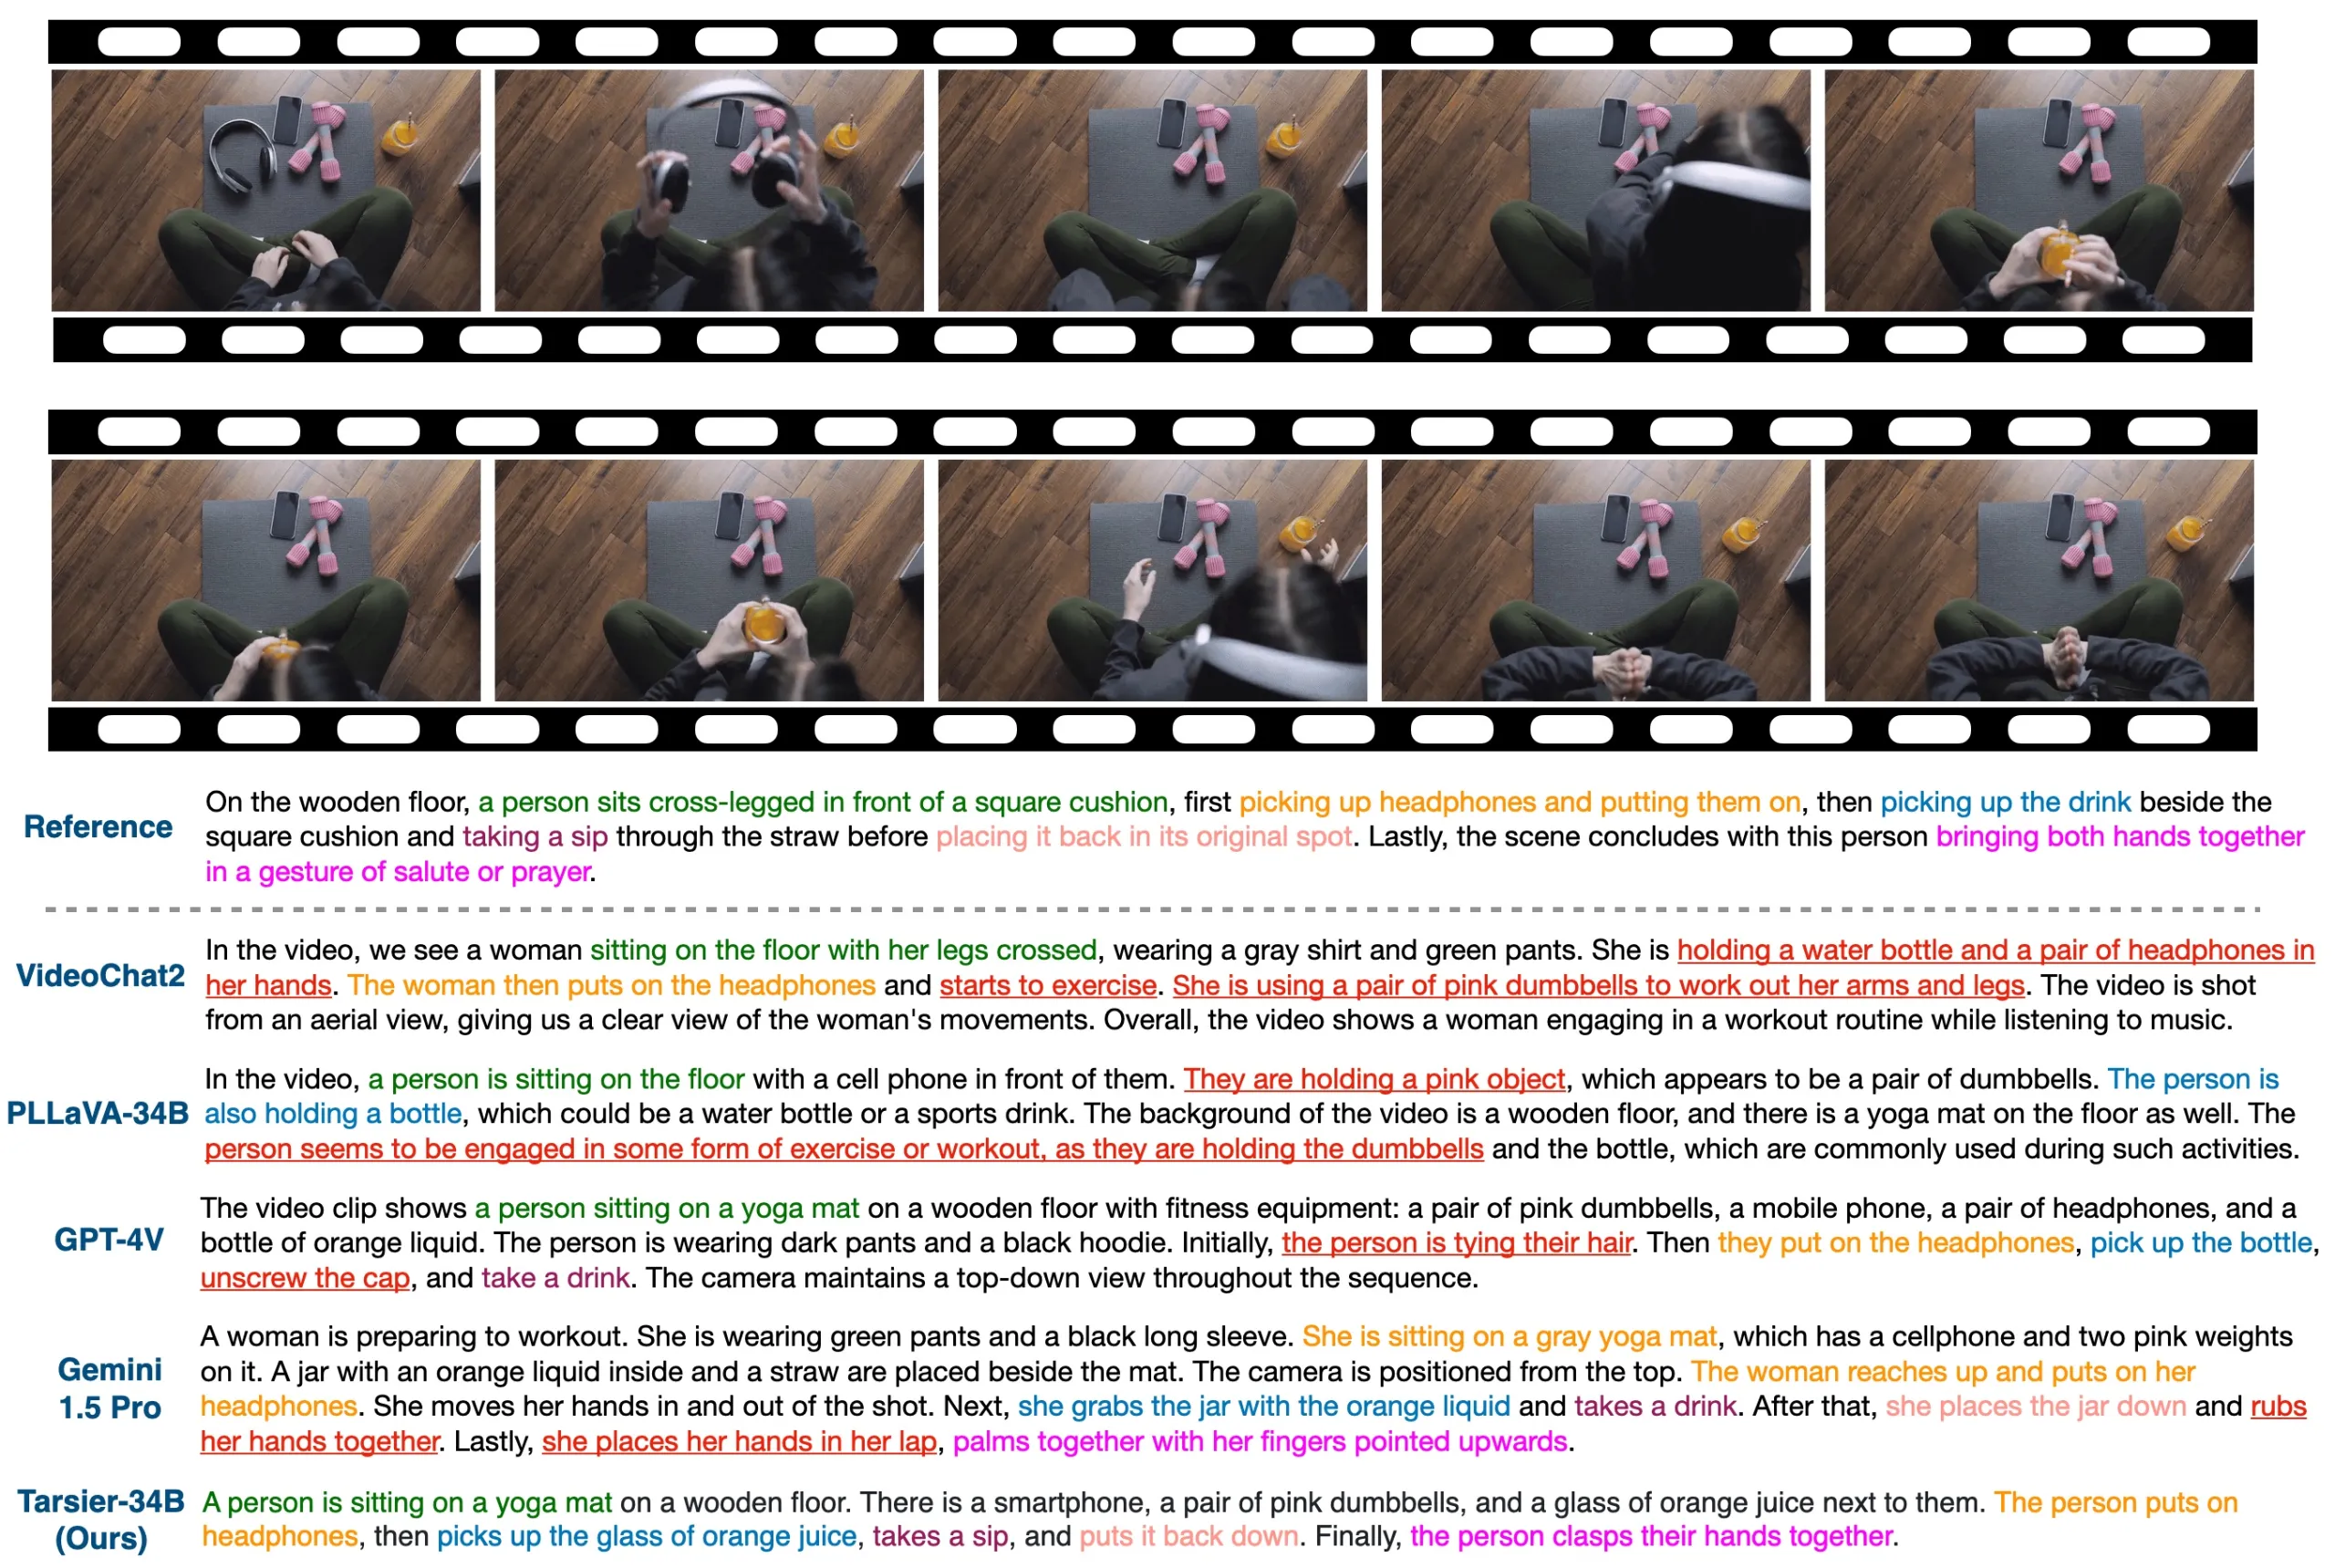
Генерация описаний видео: Tarsier способен создавать высококачественные описания видео, охватывающие различные детали, включая действия, сцены и сюжет, помогая пользователям лучше понимать видеоконтент.
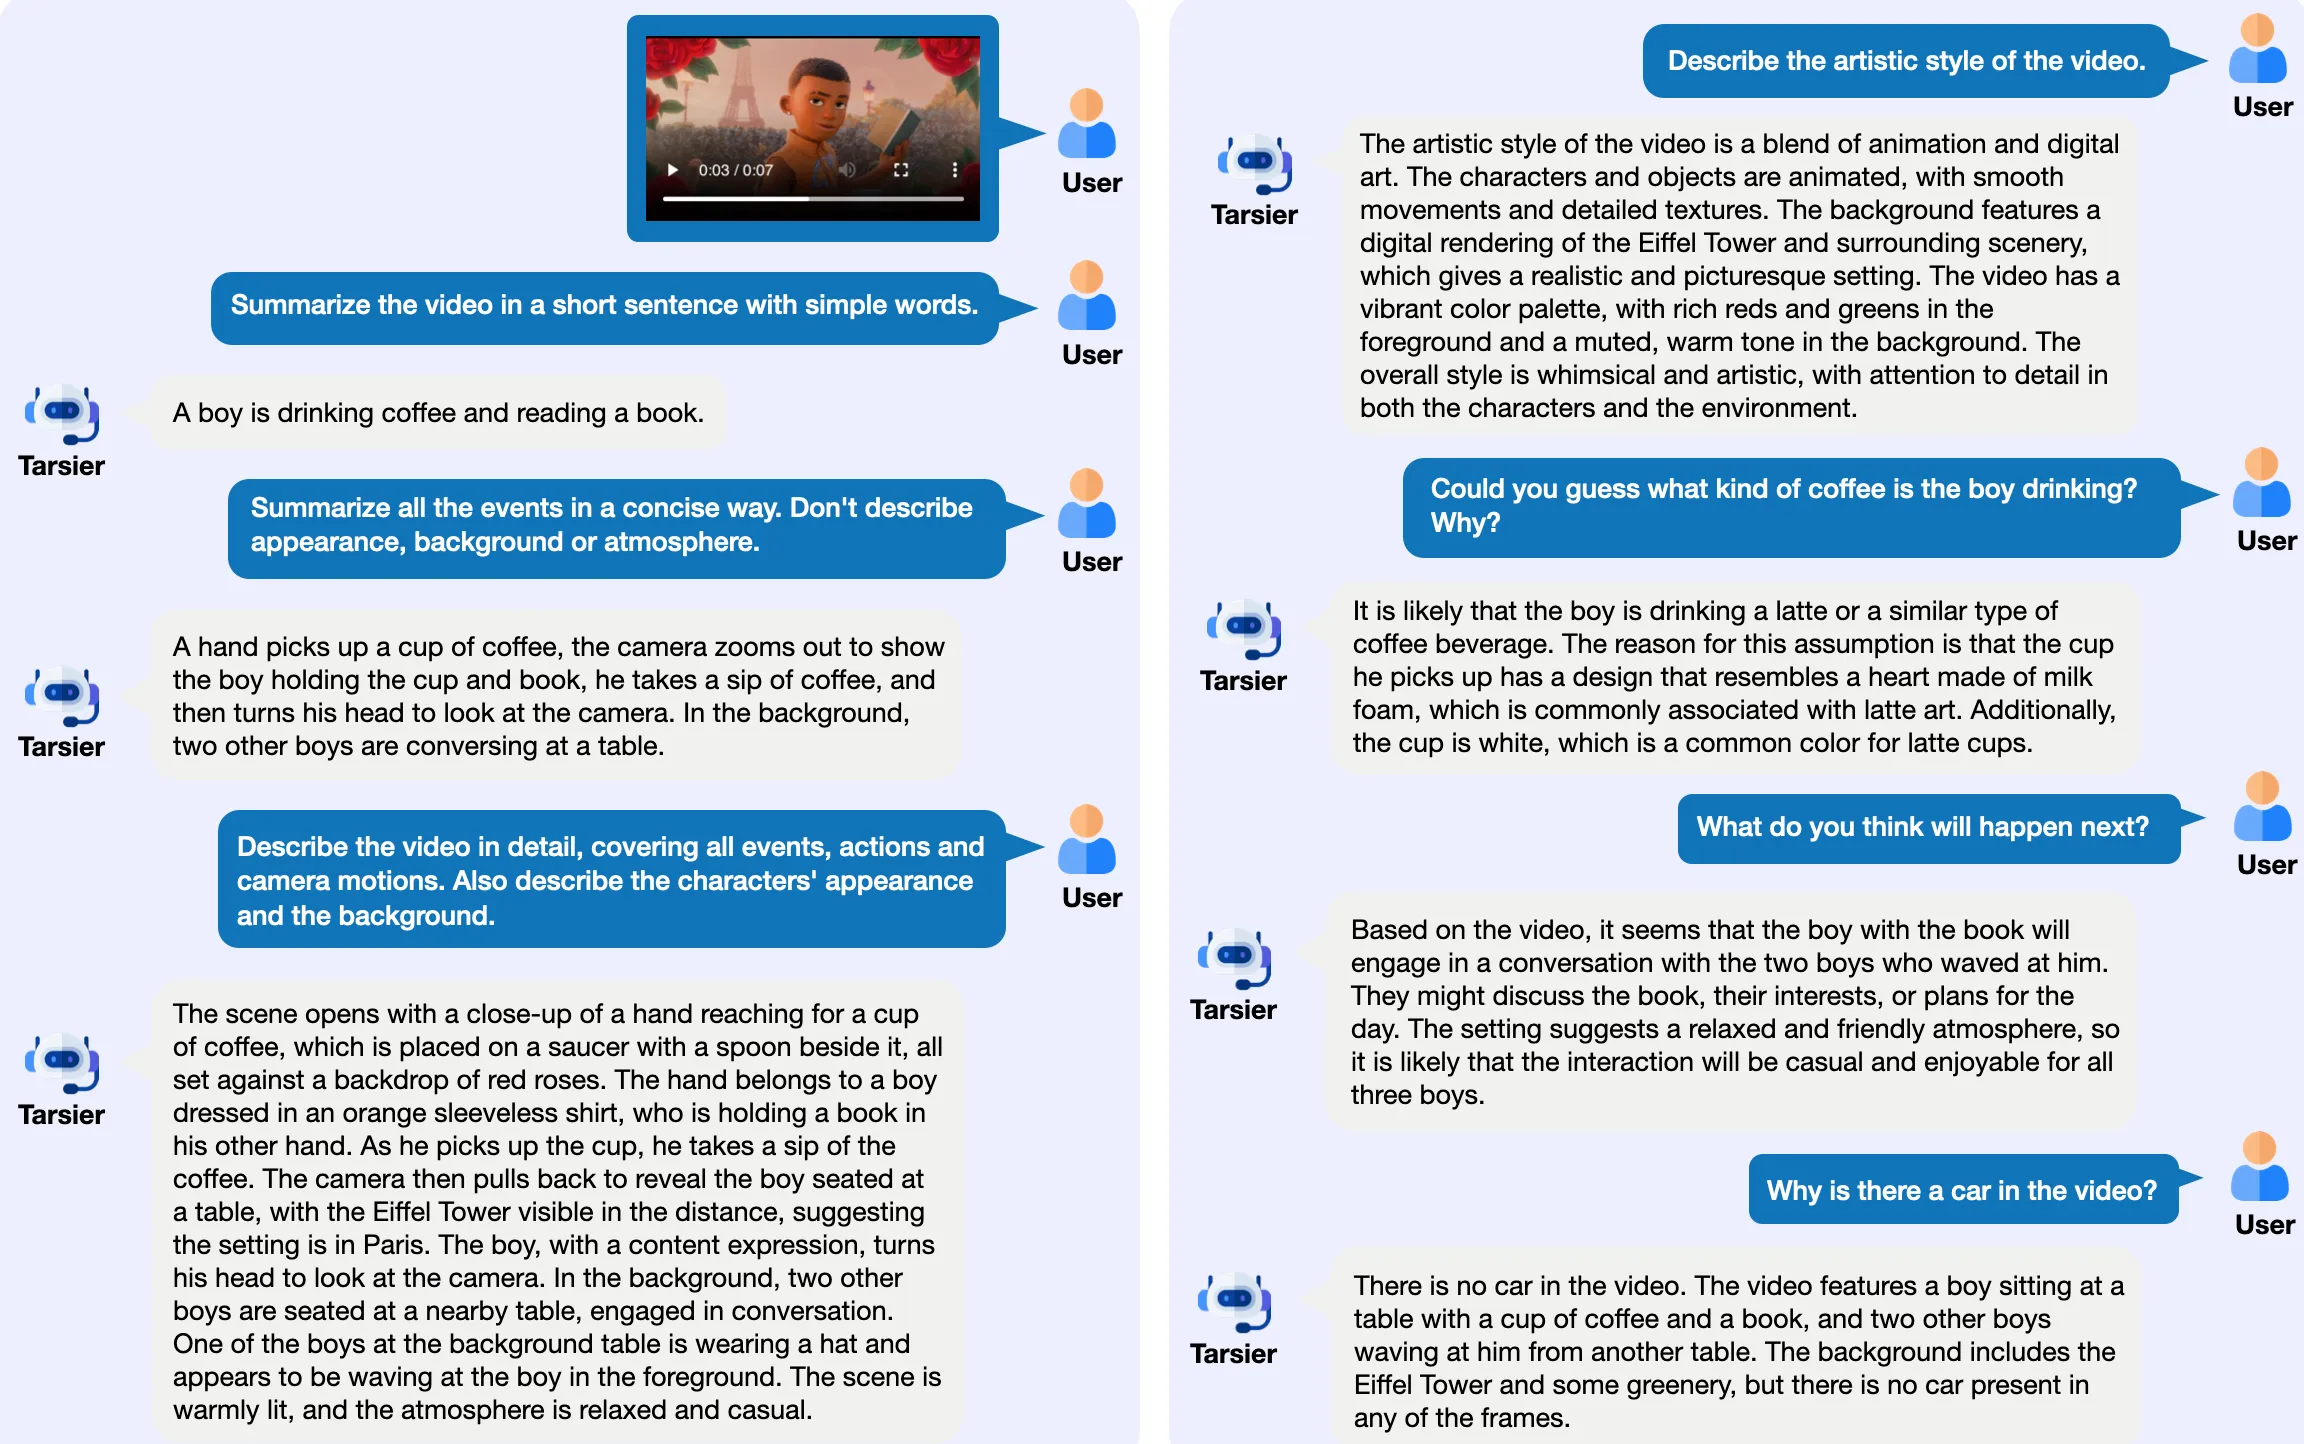
Ответы на вопросы: модель Tarsier поддерживает функцию ответов на вопросы по видео — пользователи могут задавать вопросы на основе содержимого видео, и модель предоставит соответствующие ответы.
Функция локализации: обнаружение и определение времени наступления определённых событий в видео, поддержка локализации в нескольких видеофрагментах, а также возможность распознавания и выделения конкретных объектов или сцен в видео.
Тестирование галлюцинаций: благодаря оптимизации стратегий обучения Tarsier2 значительно снижает вероятность генерации моделью недостоверной информации.
Многоязычная поддержка: поддержка генерации описаний видео на нескольких языках.
Сценарии применения Tarsier:
Создание контента: Tarsier может помогать авторам контента в создании описаний видео, повышая доступность видео и эффективность поисковой оптимизации (SEO).
Образовательная сфера: в образовательных видео Tarsier способен предоставлять подробные описания содержимого, помогая учащимся лучше усваивать учебные материалы.
Социальные сети: социальные платформы могут использовать Tarsier для автоматического создания описаний видеоконтента, улучшая пользовательский опыт.
Видеонаблюдение: в сфере безопасности Tarsier может анализировать видеопотоки и генерировать описания в реальном времени, помогая сотрудникам служб безопасности быстро выявлять потенциальные угрозы.
Роботы: генерация подробных пошаговых инструкций для выполнения определённых задач.
Автономное вождение: помощь транспортным средствам в распознавании дорожной обстановки и поддержка принятия решений.
Последняя версия модели Tarsier, Tarsier2, претерпела значительные улучшения в нескольких аспектах, особенно в отношении объёма и разнообразия данных. Данные для предварительного обучения были расширены с 11 миллионов до 40 миллионов пар «видео–текст», что повысило обучаемость модели. Кроме того, на этапе контролируемого дообучения Tarsier2 внедрила тонкую временную синхронизацию, что дополнительно повысило точность описания видео и способность улавливать детали. Благодаря обучению с прямой оптимизацией предпочтений (DPO) Tarsier2 способна генерировать описания видео, лучше соответствующие человеческим предпочтениям, снижая вероятность появления галлюцинаций.
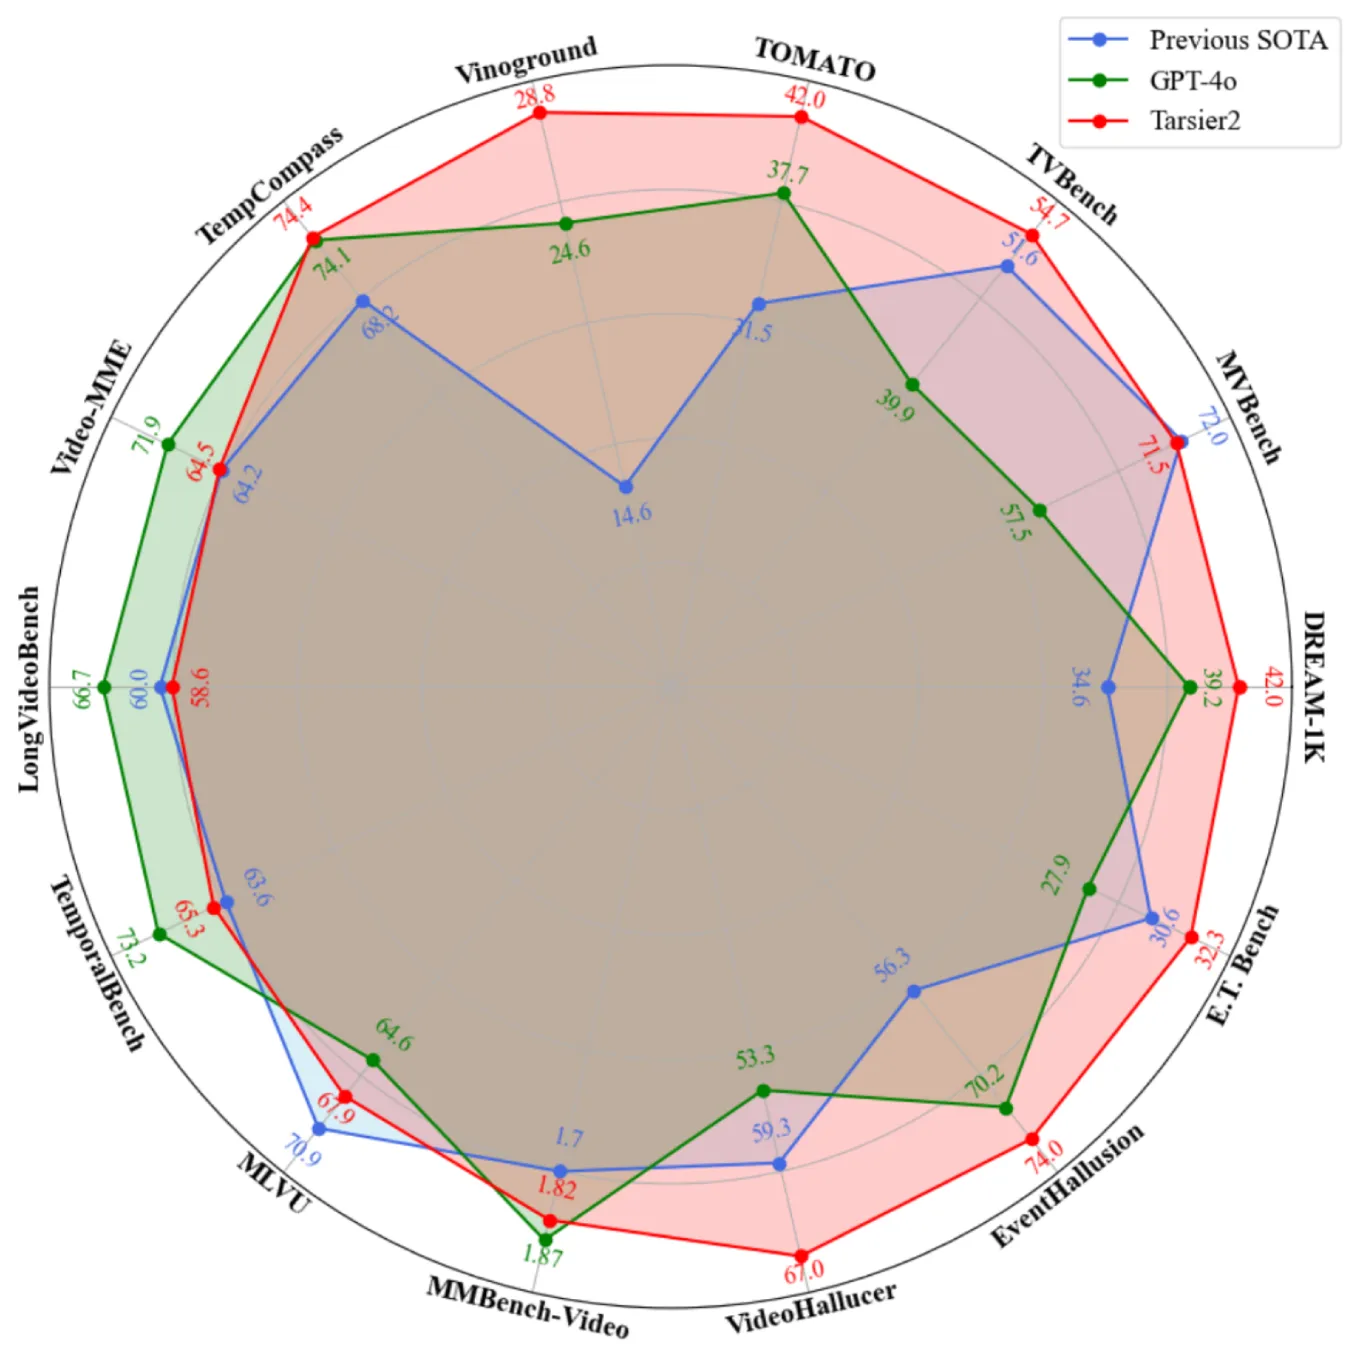
Что касается оценки производительности, Tarsier2 демонстрирует выдающиеся результаты на бенчмарке DREAM-1K: её показатель F1 на 2,8% выше, чем у GPT-4o, и на 5,8% выше, чем у Gemini-1.5-Pro. На 15 общедоступных бенчмарках Tarsier2 достигла новых лучших результатов, охватывающих такие функции, как ответы на вопросы по видео, локализация в видео, тестирование галлюцинаций и вопросно-ответные системы, демонстрируя свою универсальность как мощной универсальной визуально-языковой модели.
Помимо описания видео, модель также демонстрирует высокую производительность в задачах ответов на вопросы, grounding и embodied intelligence.
Статья: https://arxiv.org/abs/2501.07888
Code: https://github.com/bytedance/tarsier
Dataset: https://huggingface.co/datasets/omni-research/DREAM-1K
Demo: https://huggingface.co/spaces/omni-research/Tarsier2-7b














