
 Помощник сценариста▸
 AI Приложения
 AI Новости

Janus-Pro: мультимодальная модель понимания и генерации от DeepSeek
Janus-Pro: мультимодальная модель понимания и генерации от DeepSeekОписание
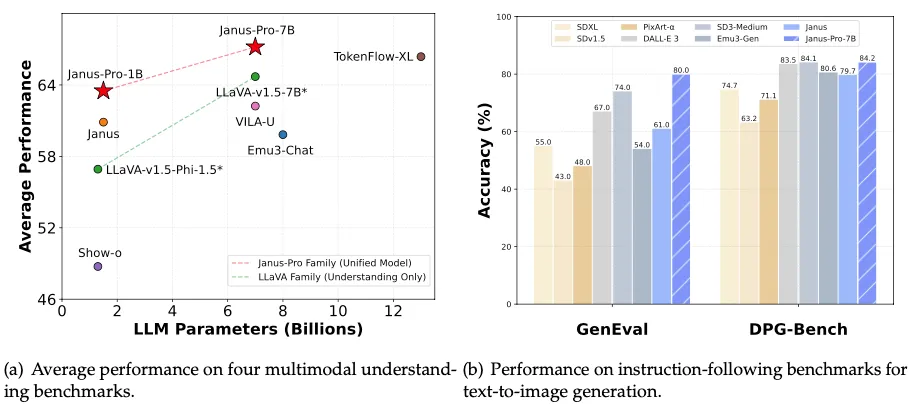
Janus-Pro — это мультимодальная модель понимания и генерации, разработанная и выпущенная компанией DeepSeek. Она ориентирована на задачи генерации изображений и мультимодального понимания, использует авторегрессионную архитектуру и способна унифицированно обрабатывать и генерировать мультимодальную информацию. В отличие от традиционных подходов, Janus-Pro решает ограничения предыдущих методов за счёт разделения процесса визуального кодирования на несколько независимых путей, что повышает адаптивность и производительность модели в различных задачах. Janus-Pro демонстрирует выдающиеся результаты в бенчмарках GenEval и DPG-Bench, превосходя даже Stable Diffusion и DALL-E 3 от Openai.
Ключевые возможности Janus-Pro:
Janus-Pro — это унифицированная мультимодальная модель, способная одновременно выполнять задачи генерации изображений и мультимодального понимания. Основные возможности:
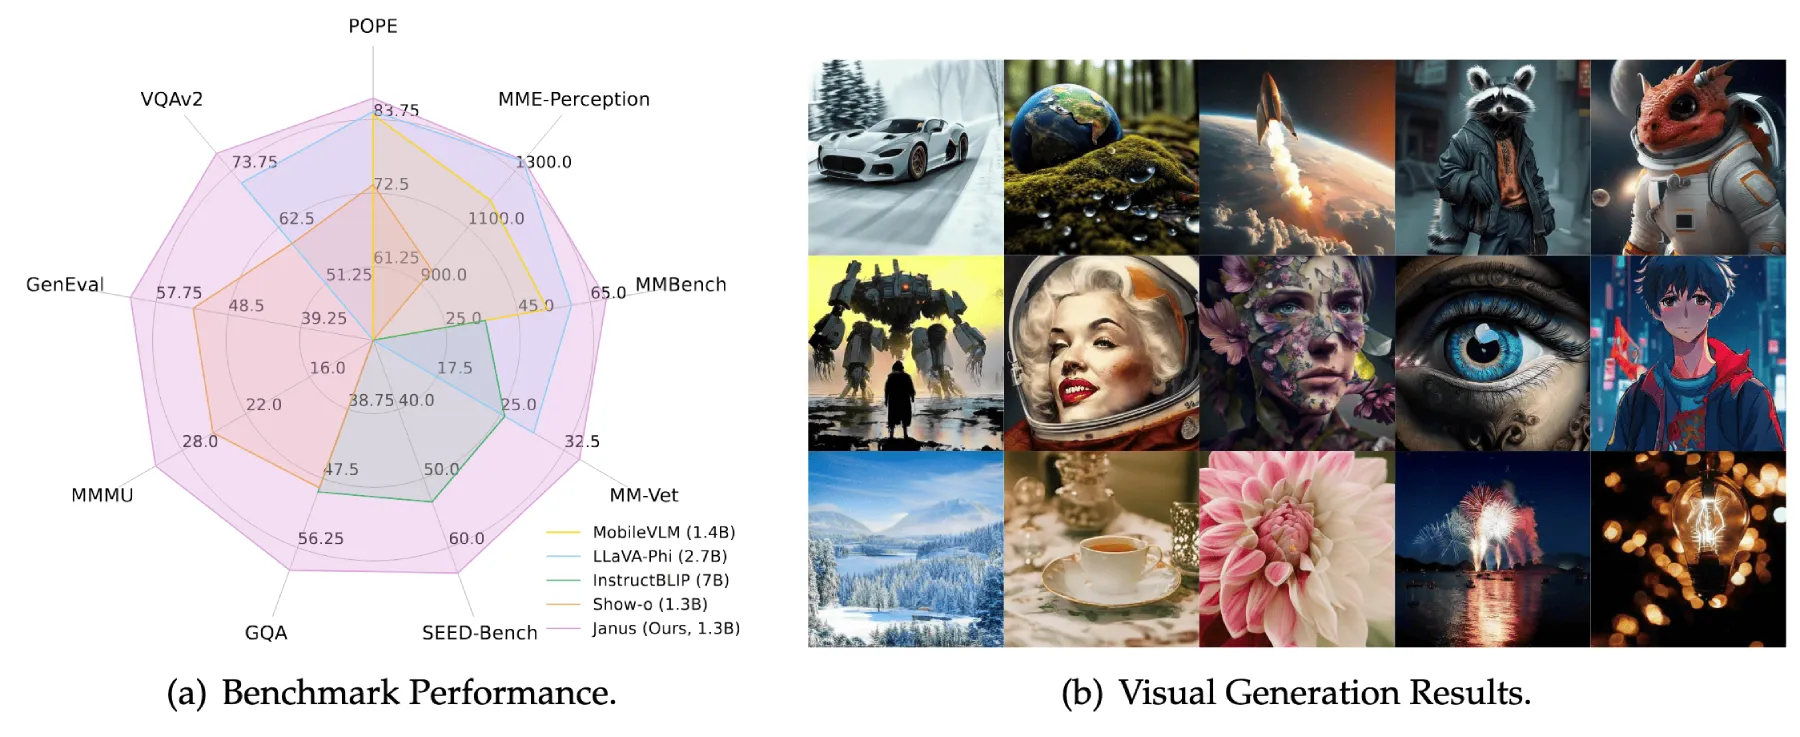
Генерация изображений по тексту (Text-to-Image): создание высококачественных изображений на основе текстового описания с точной передачей сложных сцен и оптимизацией деталей.
Мультимодальное понимание: способность понимать содержимое изображений и генерировать соответствующие описания, поддержка визуальных вопросов-ответов, аннотирования изображений и других задач.
Мультимодальная генерация: помимо генерации изображений, модель может описывать созданные изображения, распознавать текст и информацию о достопримечательностях, обеспечивая более богатый интерактивный опыт.
Технические особенности Janus-Pro
Авторегрессионная архитектура: использует разделённые пути визуального кодирования, разделяя задачи «понимания» и «генерации», что устраняет конфликт визуального кодировщика в обеих задачах, характерный для традиционных моделей.
Эффективное обучение: предобучение на 72 миллионах высококачественных синтетических изображений повышает генеративные способности и стабильность модели.
Унифицированная архитектура: построена на архитектуре Transformer, объединяет задачи мультимодального понимания и генерации, что упрощает конструкцию модели и повышает её гибкость.
Поддержка локального запуска: версия Janus-Pro с 7 млрд параметров может работать на потребительских GPU, что снижает требования к оборудованию.
Производительность Janus-Pro
Превосходство над DALL-E 3 и Stable Diffusion: в тестах GenEval и DPG-Bench Janus-Pro демонстрирует более высокую точность и качество изображений по сравнению с DALL-E 3 и Stable Diffusion.
Понимание сложных сцен: выделяется в задачах выравнивания текста и изображения, а также точного воспроизведения деталей в сложных сценах.
Эффективный вывод: поддерживает работу на одной видеокарте, обладает высокой скоростью вывода и подходит как для корпоративных, так и для индивидуальных пользователей.
Сценарии применения Janus-Pro
Генерация изображений: демонстрирует отличные результаты в задачах генерации изображений.
Текст-в-изображение: повышает стабильность генерации изображений по тексту.
Креативный дизайн: помогает дизайнерам быстро создавать высококачественные графические материалы, повышая эффективность творческого процесса.
Образование и исследования: используется для создания учебных материалов или для анализа изображений в научных исследованиях.
Коммерческое применение: поддерживает задачи рекламного дизайна, презентации продуктов и другие сценарии, удовлетворяя потребности бизнеса в высококачественных изображениях.
Мультимодальное взаимодействие: применяется в интеллектуальных ассистентах, виртуальной реальности и других сценариях, требующих понимания и генерации изображений.
Архитектура Janus-Pro основана на моделях DeepSeek-LLM-1.5b-base и DeepSeek-LLM-7b-base и поддерживает задачи мультимодального понимания и генерации. В качестве визуального кодировщика используется SigLIP-L, способный обрабатывать изображения размером 384 x 384 пикселей. Для задач генерации изображений применяется специализированный токенизатор с определённым коэффициентом субдискретизации. Гибкость и эффективность данной архитектуры обеспечивают Janus-Pro выдающиеся результаты в мультимодальных задачах, превосходя традиционные унифицированные модели и показывая отличные показатели в сравнении со специализированными моделями для конкретных задач.
Janus-Pro распространяется по лицензии MIT, что позволяет пользователям бесплатно загружать и использовать модель без ограничений на коммерческое использование. DeepSeek также предоставляет подробное руководство по развёртыванию, позволяющее быстро запустить модель в локальной среде.
Доклад: https://github.com/deepseek-ai/Janus/blob/main/janus_pro_tech_report.pdf
Репозиторий на Github: https://github.com/deepseek-ai/Janus
Онлайн-демонстрация: https://huggingface.co/deepseek-ai/Janus-Pro-7B
Связанные материалы:
Как развернуть DeepSeek Janus Pro локально?
В чём различия и общие черты Janus-Pro и JanusFlow?
DeepSeek поздней ночью выпустила новые мультимодальные модели ИИ: Janus-Pro и JanusFlow















