Помощник сценариста▸
 AI Приложения
 AI Новости
Firecrawl Extract: извлекайте веб-данные одним текстовым запросом
Firecrawl Extract: извлекайте веб-данные одним текстовым запросомОписание
Firecrawl Extract сочетает в себе мощь больших языковых моделей (LLM), позволяя интеллектуально извлекать данные из веб-страниц и преобразовывать их в форматы, подходящие для дальнейшей обработки, такие как Markdown или структурированные данные JSON. Это особенно полезно в сценариях, где требуются обширные веб-данные для обучения моделей ai или проведения анализа данных.
Основные особенности Firecrawl Extract:
Интеллектуальное извлечение: определяя схему извлечения данных или используя JSON Schema, пользователи могут указать необходимую структуру данных, и Firecrawl Extract автоматически выполнит сбор и разбор данных в соответствии с этими указаниями.
Без необходимости кодирования: пользователи могут выполнять извлечение данных с помощью простых вызовов API или настройки через графический интерфейс, без написания сложного кода для парсинга.
Обработка динамического контента: даже если сайт использует JavaScript для динамической загрузки контента, Firecrawl способен захватить эти данные, обеспечивая их полноту.
Массовый сбор: поддерживается одновременный сбор данных с нескольких URL, что подходит для проектов, требующих больших объёмов данных.
Интеграция с API и SDK: предоставляются Python SDK, Node SDK и другие инструменты, что позволяет разработчикам легко интегрировать функциональность Firecrawl Extract в свои приложения.
Поддержка LLM: использование LLM для понимания контекста веб-страниц позволяет более точно определять и извлекать ключевую информацию из неструктурированных данных.
Простота использования: процесс извлечения данных можно запустить с помощью простой команды или вызова, как показано в примере вызова API.
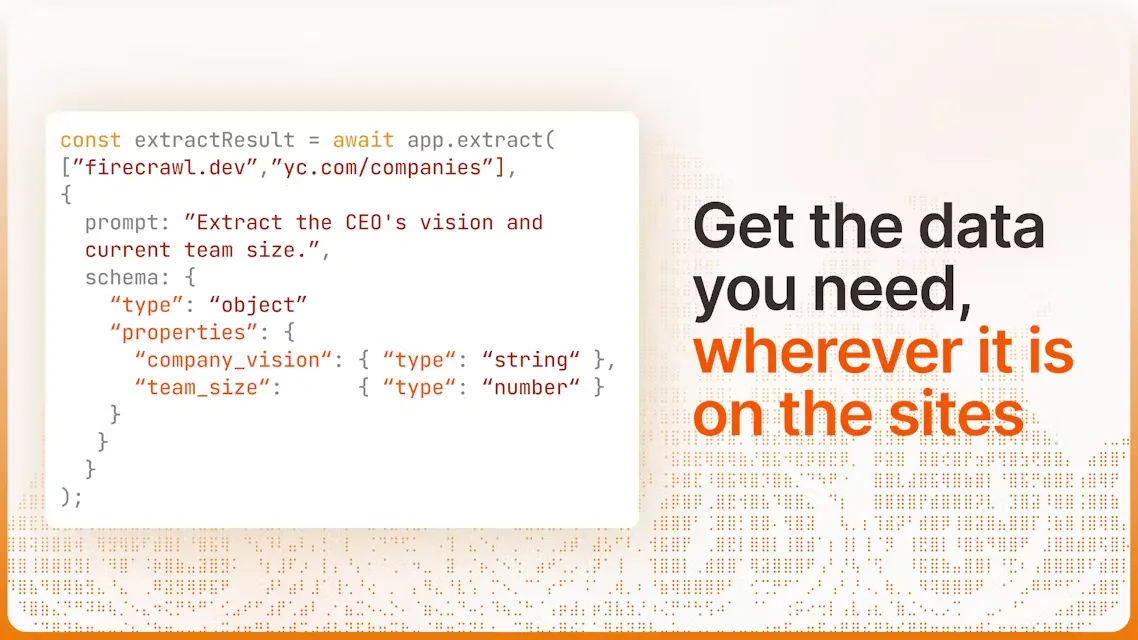
Шаги по использованию Firecrawl Extract:
1. Определите требования к данным: чётко определите, какие данные вы хотите извлечь с веб-страницы, и подготовьте соответствующую схему данных или используйте предопределённые шаблоны.
2. Вызов API или интеграция SDK:
При использовании API сформируйте запрос, указав целевой URL и схему извлечения данных.
При использовании Python SDK инициализируйте объект FirecrawlApp и вызовите соответствующий метод извлечения, передав URL и инструкции по извлечению.
Пример кода (Python SDK):
from firecrawl.firecrawl import FirecrawlApp
app = FirecrawlApp(api_key="YOUR_API_KEY")
result = app.extract([ 'адрес вашего сайта URL'], {
prompt: "извлечь конкретные данные",
schema: { /* определите структуру ваших данных */ }
})
3. Получение результатов: после завершения извлечения Firecrawl вернёт обработанные данные, которые можно сразу использовать для последующего анализа или обучения модели.
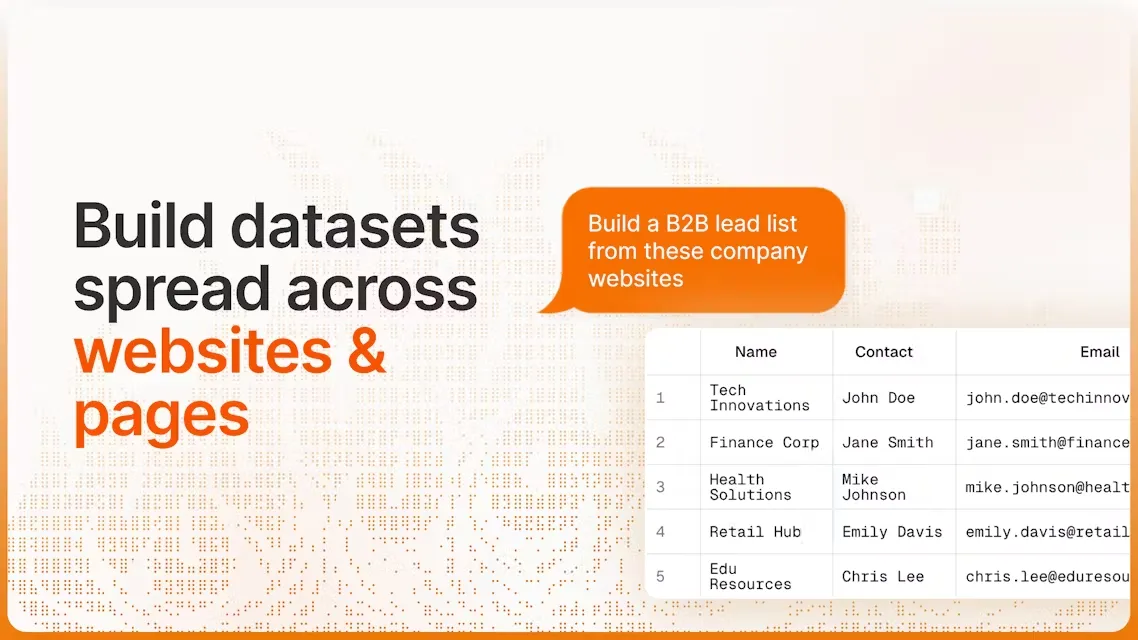
Сценарии применения Firecrawl Extract:
Firecrawl подходит для различных сценариев применения, таких как обогащение информации о потенциальных клиентах, автоматизация KYB и рабочие процессы без кода. Сервисы, предоставляемые Firecrawl, делают преобразование данных веб-сайтов в форматы, подходящие для использования с большими языковыми моделями (LLM), простым и эффективным:
Обучение AI-моделей: предоставление обширных обучающих данных для больших языковых моделей.
Агрегация контента: быстрое создание кратких обзоров контента или новостных агрегаторов.
Анализ рынка: извлечение информации о ценах или продуктах с сайтов конкурентов.
Исследование данных: сбор общедоступных данных из сети для академических или коммерческих исследований.
Эндпоинт /extract от Firecrawl — это мощный инструмент, способный извлекать структурированные данные с любого веб-сайта. Пользователи могут получить нужные данные с помощью простого вызова API, без необходимости ручного сбора. Благодаря функции Extract от Firecrawl пользователи могут легко справляться с типичными задачами веб-парсинга, такими как скрытые прокси, ограничения скорости и другие, обеспечивая бесперебойное извлечение данных.