
 Помощник сценариста▸
 AI Приложения
 AI Новости

ExtractPDF: извлечение изображений, текста и шрифтов из PDF-файлов
ExtractPDF: извлечение изображений, текста и шрифтов из PDF-файловОписание
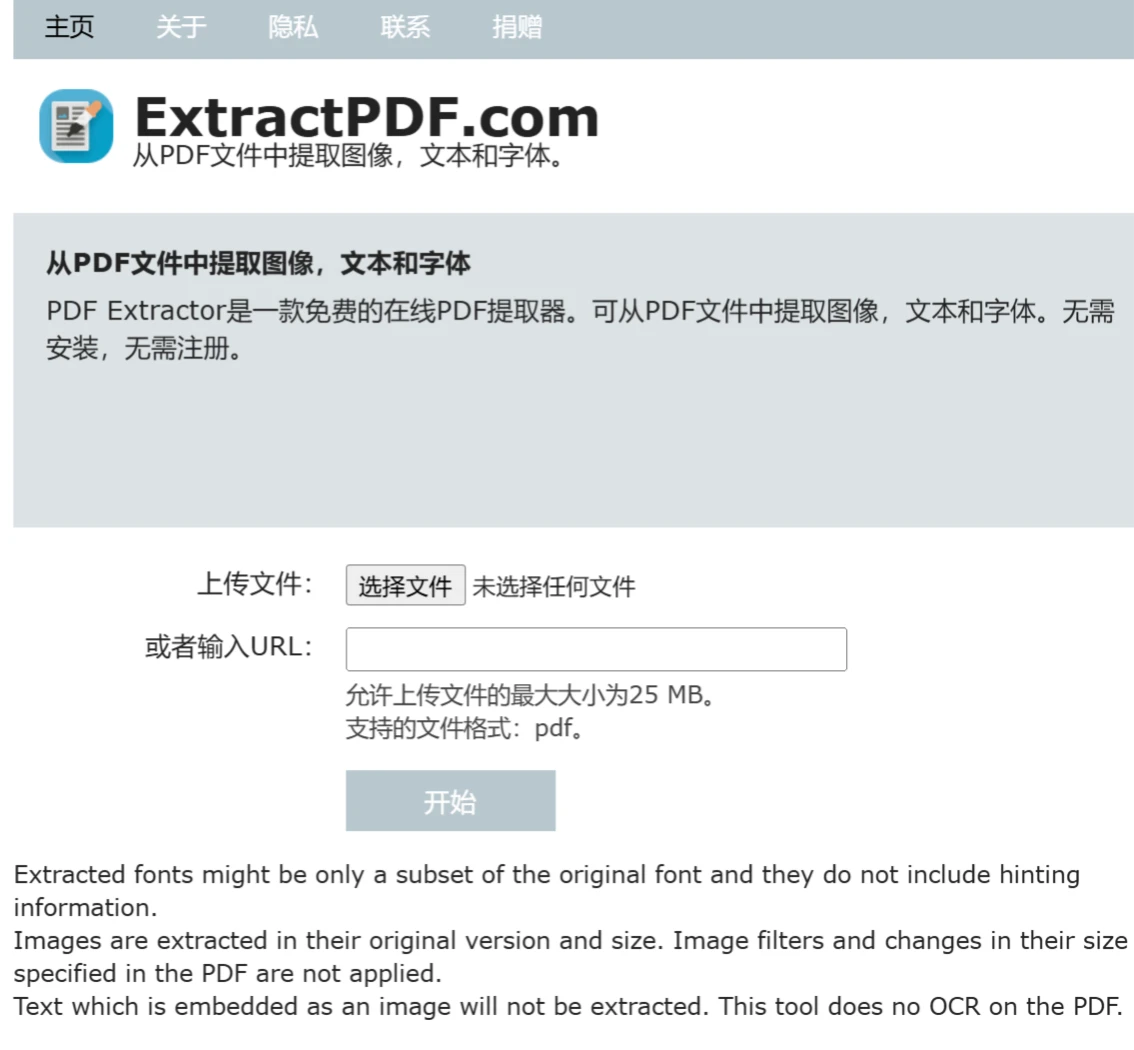
ExtractPDF — это онлайн-инструмент, специально предназначенный для извлечения текста и изображений из PDF-файлов. Нет необходимости загружать какое-либо программное обеспечение или плагины — пользователи могут пользоваться его функциями прямо в браузере. Сайт предлагает простой и удобный интерфейс, позволяющий быстро и эффективно извлекать нужную информацию.
Функции ExtractPDF:
Извлечение текста: извлечение простого текстового содержимого из PDF-файлов.
Извлечение изображений: извлечение изображений из PDF-файлов, при этом пользователи могут сохранять как отдельные, так и несколько изображений.
Поддержка языков: ExtractPDF поддерживает распознавание текста на многих языках, включая английский, китайский, японский и другие.
Использование ExtractPDF:
Использовать очень просто — достаточно загрузить PDF-файл или ввести URL-адрес PDF и отправить запрос.
Перейдите на сайт: откройте браузер и зайдите на официальный сайт ExtractPDF.
Загрузите PDF-файл: загрузите PDF-файл или введите его URL-адрес (ExtractPDF позволяет загружать файлы размером до 25 МБ, поддерживаемый формат файлов — pdf).
Начните извлечение: нажмите кнопку «Начать», и ExtractPDF приступит к обработке файла и извлечению нужного содержимого.
Скачайте результат: после завершения извлечения пользователи могут сразу скачать извлечённые текст и изображения.
Преимущества ExtractPDF:
Не требует установки: пользователям не нужно загружать какое-либо программное обеспечение — достаточно браузера.
Многоязычная поддержка: ExtractPDF поддерживает множество языков, включая китайский.
Примечания:
Извлечённый шрифт может быть лишь подмножеством исходного шрифта и не содержит хинтинговой информации.
Изображения извлекаются в их исходном виде и размере. Фильтры изображений, заданные в PDF, а также изменения размеров не применяются.
Текст, встроенный в виде изображений, не будет извлечён. Данный инструмент не выполняет OCR для PDF.
Часто задаваемые вопросы по ExtractPDF:
1. Почему извлечённые изображения выглядят не так, как в PDF-файле?
Этот инструмент извлекает исходные изображения из PDF-файла. Любые операции с изображениями, выполненные в PDF, такие как обрезка, поворот, инверсия цветов и т. д., будут проигнорированы.
2. Почему в извлечённом из PDF-файла шрифте отсутствуют некоторые глифы?
Когда шрифт встраивается в PDF-файл, PDF содержит только глифы всех встречающихся символов. Если в вашем PDF-файле нет буквы «P», то извлечённый файл шрифта также не будет содержать букву «P».
3. Почему использование извлечённого из PDF шрифта приводит к странному отображению вёрстки?
PDF-файлы обычно не содержат файлов метрик шрифта (файлов .pfm или .afm), поскольку PDF-ридерам эта информация не требуется. Отсутствие файлов метрик приведёт к тому, что извлечённый шрифт невозможно будет нормально использовать.
2. Законно ли извлекать шрифты из PDF?
Извлечение шрифтов из PDF является законным. Однако если вы хотите использовать извлечённые шрифты, вам необходимо получить разрешение от автора шрифта.
Тем не менее, из-за отсутствия метрик шрифта извлечённые шрифты, как правило, не могут быть использованы напрямую. Они в основном служат для помощи в определении шрифтов, использованных в PDF-файле.
Если вы всё же решите использовать шрифты, извлечённые из PDF-файла, вам следует знать о юридических рисках, связанных с их использованием.













