
 Помощник сценариста▸
 AI Приложения
 AI Новости
CosyVoice: естественный голос, как у живого человека
CosyVoice: естественный голос, как у живого человекаОписание
CosyVoice — это речевая генеративная модель большого размера, основанная на квантованном кодировании речи. Это новая технология синтеза речи, которая обеспечивает глубокую интеграцию понимания текста и генерации речи. Она выполняет дискретизацию речи и благодаря технологиям больших моделей позволяет получать естественное и плавное звучание. По сравнению с традиционными технологиями генерации речи, CosyVoice способна точно анализировать и интерпретировать различное текстовое содержание, преобразовывая его в естественную речь, почти неотличимую от человеческой.
Достаточно предоставить всего 3–10 секунд исходного аудио, и CosyVoice сможет сгенерировать имитацию голоса, включая такие детали, как просодия и эмоции, а также обеспечить межъязыковую генерацию речи.
Официальный сайт проекта CosyVoice:https://www.modelscope.cn/studios/iic/CosyVoice-300M
Адрес исходного кода CosyVoice:https://github.com/FunAudioLLM/CosyVoice
Адрес API CosyVoice:https://help.aliyun.com/zh/model-studio/developer-reference/cosvoice-large-model-for-speech-synthesis/?spm=a2c4g.11186623.0.0.56f01751Ke29mh
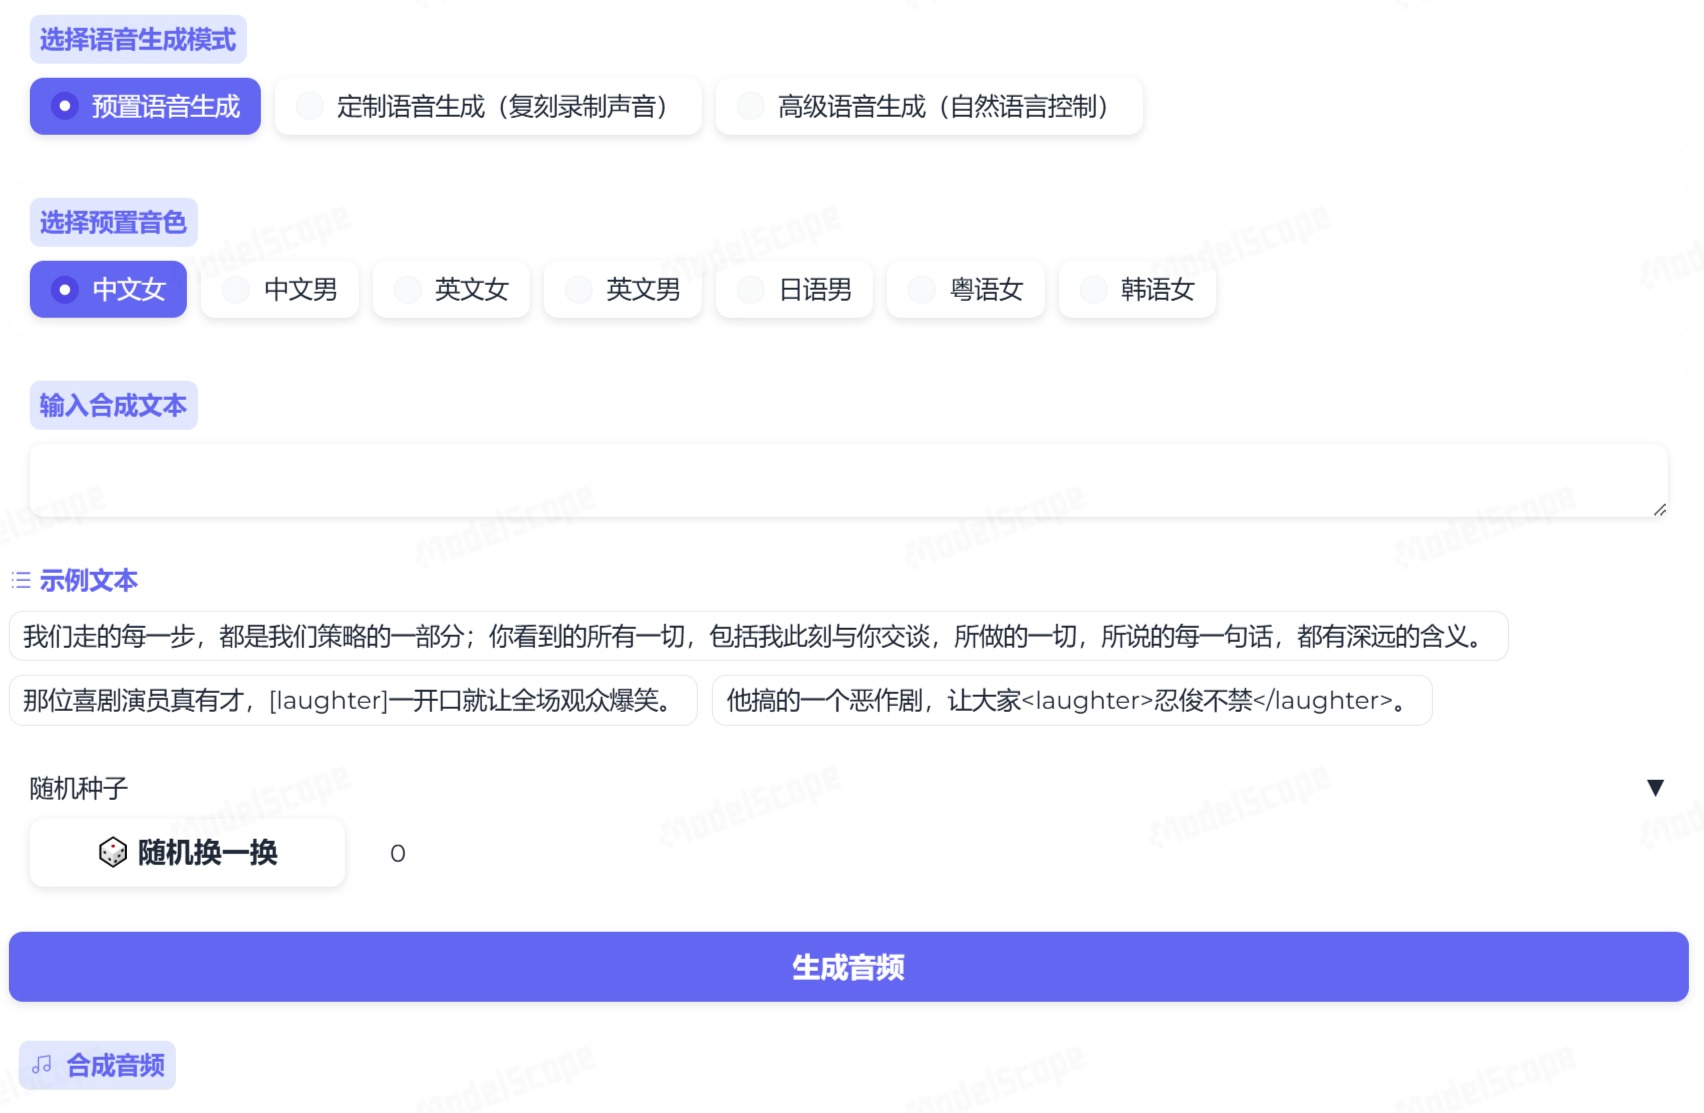
Функциональные особенности CosyVoice:
Высокая степень человекоподобия: использует разработанный речевой лабораторией Alibaba Tongyi генеративный нейросетевой алгоритм большой модели CosyVoice, благодаря которому генерируемая речь достигает сверхчеловеческого уровня по интонации, просодии и эмоциональной выразительности.
Многоязычность: CosyVoice поддерживает генерацию на 5 языках — китайском, английском, японском, кантонском и корейском. Сфокусирована на естественной генерации речи, поддерживает управление несколькими языками, тембрами и эмоциями, значительно превосходя по качеству традиционные модели генерации речи.
Разнообразный выбор голосов: предоставляет огромную библиотеку качественных голосов, включая различные пол, возраст, диалекты и множество уникальных голосов, удовлетворяя индивидуальные потребности пользователей в самых разных сценариях. Будь то серьёзный тон новостной передачи или эмоционально насыщенное повествование — всё легко реализуется.
Быстрый синтез в реальном времени: система обладает отличной скоростью отклика и возможностями потокового синтеза речи, обеспечивая быстрый и точный синтез в реальном времени как для длинных документов, так и для коротких команд.
Управление эмоциями и просодией: CosyVoice поддерживает генерацию человекоподобной речи с богатыми речевыми событиями и множеством эмоций, например, смех, междометия, а также генерацию человекоподобной речи с различными эмоциональными оттенками.
Клонирование голоса: достаточно предоставить 3–10 секунд исходного аудио, и CosyVoice сможет клонировать и сгенерировать имитацию голоса, включая такие детали, как просодия и эмоции, а также обеспечить межъязыковую генерацию речи.
Применение CosyVoice:
CosyVoice подходит для множества сценариев применения, таких как интеллектуальная поддержка клиентов, аудиокниги, автомобильная навигация, образовательное репетиторство и т. д.
Голосовой контент для интеллектуальных устройств/роботов, например, роботы-ассистенты клиентской поддержки, умные колонки, цифровые аватары, голосовые помощники и т. д.
Сценарии в создании аудио- и видеоконтента, где требуется преобразование текста в речь, такие как чтение романов, новостные передачи, комментирование фильмов, озвучивание сценариев и т. д.
CosyVoice значительно расширяет возможности голосового взаимодействия, повышает удобство работы пользователей и одновременно обеспечивает мощную поддержку интеллектуальной трансформации предприятий.
По сравнению с недавно ставшей популярной моделью ChatTTS, можно заметить, что синтезированное аудио у CosyVoice отличается более высокой согласованностью с содержанием. CosyVoice обеспечивает тонкое управление эмоциями и просодией генерируемой речи, что заметно повышает её эмоциональную выразительность, при этом практически отсутствуют артефакты в виде лишних слов (галлюцинации). CosyVoice хорошо моделирует семантическую информацию синтезируемого текста, превосходя человека по согласованности содержания и сходству голоса диктора.














