
 Помощник сценариста▸
 AI Приложения
 AI Новости
ToucanTTS: масштабная многоязычная модель, охватывающая более 7 000 языков
ToucanTTS: масштабная многоязычная модель, охватывающая более 7 000 языковОписание
ToucanTTS — это набор инструментов для самой современной синтеза речи, разработанный Институтом обработки естественного языка (IMS) Штутгартского университета. Это сверхполная модель преобразования текста в речь (Text-to-Speech, TTS). ToucanTTS охватывает более 7 000 языков в своей масштабной многоязычной модели.
ToucanTTS не только поддерживает несколько языков, но и обладает функцией многоголосого синтеза речи, позволяющей имитировать ритм, акцент и интонацию разных говорящих.
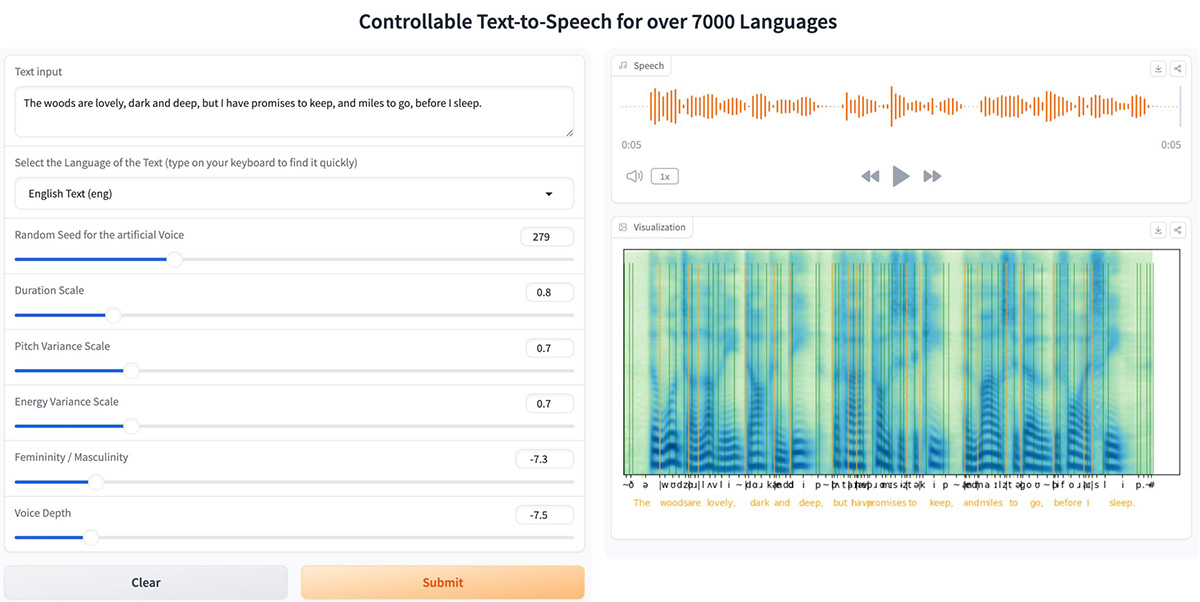
Кроме того, он предоставляет интерактивные демонстрации для множества приложений, включая создание голоса, клонирование стиля, многоязычный синтез речи и редактируемое вручную чтение стихов, демонстрируя свою многофункциональность и высокую производительность.
Функции ToucanTTS:
Многоязычная поддержка: ToucanTTS способен синтезировать речь на более чем 7 000 языках, что делает его TTS-моделью с самой широкой языковой поддержкой. Такая обширная языковая поддержка удовлетворяет потребности широкой международной аудитории.
Многоголосый синтез речи: ToucanTTS поддерживает синтез речи множества говорящих, позволяя пользователям имитировать ритм, акцент и интонацию разных людей. Это особенно полезно для приложений, требующих разнообразия стилей и настройки голоса.
Человеко-машинное интерактивное редактирование: ToucanTTS позволяет пользователям настраивать синтезированную речь в соответствии с конкретными требованиями, что особенно полезно для литературных исследований и задач чтения стихов.
Архитектура: ToucanTTS построен на архитектуре FastSpeech 2 и улучшен под влиянием PortaSpeech. Он включает PostNet на основе нормализующих потоков и отдельный выравниватель, обученный с помощью связной временной классификации (CTC) и восстановления спектрограммы, что обеспечивает высококачественный, естественно звучащий синтез речи.
Артикуляционное представление: уникальной особенностью ToucanTTS является использование артикуляционного представления фонем в качестве входных данных. Использование многоязычных данных позволяет повысить качество и доступность синтеза речи для языков с ограниченными ресурсами.
Интерактивные демонстрации: ToucanTTS предоставляет интерактивные демонстрации для различных приложений, таких как создание голоса, клонирование стиля, многоязычный синтез речи и редактируемое вручную чтение стихов. Эти демонстрации показывают многофункциональность и надёжность инструментария.
Обучение и инференс: инструментарий содержит подробные инструкции по установке зависимостей, настройке хранилища, загрузке предобученных моделей и запуску конвейера обучения. Поддерживается дообучение с предобученных моделей и обучение с нуля.
Особенности ToucanTTS:
Многоязычная и многоголосая поддержка: благодаря масштабной многоязычной предобученной модели поддерживается многоязычный синтез речи, охватывающий более 7 000 языков. Реализован многоголосый синтез речи с клонированием просодии, такой как ритм, акцент и интонация, между говорящими.
Человеко-машинное совместное редактирование: допускает человеко-машинное совместное редактирование синтезированной речи, например для чтения стихов и литературоведческих исследований.
Интерактивные демонстрации: предоставляет интерактивные демонстрации масштабного многоязычного синтеза речи, межговорящего клонирования стиля, создания голоса и редактируемого вручную чтения стихов.
Архитектура и компоненты: в основном основана на архитектуре FastSpeech 2 с некоторыми модификациями, например, PostNet на основе нормализующих потоков, вдохновлённый PortaSpeech. Включает самостоятельный выравниватель, обученный с помощью CTC, и восстановление спектрограмм для различных приложений. Предоставляются предобученные модели для многоязычной модели, выравнивателя, функции встраивания, вокодера и встраивающего GAN.
Простота использования: полностью построен на Python и PyTorch, ориентирован на простоту и доступность для начинающих, оставаясь при этом мощным.
Артикуляционное представление: система IMS Toucan принимает на вход артикуляционное представление фонем, что позволяет использовать многоязычные данные в интересах языков с ограниченными ресурсами.
Применения ToucanTTS:
Синтез речи для многоязычных приложений: ToucanTTS поддерживает более 7 000 языков, что делает его чрезвычайно полезным для создания многоязычных приложений, таких как глобальные платформы клиентского обслуживания, образовательные инструменты и средства доступности для неносителей языка.
Создание и настройка голоса: функция многоголосого синтеза речи позволяет создавать индивидуальные голоса, которые можно использовать в различных приложениях, таких как виртуальные ассистенты, аудиокниги и персонализированные маркетинговые сообщения.
Человеко-машинное интерактивное редактирование: эта функция особенно полезна в литературоведческих исследованиях и задачах чтения стихов, где требуется точный контроль над голосовым выводом для удовлетворения специфических стилистических требований.
Как использовать ToucanTTS?
Начать работу с ToucanTTS можно всего за несколько простых шагов.
1. Скачайте с GitHub
Загрузите код с GitHub. git clone https://github.com/2noise/ToucanTTS скачивает ToucanTTS
2. Установите зависимости
Перед началом убедитесь, что необходимые пакеты установлены. Вам понадобятся torch и ToucanTTS. Если они ещё не установлены, вы можете установить их с помощью pip:
3. Импортируйте необходимые библиотеки
Импортируйте в ваш скрипт необходимые библиотеки. Вам понадобятся torch, ToucanTTS и Audio из IPython.display.
4. Инициализируйте ToucanTTS, создайте экземпляр класса ToucanTTS и загрузите предобученную модель.
5. Подготовьте текст, определив текст для преобразования в речь. Замените <YOUR TEXT HERE> на нужный вам текст.
6. Сгенерируйте речь, используя метод infer для генерации речи из текста. Установите use_decoder=True, чтобы включить декодер.
7. Воспроизведите аудио
Используйте класс Audio из IPython.display для воспроизведения сгенерированного аудио. Установите частоту дискретизации 24 000 Гц и включите автовоспроизведение.
8. Завершите скрипт
Ссылка на GitHub ToucanTTS: https://github.com/DigitalPhonetics/IMS-Toucan
Ссылка на онлайн-демонстрацию: https://huggingface.co/spaces/Flux9665/MassivelyMultilingualTTS
Ссылка на набор данных: https://huggingface.co/datasets/Flux9665/BibleMMS














