
 Помощник сценариста▸
 AI Приложения
 AI Новости

VASA-1: преобразование фото в видео
VASA-1: преобразование фото в видеоОписание
Одно портретное фото + голосовое аудио = видео в реальном времени с гиперреалистичным говорящим лицом, с точной синхронизацией губ, реалистичной мимикой и естественными движениями головы. VASA-1 — это передовая технология искусственного интеллекта, разработанная Microsoft Research Asia, которая способна преобразовывать одно статичное изображение и фрагмент голосового аудио в реалистичную анимацию говорящего лица. Эта технология обеспечивает точную синхронизацию аудио с движениями губ и улавливает множество тонких выражений лица и естественных движений головы, создавая видео с богатой мимикой и динамичными выражениями лица.
VASA-1 способна объединять одно статичное изображение с аудиофайлом для генерации видео с динамичными выражениями лица и движениями головы, благодаря чему человек на изображении словно «оживает». Эта технология может использовать как портретные изображения, сгенерированные ИИ, так и реальные фотографии, например, изображение президента США, и заставлять их двигаться и говорить.
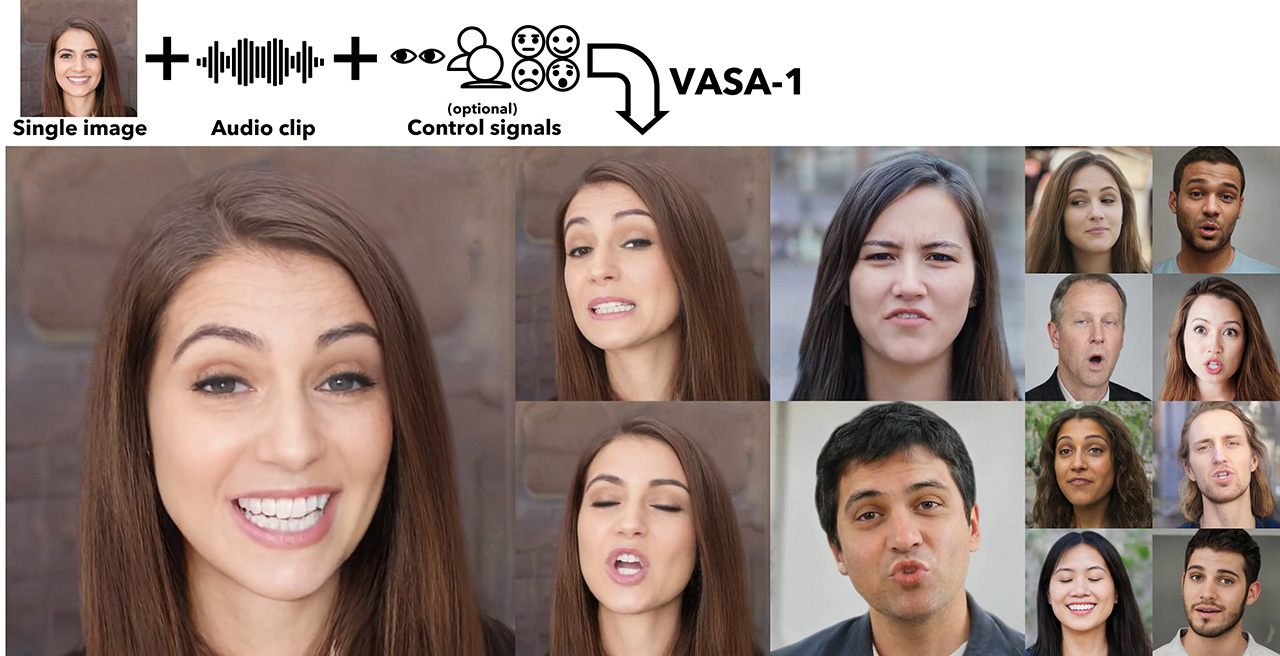
Основные функции и особенности VASA-1:
Реалистичная синхронизация губ: VASA-1 способна генерировать движения губ, точно синхронизированные с входным голосовым аудио, обеспечивая высокореалистичный эффект говорящего человека.
Способность к разделению характеристик: VASA-1 обладает возможностью независимого управления такими чертами лица, как движения губ, выражения, направление взгляда и другие динамические характеристики.
Безопасность и мониторинг: технология VASA-1 также может применяться в области безопасности и мониторинга.
Построение латентного пространства лица: создание латентного пространства лица для генерации динамичных выражений лица и движений головы.
Высокое качество генерации изображений и высокая скорость работы: VASA-1 обеспечивает реалистичное говорящее лицо в реальном времени с высоким качеством генерации изображений и высокой скоростью работы.
Разметка черт лица с помощью 3D-технологий: Microsoft также использует 3D-технологии для辅助-разметки черт лица и разработала дополнительные функции потерь, что позволяет VASA-1 не только генерировать высококачественное видео лица, но и эффективно фиксировать и воспроизводить 3D-структуру лица.
Технология VASA-1 благодаря своей передовой архитектуре глубокого обучения и применению множества самых современных технологий обеспечивает высокореалистичную анимацию говорящего лица на основе аудио, включая, помимо прочего, синхронизацию губ, богатую мимику, способность к разделению характеристик, применение в области безопасности и мониторинга, высокое качество изображений и высокую скорость работы, а также эффективный захват и воспроизведение 3D-структуры лица.
VASA-1 — это инновационный инструмент ИИ, который объединяет статичное изображение или рисунок с аудиофайлом для создания в конечном итоге реалистичного видео. Этот процесс практически не оставляет следов вмешательства человека, благодаря чему сгенерированное видео выглядит очень естественно. Несмотря на то, что исследователи признают, что, как и все другие модели, VASA-1 в настоящее время не может надлежащим образом обрабатывать нежёсткие элементы, такие как волосы, её общий эффект значительно превосходит другие аналогичные модели.
Мощные возможности VASA-1 также несут в себе потенциальные риски, особенно в связи с тем, что её можно использовать для создания дипфейк-видео, которые могут реалистично имитировать реальных людей, затрудняя различение подлинного и поддельного. Перед выпуском VASA-1 Microsoft Research Asia заняла осторожную позицию: они не публиковали никаких онлайн-демонстраций, API, продуктов или связанных деталей реализации, чтобы гарантировать, что технология не будет использована не по назначению, и активно исследуют способы предотвращения неправомерного использования VASA-1 злоумышленниками.












