
 Помощник сценариста▸
 AI Приложения
 AI Новости
DiffusionGPT: система генерации изображений из текста на базе LLM
DiffusionGPT: система генерации изображений из текста на базе LLMОписание
DiffusionGPT — разработанная ByteDance универсальная система генерации изображений по тексту, управляемая большой языковой моделью (LLM), специально спроектированная для создания высококачественных изображений по различным входным запросам. Её основная цель — анализировать входной запрос и определять генеративную модель, которая обеспечивает оптимальный результат, отличаясь высокой обобщающей способностью, эффективностью и удобством использования.
Главная фишка DiffusionGPT заключается в том, что она объединяет множество экспертных моделей генерации изображений из различных областей. Затем LLM используется для взаимодействия с этими моделями, позволяя ей обрабатывать и понимать различные текстовые запросы. Наконец, на основе понятой информации выбирается наиболее подходящая модель изображений для генерации. Таким образом, как и в GPT-4, рисование осуществляется через чат...
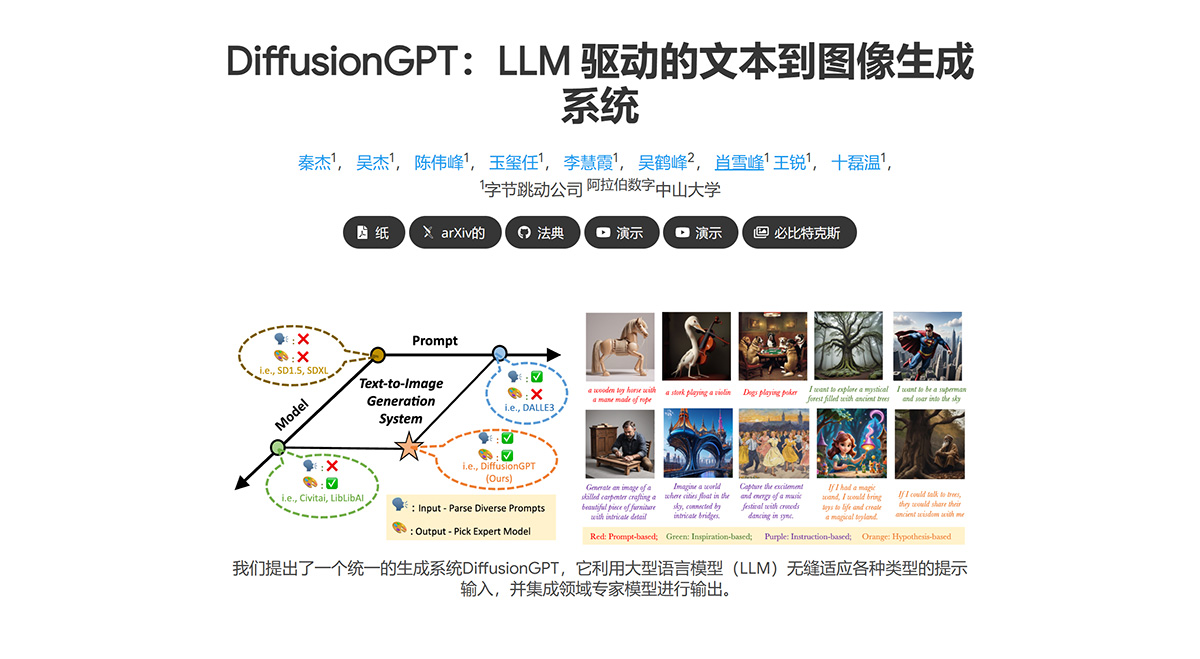
Основные особенности DiffusionGPT:
1. Разнообразная обработка текстовых запросов: DiffusionGPT способна понимать и обрабатывать различные типы текстовых запросов, включая конкретные инструкции, абстрактные идеи, сложные предположения и т. д.
2. Интеграция множества экспертных моделей из разных областей: система объединяет различные модели диффузии изображений из множества областей, каждая из которых обладает профессиональными возможностями генерации изображений в своей конкретной области. Такие модели специализируются на создании изображений в конкретных доменах, таких как природные пейзажи, портреты людей, художественные произведения и т. д.
Это означает, что система способна не только генерировать обычные изображения, но и справляться с более специфическими и сложными задачами генерации, такими как изображения в определённом стиле или определённого типа — имитация стиля конкретного художника, стиль комиксов или фотографические техники.
3. Управление большой языковой моделью: DiffusionGPT использует большую языковую модель (LLM) для анализа и понимания текстовых запросов пользователя. Этот процесс аналогичен тому, как другие системы на базе LLM (например, GPT-4) обрабатывают текст, но особенно ориентирован на понимание инструкций и описаний, предназначенных для генерации изображений.
4. Интеллектуальный выбор подходящей модели изображений: на основе понимания текстового запроса DiffusionGPT способна интеллектуально выбирать наиболее подходящую модель генерации изображений. Это включает не только выбор правильной модели, но и настройку параметров генерации для наилучшего удовлетворения потребностей пользователя.
5. Высококачественные выходные изображения: благодаря точному сопоставлению текстового запроса с лучшей генеративной моделью DiffusionGPT способна создавать высококачественные изображения, в высокой степени соответствующие потребностям пользователя.
6. Обратная связь пользователей и база данных преимуществ: в сочетании с обратной связью пользователей и базой данных преимуществ система может корректировать выбор модели в соответствии с предпочтениями пользователя, повышая релевантность и качество генерации изображений.
Например, на ранних этапах использования системы пользователь может дать обратную связь о сгенерированном изображении, например: «Цвета на этой картинке слишком тёмные». DiffusionGPT использует эту обратную связь для корректировки выбора модели, чтобы будущие изображения лучше соответствовали предпочтениям пользователя.
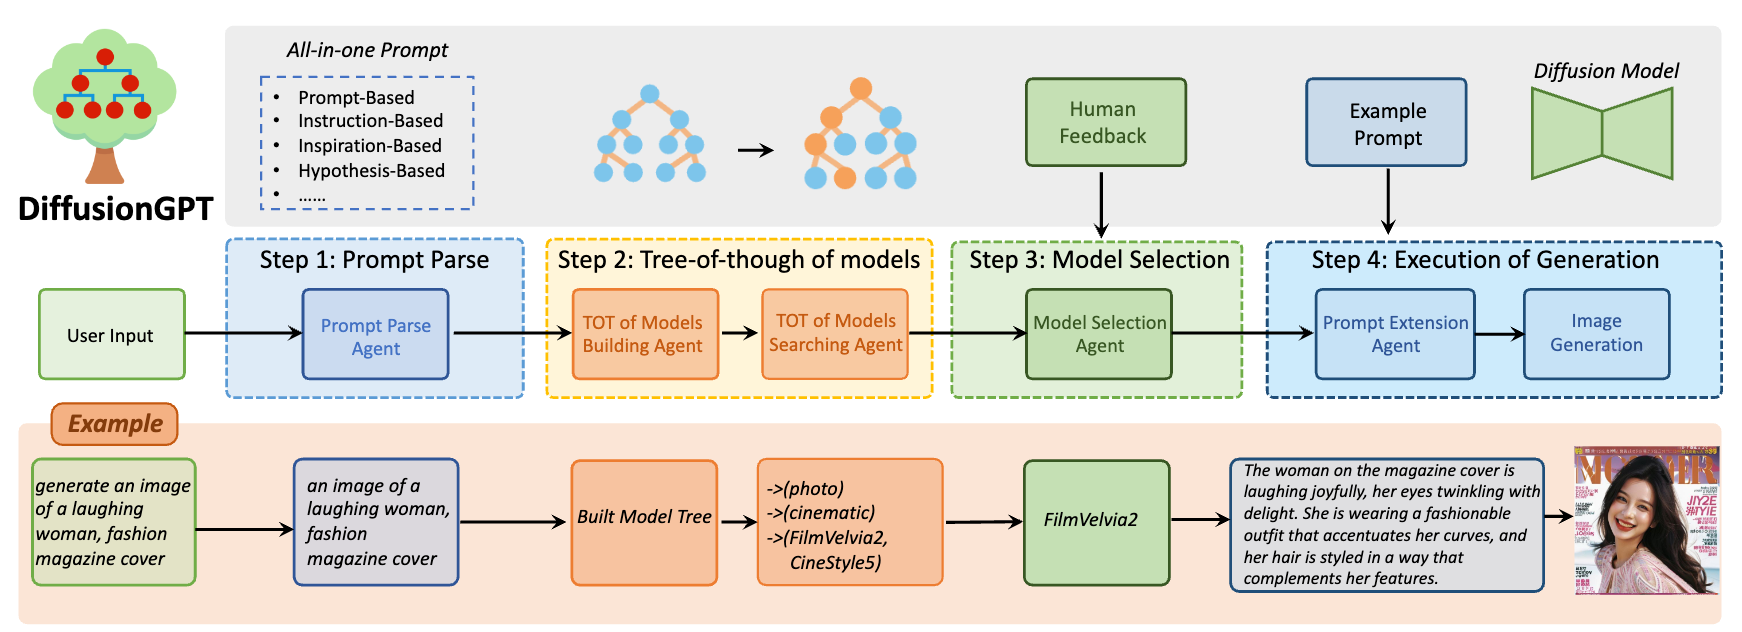
Основной принцип работы DiffusionGPT:
1. Анализ входных данных: пользователь предоставляет текстовый запрос — описание, инструкцию или идею.
Большая языковая модель (LLM) отвечает за анализ этих текстовых запросов, понимание их значения и требований.
2. Построение дерева мыслей (Tree-of-Thought): в зависимости от различных задач генерации изображений система строит «дерево мыслей» — структуру, организующую различные модели генерации изображений.
Дерево мыслей основано на априорных знаниях и обратной связи от людей и охватывает экспертные модели из множества областей.
3. Выбор модели: на основе результатов анализа LLM система через дерево мыслей определяет наиболее подходящую для текущего текстового запроса модель генерации изображений. В процессе выбора также могут учитываться предпочтения пользователя и историческая обратная связь — эта информация хранится в базе данных преимуществ.
4. Генерация изображений: как только подходящая модель выбрана, она используется для создания изображения. Сгенерированное изображение будет тесно связано с входным текстовым запросом и отражать намерения и предпочтения пользователя.
5. Вывод результатов: итоговое сгенерированное изображение предоставляется пользователю.
Эти изображения могут быть разнообразными, включая, помимо прочего, конкретные описанные сцены, концептуальные художественные работы или изображения в определённом стиле.
6. Процесс оптимизации на основе обратной связи пользователя:
Обратная связь пользователя о сгенерированных изображениях используется для обогащения базы данных преимуществ, что, в свою очередь, помогает системе лучше понимать предпочтения пользователя и оптимизировать последующий выбор модели и генерацию изображений.
DiffusionGPT демонстрирует высокую реалистичность и детализацию при генерации изображений таких категорий, как люди и сцены.По сравнению с базовыми моделями (такими как SD1.5) изображения, созданные DiffusionGPT, демонстрируют заметное улучшение визуальной достоверности и проработки деталей.DiffusionGPT превосходит традиционные модели стабильной диффузии по показателям reward-оценки изображений и эстетическим оценкам.При количественной оценке качества генерации изображений DiffusionGPT показывает высокие баллы, что свидетельствует о том, что её изображения более предпочтительны по качеству и эстетике.














