
 Помощник сценариста▸
 AI Приложения
 AI Новости
DreamTalk: открытый фреймворк для озвучивания фотографий людей
DreamTalk: открытый фреймворк для озвучивания фотографий людейОписание
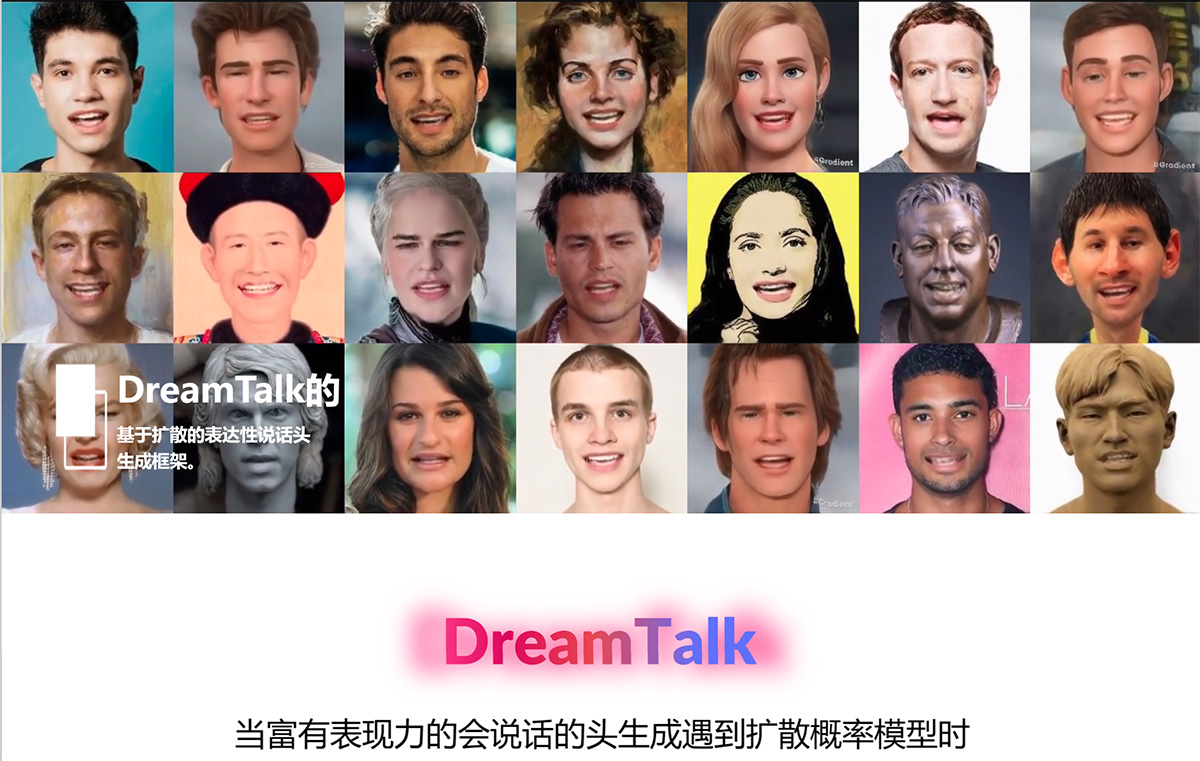
DreamTalk — это фреймворк, разработанный совместно Университетом Цинхуа, Alibaba и Хуачжунским университетом науки и технологий, основанный на диффузионной модели и позволяющий оживлять фотографии людей, заставляя их говорить. Он поддерживает различные звуки, включая песни, речь на разных языках и зашумлённое аудио, для синхронизации движений губ с аватарами.
Демо-адрес DreamTalk:https://dreamtalk-project.github.io
Адрес проекта DreamTalk:https://dreamtalk-project.github.io/
Адрес статьи DreamTalk:https://arxiv.org/abs/2312.09767
Сценарии использования DreamTalk:
Использование DreamTalk для генерации говорящих лиц с разнообразными языками и стилями выражений
Применение DreamTalk в кинопроизводстве для создания реалистичных выражений и движений виртуальных персонажей
Использование DreamTalk в сценариях взаимодействия человека и компьютера для достижения естественных выражений лица и движений губ
Функции DreamTalk:
В частности, DreamTalk состоит из трёх ключевых компонентов: сети шумоподавления, стилево-осведомлённого эксперта по губам и предиктора стилей. Основанная на диффузии сеть шумоподавления способна синтезировать высококачественные аудиоуправляемые движения лица с согласованностью между различными выражениями. Для повышения выразительности и точности движений губ мы вводим стилево-осведомлённого эксперта по губам, который управляет синхронизацией губ с учётом стиля речи. Чтобы устранить необходимость в референсных видео или тексте для выражений, используется дополнительный предиктор стилей на основе диффузии, который напрямую предсказывает целевые выражения из аудио.
1. Сеть шумоподавления: это один из ключевых компонентов, отвечающий за генерацию аудиоуправляемых движений лица. Сеть шумоподавления использует диффузионную модель для постепенного удаления шума, генерируя чёткие и высококачественные выражения лица. Этот процесс включает постепенное восстановление чётких движений лица из зашумлённых данных.
2. Стилево-осведомлённый эксперт по губам: этот компонент сосредоточен на повышении выразительности и точности движений губ. Он анализирует стиль речи, чтобы направлять синхронизацию губ, обеспечивая естественность анимации и её соответствие стилю говорящего.
3. Предиктор стилей: для устранения зависимости от референсных видео или текста с выражениями DreamTalk вводит предиктор стилей на основе диффузии. Этот предиктор может напрямую предсказывать целевые выражения из аудио, без необходимости в дополнительных референсных видео или тексте с выражениями.
4. Обработка аудио и видео: обработка аудиовхода, извлечение ключевых аудиопризнаков и использование этих признаков для управления анимацией лица. Одновременно он может обрабатывать видеовход для извлечения и имитации конкретных выражений и стилей.
5. Данные и обучение модели: для реализации этих функций DreamTalk требует больших объёмов данных для обучения своей модели, включая данные анимации лиц с различными выражениями и стилями речи. На этих данных модель учится точно генерировать движения лица, соответствующие входному аудио.
DreamTalk способен эффективно использовать мощные диффузионные модели для генерации выразительных лиц и снижения зависимости от дорогостоящих стилевых референсов. Экспериментальные результаты показывают, что DreamTalk может генерировать реалистичные говорящие лица с различными стилями речи и достигать точной синхронизации губ, превосходя существующие современные аналоги.
DreamTalk способен не только обрабатывать и генерировать те типы лиц и выражения, которые он видел во время обучения, но и эффективно обрабатывать и генерировать типы лиц и выражения из различных наборов данных, которые он ранее не видел.
Включая портреты людей разных рас, возрастов и полов, а также самые разнообразные выражения и эмоции.














