
 Помощник сценариста▸
 AI Приложения
 AI Новости
DreaMoving: фреймворк генерации видео с людьми на основе диффузионных моделей
DreaMoving: фреймворк генерации видео с людьми на основе диффузионных моделейОписание
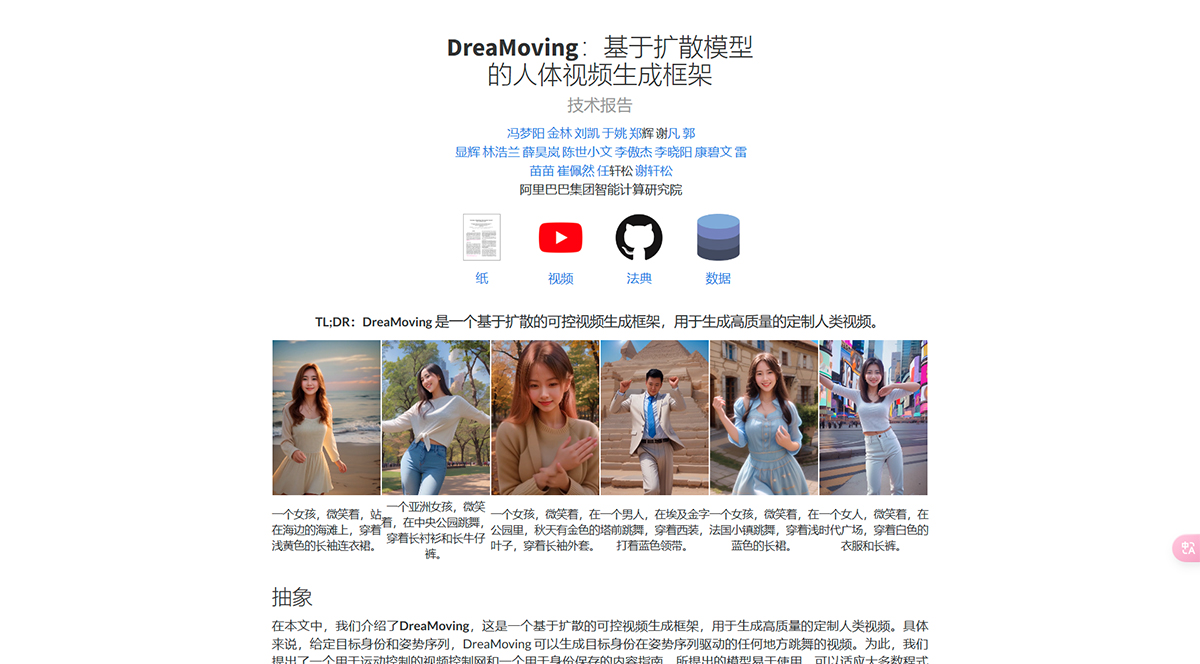
DreaMoving — это управляемый фреймворк генерации видео на основе диффузии, предназначенный для создания высококачественных персонализированных видео с танцами человека. В частности, учитывая целевую личность и последовательность поз, DreaMoving может генерировать видео, на котором целевая личность танцует где угодно под управлением последовательности поз. Для этого мы предлагаем сеть управления видео для управления движением и контентный навигатор для сохранения идентичности. Предложенная модель проста в использовании и может быть адаптирована к большинству стилизованных моделей диффузии для генерации различных результатов.
Адрес проекта DreaMoving:https://dreamoving.github.io/dreamoving
Обзор DreaMoving:
Video ControlNet — это ControlNet изображений, который внедряет блоки движения после каждого блока U-Net. Video ControlNet обрабатывает управляющую последовательность (позу или глубину) как дополнительные временны́е остаточные связи. Denoising U-Net — это производный U-Net Stable-Diffusion с блоками движения для генерации видео. Контентный навигатор передаёт входные текстовые подсказки и выражения внешности (например, лицо (одежда необязательно)) в контентные эмбеддинги для перекрёстного внимания.
Результаты:
DreaMoving способен генерировать высококачественные и высокодетализированные видео, получая на вход управляющую последовательность и простое описание контента, например, текст и референсное изображение. В частности, DreaMoving демонстрирует мастерство управления идентичностью за счёт использования референсного изображения лица, точного управления движением через последовательность поз, а также комплексного управления внешним видом видео, задаваемого указанными текстовыми подсказками.














