
 Помощник сценариста▸
 AI Приложения
 AI Новости

PixWeaver_云技派,专注ai人工智能!
PixWeaver_云技派,专注ai人工智能!Описание
PixWeaver — это платформа для создания изображений на основе искусственного интеллекта. Она позволяет пользователям создавать желаемые изображения с помощью голосовых или текстовых описаний, без необходимости изучать сложные программы для дизайна.
Пользователю достаточно ввести всего несколько фраз описания, и мощная модель AI в PixWeaver автоматически сгенерирует высококачественное изображение. Пользователи могут свободно воплощать любые творческие идеи, достигая полной свободы в создании изображений.
PixWeaver делает творчество простым и увлекательным, порог входа очень низкий — пользователю достаточно войти в систему, чтобы начать работу. Инструкция по использованию:
1. На странице создания пользователь может нажать «Создать» или выбрать пункт «рисование AI» в строке меню.
2. В поле описания изображения введите желаемый сюжет, также можно выбрать опцию «Случайное описание» для генерации.
3. В поле «Нежелательные элементы» пользователь может указать содержание, которое не должно присутствовать на изображении.
4. Нажмите «Создать».
PixWeaver работает очень быстро — в среднем генерация каждого изображения занимает всего 3 секунды, пользователю не приходится ждать. Кроме того, PixWeaver предоставляет функции обработки и ретуши изображений.
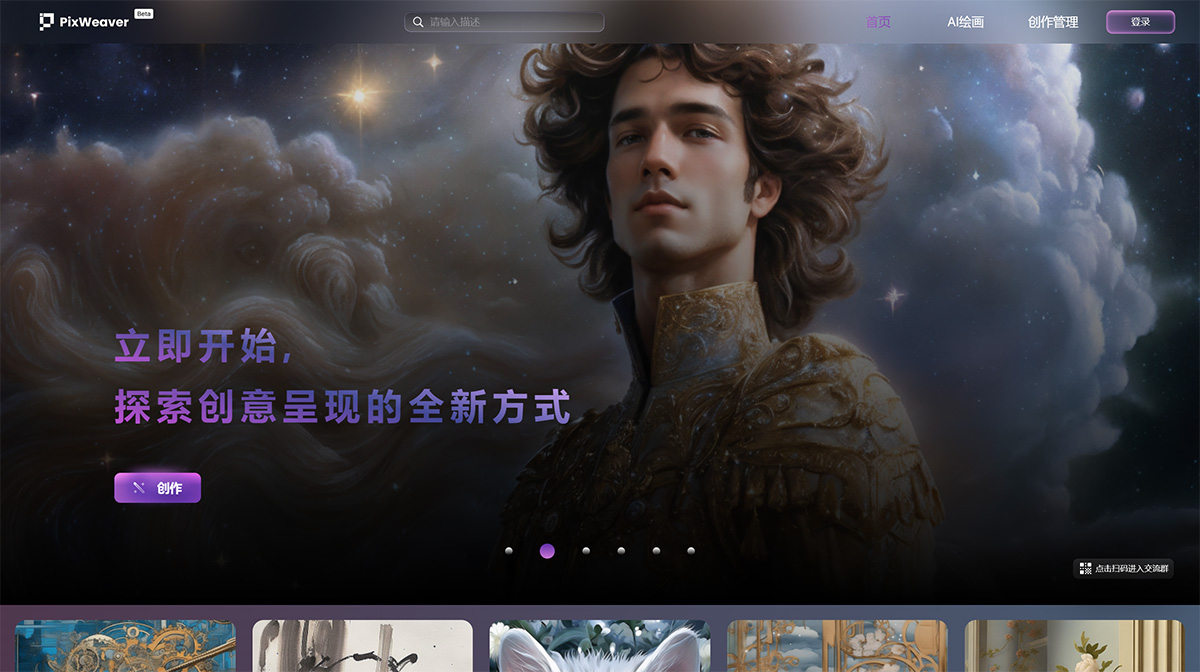
Функциональные возможности PixWeaver:
Генерация изображений по голосовому или текстовому описанию
Мощные модели для творчества на основе AI
Функции обработки и ретуши изображений
Функции управления творческим процессом
PixWeaver от Shengshu Technology — это персонализированная платформа визуального креативного дизайна с функцией высококачественной генерации изображений по тексту, разнообразными стилями, художественным уровнем исполнения, расширением творческих возможностей и эффективным созданием контента. Shengshu Technology — это разработчик мультимодальных моделей промышленного уровня, специализирующийся на разработке мультимодальных генеративных моделей большого размера и прикладных продуктов. Компания открыла исходный код мультимодальной диффузионной модели большого размера Unidiffuser на основе архитектуры Transformer, впервые реализовав мультимодальность в Diffusion Model (диффузионной модели) с использованием архитектуры Transformer U-ViT, что позволяет на основе одной базовой модели качественно выполнять множество генеративных задач: генерацию изображения по тексту, генерацию текста по изображению, совместную генерацию изображения и текста, переработку изображения и текста.















