
 Помощник сценариста▸
 AI Приложения
 AI Новости
DeepSeek-V4, GPT-5.5 и Opus 4.7: битва трёх топовых моделей в апреле 2026!
小编 ·

DeepSeek-V4, GPT-5.5 и Opus 4.7: битва трёх топовых моделей в апреле 2026!
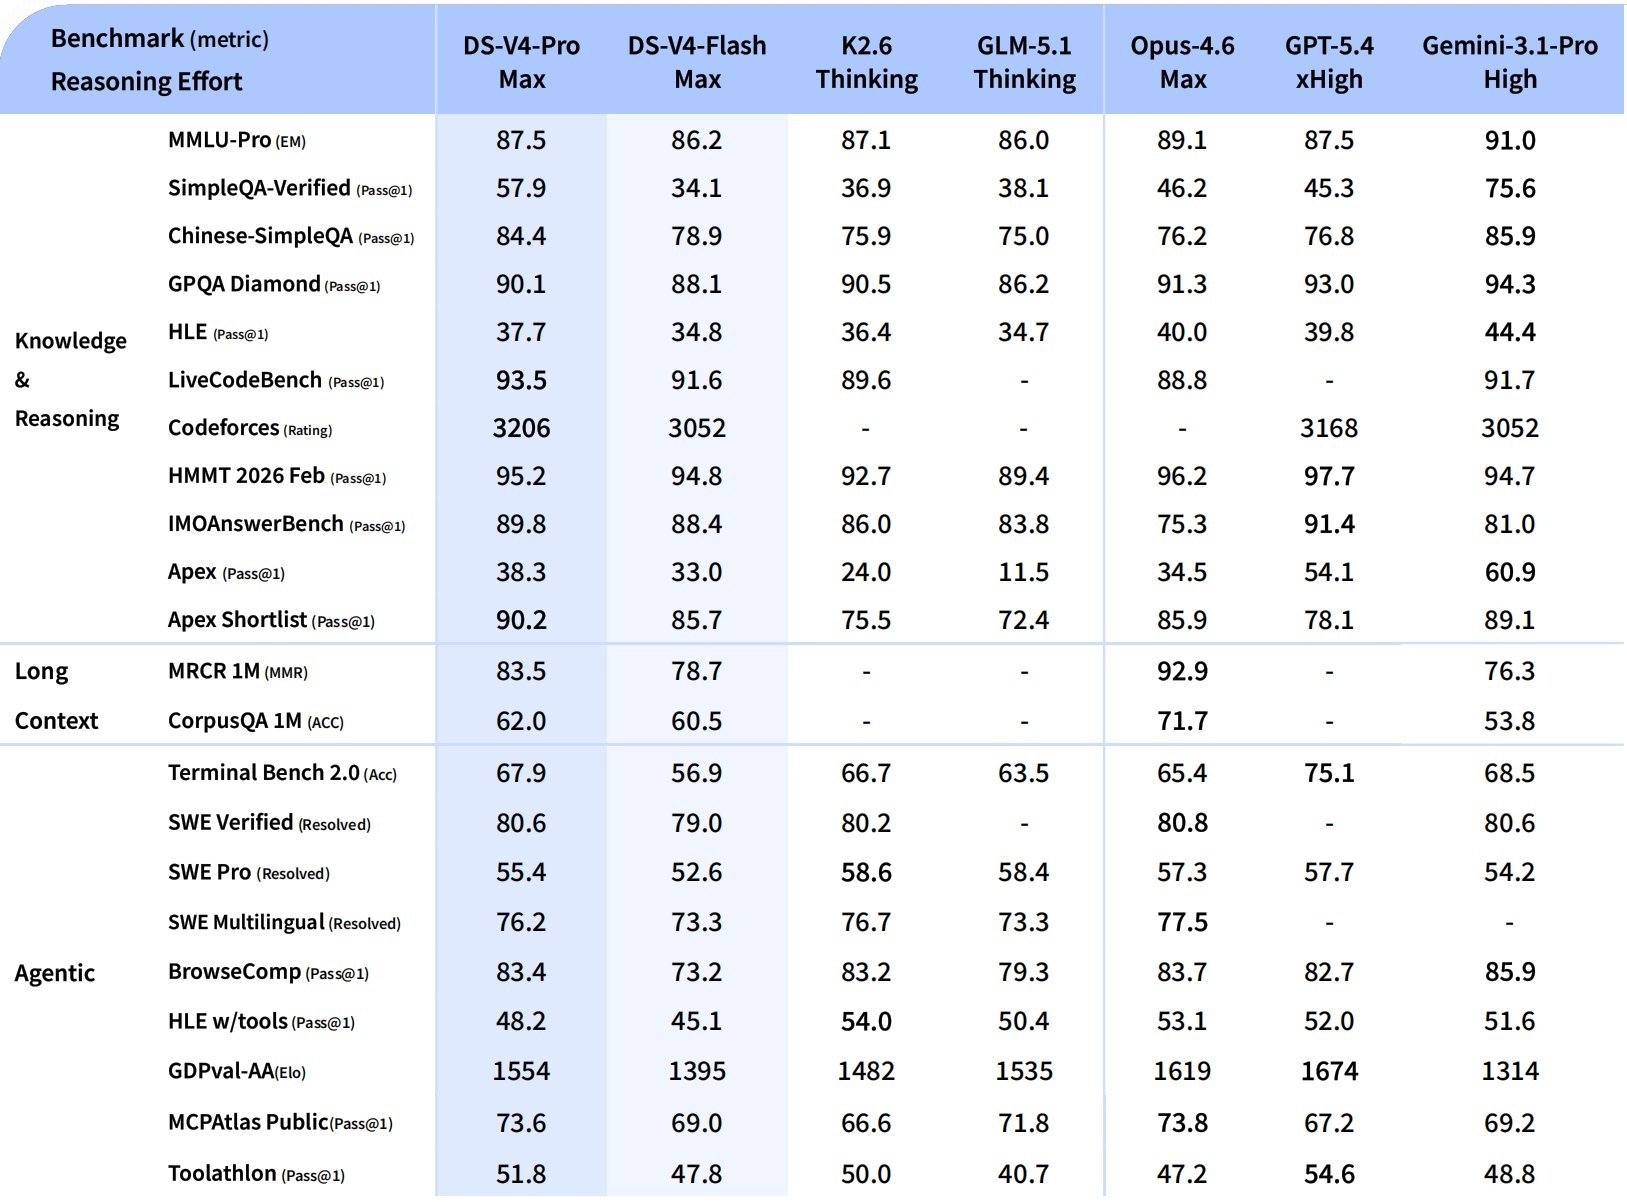
В апреле 2026 года три ведущие модели — DeepSeek, Claude и GPT — были представлены одна за другой. DeepSeek-V4 ориентирован на длинный контекст и низкую стоимость, Claude Opus 4.7 специализируется на программировании и логических рассуждениях, а GPT-5.5 — это выбор с относительно сбалансированными общими возможностями. В этой статье сравниваются три модели по трём измерениям: коду, рассуждениям и цене, чтобы вы могли сориентироваться.
📊 Сравнение ключевых параметров и возможностей
| Измерение | DeepSeek-V4 (Pro) | Claude Opus 4.7 | GPT-5.5 (xHigh) |
|---|---|---|---|
| Основное позиционирование | Предельная экономичность + сверхдлинный контекст | Лучшая инженерия кода + строгая логика | Сбалансированные универсальные возможности + мультимодальность |
| Окно контекста | 1 000 000 (1M) | ~200K (стандарт) | ~128K – 400K |
| Возможности кода | SWE-Bench: ~80,6% | SWE-Bench: ~87,6% | SWE-Bench: ~75–80% |
| Математика / рассуждения | Очень сильные (близки к лучшим закрытым) | Лучшие (самокоррекция) | Лучшие (самые высокие баллы в бенчмарках) |
| Мультимодальность | Текст + изображения | Изображение высокого разрешения (3,75 Мп) | Нативная полная мультимодальность (аудио/видео) |
| Способ развёртывания | Open-source + API (возможно частное развёртывание) | Закрытый API | Закрытый API |
| Цена | ¥4 / 1M токенов (вход) | ~$35 / 1M токенов (вход) | ~$70+ / 1M токенов (вход) |
🧐 Подробный разбор каждой модели
DeepSeek-V4: длинный контекст и экономичность
Контекст в 1M — его ключевое отличие. Если вам нужно разово обработать большой объём финансовых отчётов, технической документации или протоколов совещаний, V4 — подходящий выбор. Возможности в коде (SWE-Bench 80,6%) и математических рассуждениях не слабые, в ряде сценариев близки к GPT-5.5. Цена входных токенов примерно в 1/20 от GPT-5.5, что даёт заметное преимущество компаниям с высокой частотой вызовов API. Недостаток: мультимодальность (понимание видео/аудио) и сложное творческое написание текстов уступают Claude и GPT.
Claude Opus 4.7: программирование и инженерия
В SWE-Bench Verified набирает 87,6%, что заметно выше других моделей. Он не только пишет код, но и обладает способностью к самокоррекции и планированию, справляясь с такими высокими требованиями, как финансовый код. В части зрения поддерживает ввод изображений с разрешением 3,75 мегапикселя, распознавая сложные химические молекулярные структуры или проектные чертежи. В технических дискуссиях возражает на ошибочные утверждения пользователя — больше похож на опытного коллегу. Недостатки: высокая цена, нет версии open-source.
GPT-5.5: более сбалансированные общие возможности
В сводных рейтингах вроде MMLU-Pro по-прежнему удерживает оценки выше 90, стабильно показывая широкую и глубокую базу знаний. Цепочка инструментов (DALL-E, Voice Mode) и экосистема сторонних плагинов относительно зрелые. Но цена слишком высока, и для большинства обычных применений премия за производительность может оказаться неоправданной.
💡 Как выбрать
Выбирайте DeepSeek-V4, если:
нужно обрабатывать сверхдлинные документы, например юридические дела, целые романы или огромные массивы логов;
вы разработчик или стартап, чувствительный к стоимости API или нуждающийся в частном развёртывании;
нужна модель с сильными возможностями в китайском языке и быстрым откликом.
Выбирайте Claude Opus 4.7, если:
основной сценарий — написание кода, разработка ПО или сложные логические рассуждения;
требуется высокая точность следования инструкциям или возможности визуального анализа, например разбор проектных чертежей;
бюджет достаточен и вы хотите получать сейчас самое высокое качество кода.
Выбирайте GPT-5.5, если:
нужен универсальный помощник для сложных междисциплинарных задач;
рабочий процесс глубоко завязан на экосистему Microsoft/Azure;
нужно работать с мультимодальным контентом — аудио, видео и т. п.









