
 Помощник сценариста▸
 AI Приложения
 AI Новости
Qwen-Image: открытая модель генерации изображений и постеров от Alibaba Tongyi
小编 ·

Qwen-Image: открытая модель генерации изображений и постеров от Alibaba Tongyi
Qwen-Image — это базовая модель генерации изображений с открытым исходным кодом, выпущенная командой Alibaba Tongyi Qianwen 5 августа 2025 года, с 20 миллиардами параметров и архитектурой MMDiT. Она показывает выдающиеся результаты в сложной отрисовке текста и точной обработке изображений, особенно хорошо генерирует большой объём точного китайского текста, а также поддерживает китайские подсказки, лидируя во многих специализированных китайскоязычных тестах, таких как LongText-Bench и ChineseWord.
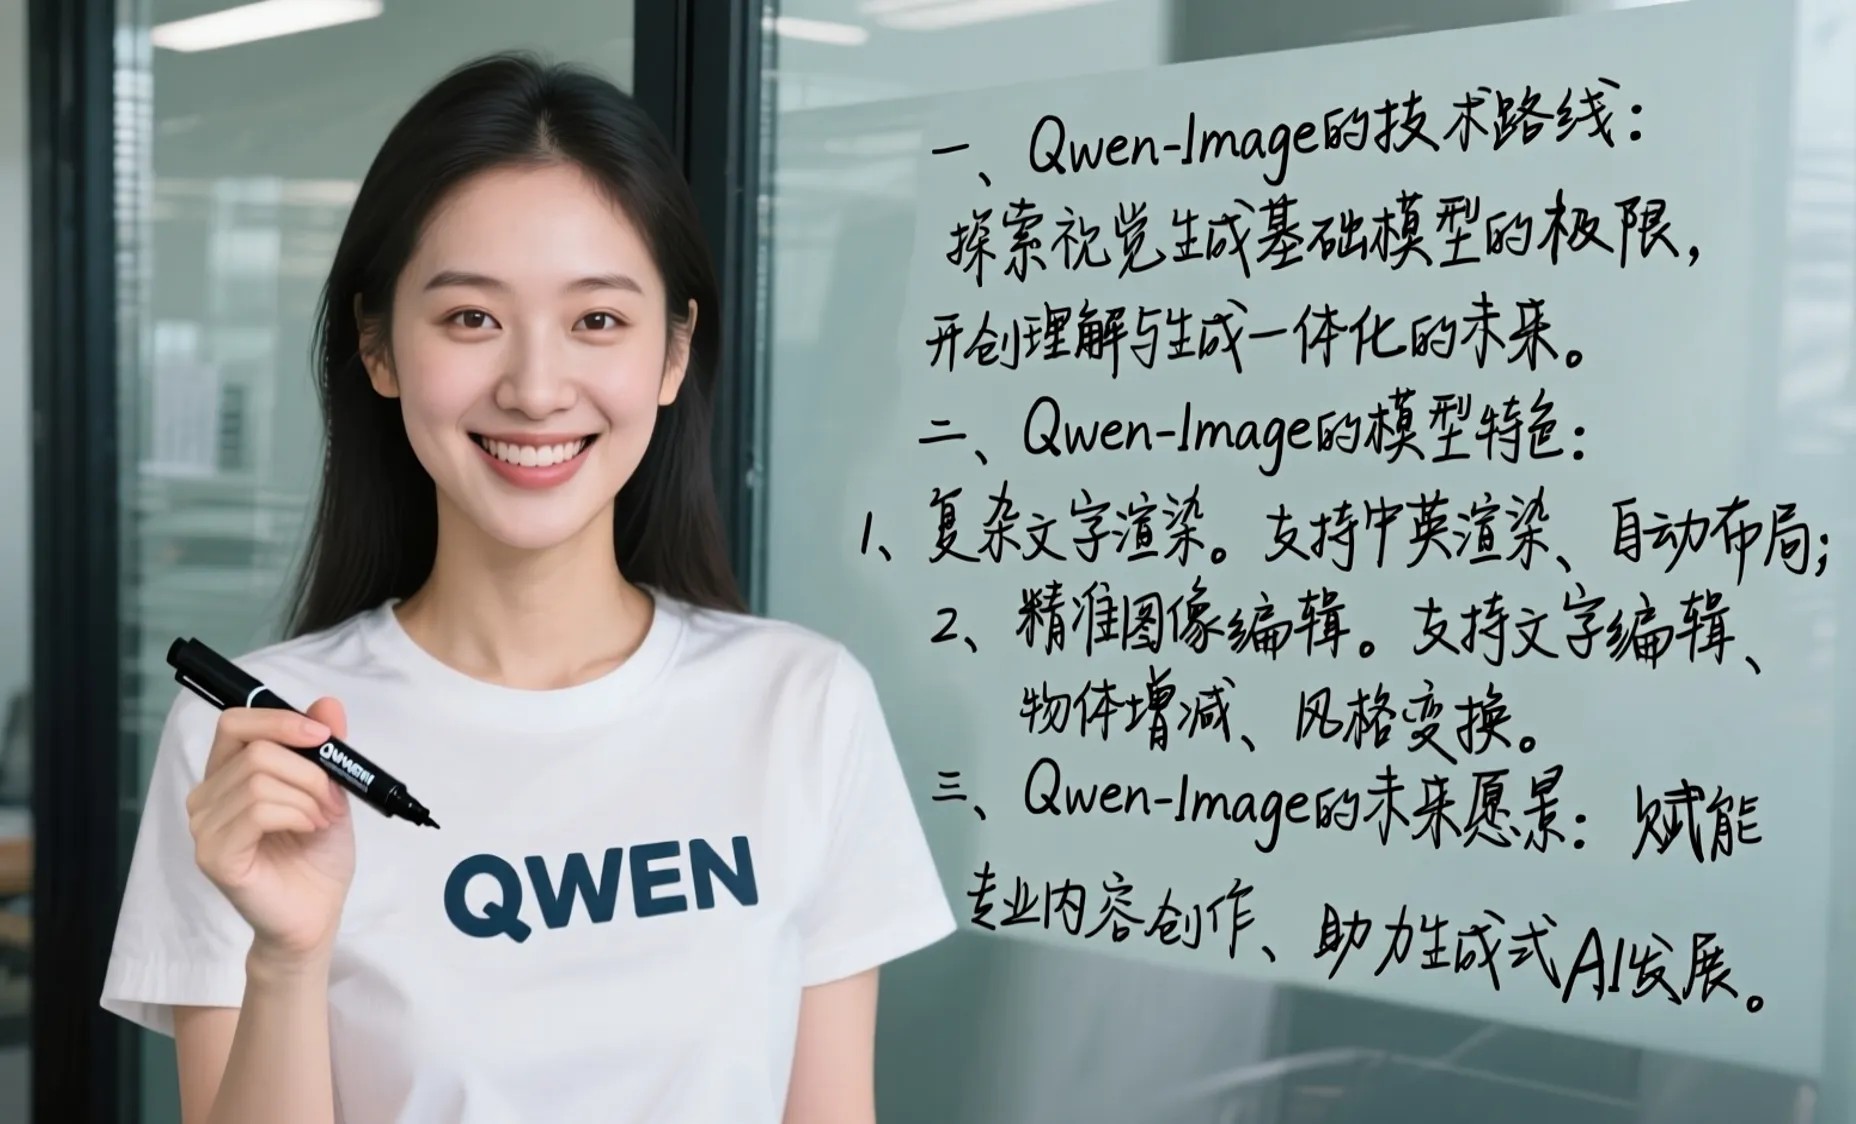
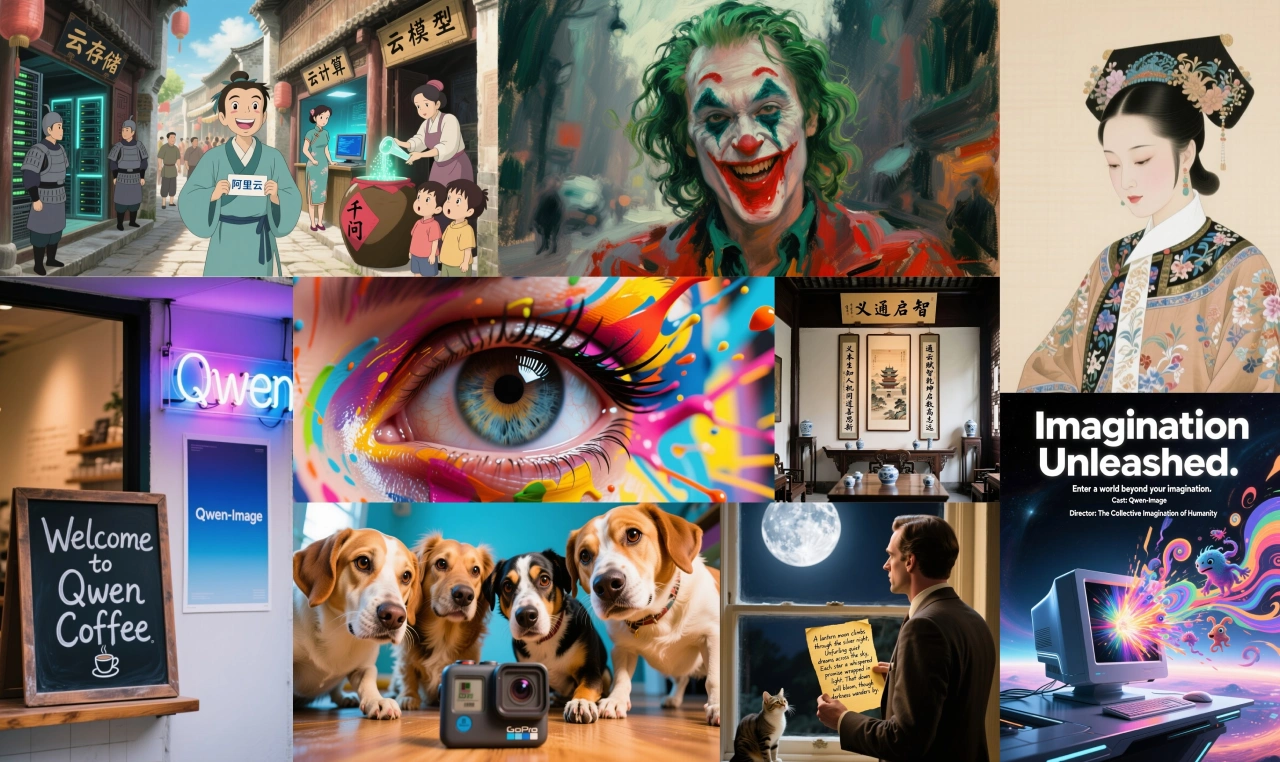
Эта модель поддерживает китайский и английский языки, способна обрабатывать различные шрифты, сверхдлинные абзацы и сложное расположение текста и изображений. Она может создавать изображения для различных сценариев, таких как постеры и ppt, а также выполнять редактирование изображений, включая перенос стиля, добавление или удаление объектов, изменение позы и другие операции. Она может применяться во многих отраслях, таких как рекламный дизайн, кинопроизводство, разработка игр, образование и обучение. Пользователи могут воспользоваться ею в QwenChat (chat.qwen.ai), выбрав функцию генерации изображений, чтобы как создавать постеры, страницы PPT, рекламные изображения товаров и т. д., так и выполнять различное редактирование изображений, предоставляя дизайнерам мощный инструмент.
Основные характеристики
Мощные возможности отрисовки текста: поддержка многострочной вёрстки, генерация текста на уровне абзацев и детальная проработка; возможен высококачественный вывод как на китайском, так и на английском языках. Показывает отличные результаты в тестах LongText-Bench, ChineseWord и TextCraft. Отрисовка китайского текста значительно превосходит существующие передовые модели, способна генерировать текст на разных языках и в разных стилях, писать каллиграфическим почерком или сразу создавать страницы PPT с текстом и изображениями.
Высокая согласованность при редактировании изображений: благодаря усиленному многозадачному обучению при редактировании сохраняется визуальная и семантическая целостность. Поддерживаются перенос стиля, добавление, удаление, изменение, улучшение деталей, редактирование текста, изменение поз персонажей и другие операции.
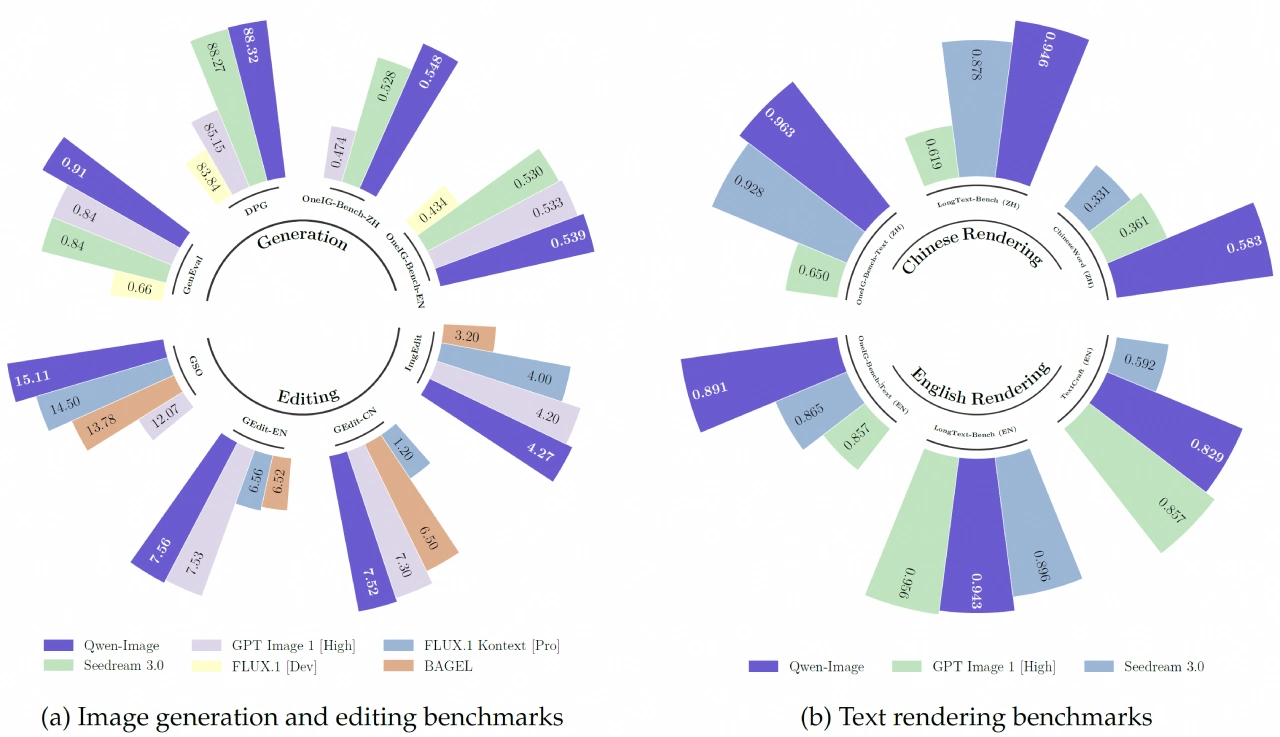
Отличная производительность на разных бенчмарках: достигает передовых результатов в нескольких открытых тестах, таких как GenEval, DPG и OneIG-Bench для общей генерации изображений, а также GEdit, ImgEdit и GSO для редактирования изображений.
Ключевые компоненты
Мультимодальная большая языковая модель Qwen2.5-VL: выступает в роли кодировщика условий, извлекает признаки из текста, подробно описывает цвет, количество, текст и другие характеристики объектов и фона в соответствии с системными подсказками, обеспечивая основу для генерации изображений и делая генерируемый контент более детализированным.
Вариационный автокодировщик (VAE) из модели генерации видео Wan-2.1: служит токенизатором изображений, сжимает входное изображение в компактное латентное представление и декодирует его обратно во время вывода. Команда заморозила кодировщик и дообучила только декодировщик, чтобы подчеркнуть детали изображения.
Мультимодальный диффузионный Transformer (MMDiT): выступает в качестве основной диффузионной модели, обрабатывает взаимосвязь между шумом и латентным представлением изображения под управлением текста. Использование мультимодального масштабируемого метода RoPE помогает различать информацию изображения и текста, обеспечивая как генерацию изображений с высоким разрешением, так и точное создание текста.
Архитектура Qwen-Image
Архитектура MMDiT: использует мультимодальный диффузионный трансформер для глубокого слияния текста и изображений.
VAE с одним кодировщиком и двумя декодировщиками: отвечает за сжатие изображения в компактное латентное представление и его декодирование обратно в пиксели после генерации. Балансируя потери восстановления и перцептивные потери, можно реалистично воспроизводить детали изображения.
Мультимодальное масштабируемое вращающееся позиционное кодирование (MSRoPE): кодирует текстовую информацию по «диагоналям» сетки изображения, сохраняя независимость текста и используя преимущества масштабирования разрешения изображения.
Стратегия обучения
Использование многоэтапного, прогрессивного предварительного обучения: постепенное обучение от низкого разрешения к высокому, от общего контента к специализированному, от массивных данных к очищенным.
Контролируемая тонкая настройка (SFT) и обучение с подкреплением (RL) на поздних этапах обучения: тонкая настройка с использованием вручную отобранных высококачественных данных, а также применение таких технологий, как DPO, для обучения модели человеческим предпочтениям.
Сценарии применения
Рекламный дизайн: быстрая генерация высококачественных изображений в соответствии с фирменным стилем, поддержка преобразования стилей и оптимизации деталей, что помогает дизайнерам быстро опробовать различные эффекты и удовлетворить потребности клиентов.
Кинопроизводство: используется для создания предварительных концепт-артов, сцен и дизайна персонажей, сокращая производственный цикл и снижая затраты.
Визуальное оформление для электронной коммерции: продавцы могут быстро создавать изображения товаров, виртуальной примерки и маркетинговые материалы, повышая удобство для пользователей и увеличивая конверсию покупок.
Создание постеров: генерация эффектных художественных постеров (например, киноафиш, афиш мероприятий) в соответствии с текстовыми и дизайнерскими требованиями, адаптируемых к различным стилям и темам.
Создание PPT: генерация корпоративных страниц PPT с использованием основного звёздного синего тона в сочетании с плавными технологичными линиями и эффектами мерцающих частиц; изображения выглядят профессионально и современно, поддерживается множество стилей и макетов.
Производительность
Общая генерация изображений: отличные результаты в тестах GenEval, DPG и OneIG-Bench.
Редактирование изображений: лучшие результаты в специализированных тестах GEdit, ImgEdit и GSO.
Отрисовка текста: выдающиеся возможности в тестах LongText-Bench, ChineseWord и TextCraft, особенно отрисовка китайского текста значительно превосходит существующие передовые модели.
Преимущества Qwen-Image
Лучшая поддержка китайского языка: специальная оптимизация для китайского языка, эффект отрисовки значительно лучше, чем у DALL-E.
Полностью бесплатно: не требуется платная подписка, также возможно локальное развёртывание.
Открытый исходный код и прозрачность: код находится в открытом доступе и допускает индивидуальную модификацию.
Более мощные функции редактирования: поддержка более разнообразных операций редактирования изображений.
Отсутствие ограничений на использование: без лимитов на количество вызовов API.
Как пользоваться Qwen-Image
Подготовка среды: установите последнюю версию diffusers.
Базовый код:
from diffusers import DiffusionPipeline
import torch
model_name = "Qwen/Qwen-Image"
if torch.cuda.is_available():
    torch_dtype = torch.bfloat16
    device = "cuda"
else:
    torch_dtype = torch.float32
    device = "cpu"
pipe = DiffusionPipeline.from_pretrained(model_name, torch_dtype=torch_dtype)
pipe = pipe.to(device)
prompt = '''一个穿着"QWEN"标志T恤的中国美女正拿着黑色马克笔面向镜头微笑。她身后的玻璃板上手写体写着"欢迎使用Qwen-Image,一款强大的图像基础模型"'''
aspect_ratios = {
    "1:1": (1328, 1328),
    "16:9": (1664, 928),
    "9:16": (928, 1664),
    "4:3": (1472, 1140),
    "3:4": (1140, 1472)
}
width, height = aspect_ratios["16:9"]
image = pipe(
    prompt=prompt + "超清,4K,电影级构图",
    width=width,
    height=height,
    num_inference_steps=50,
    true_cfg_scale=4.0,
    generator=torch.Generator(device=device).manual_seed(42)
).images[0]
image.save("qwen_image_example.png")
GB видеопамяти), режим CPU работает медленнее, но также может использоваться.
✅Официальная презентация Qwen-Image: https://qwenlm.github.io/zh/blog/qwen-image/
✅Модель Qwen-Image: https://huggingface.co/Qwen/Qwen-Image
✅Использовать онлайн: https://chat.qwen.ai/ (выберите «Генерация изображений» под полем ввода)









