
 Помощник сценариста▸
 AI Приложения
 AI Новости
MOSS-TTSD: открытая двуязычная модель синтеза диалоговой речи
小编 ·

MOSS-TTSD: открытая двуязычная модель синтеза диалоговой речи
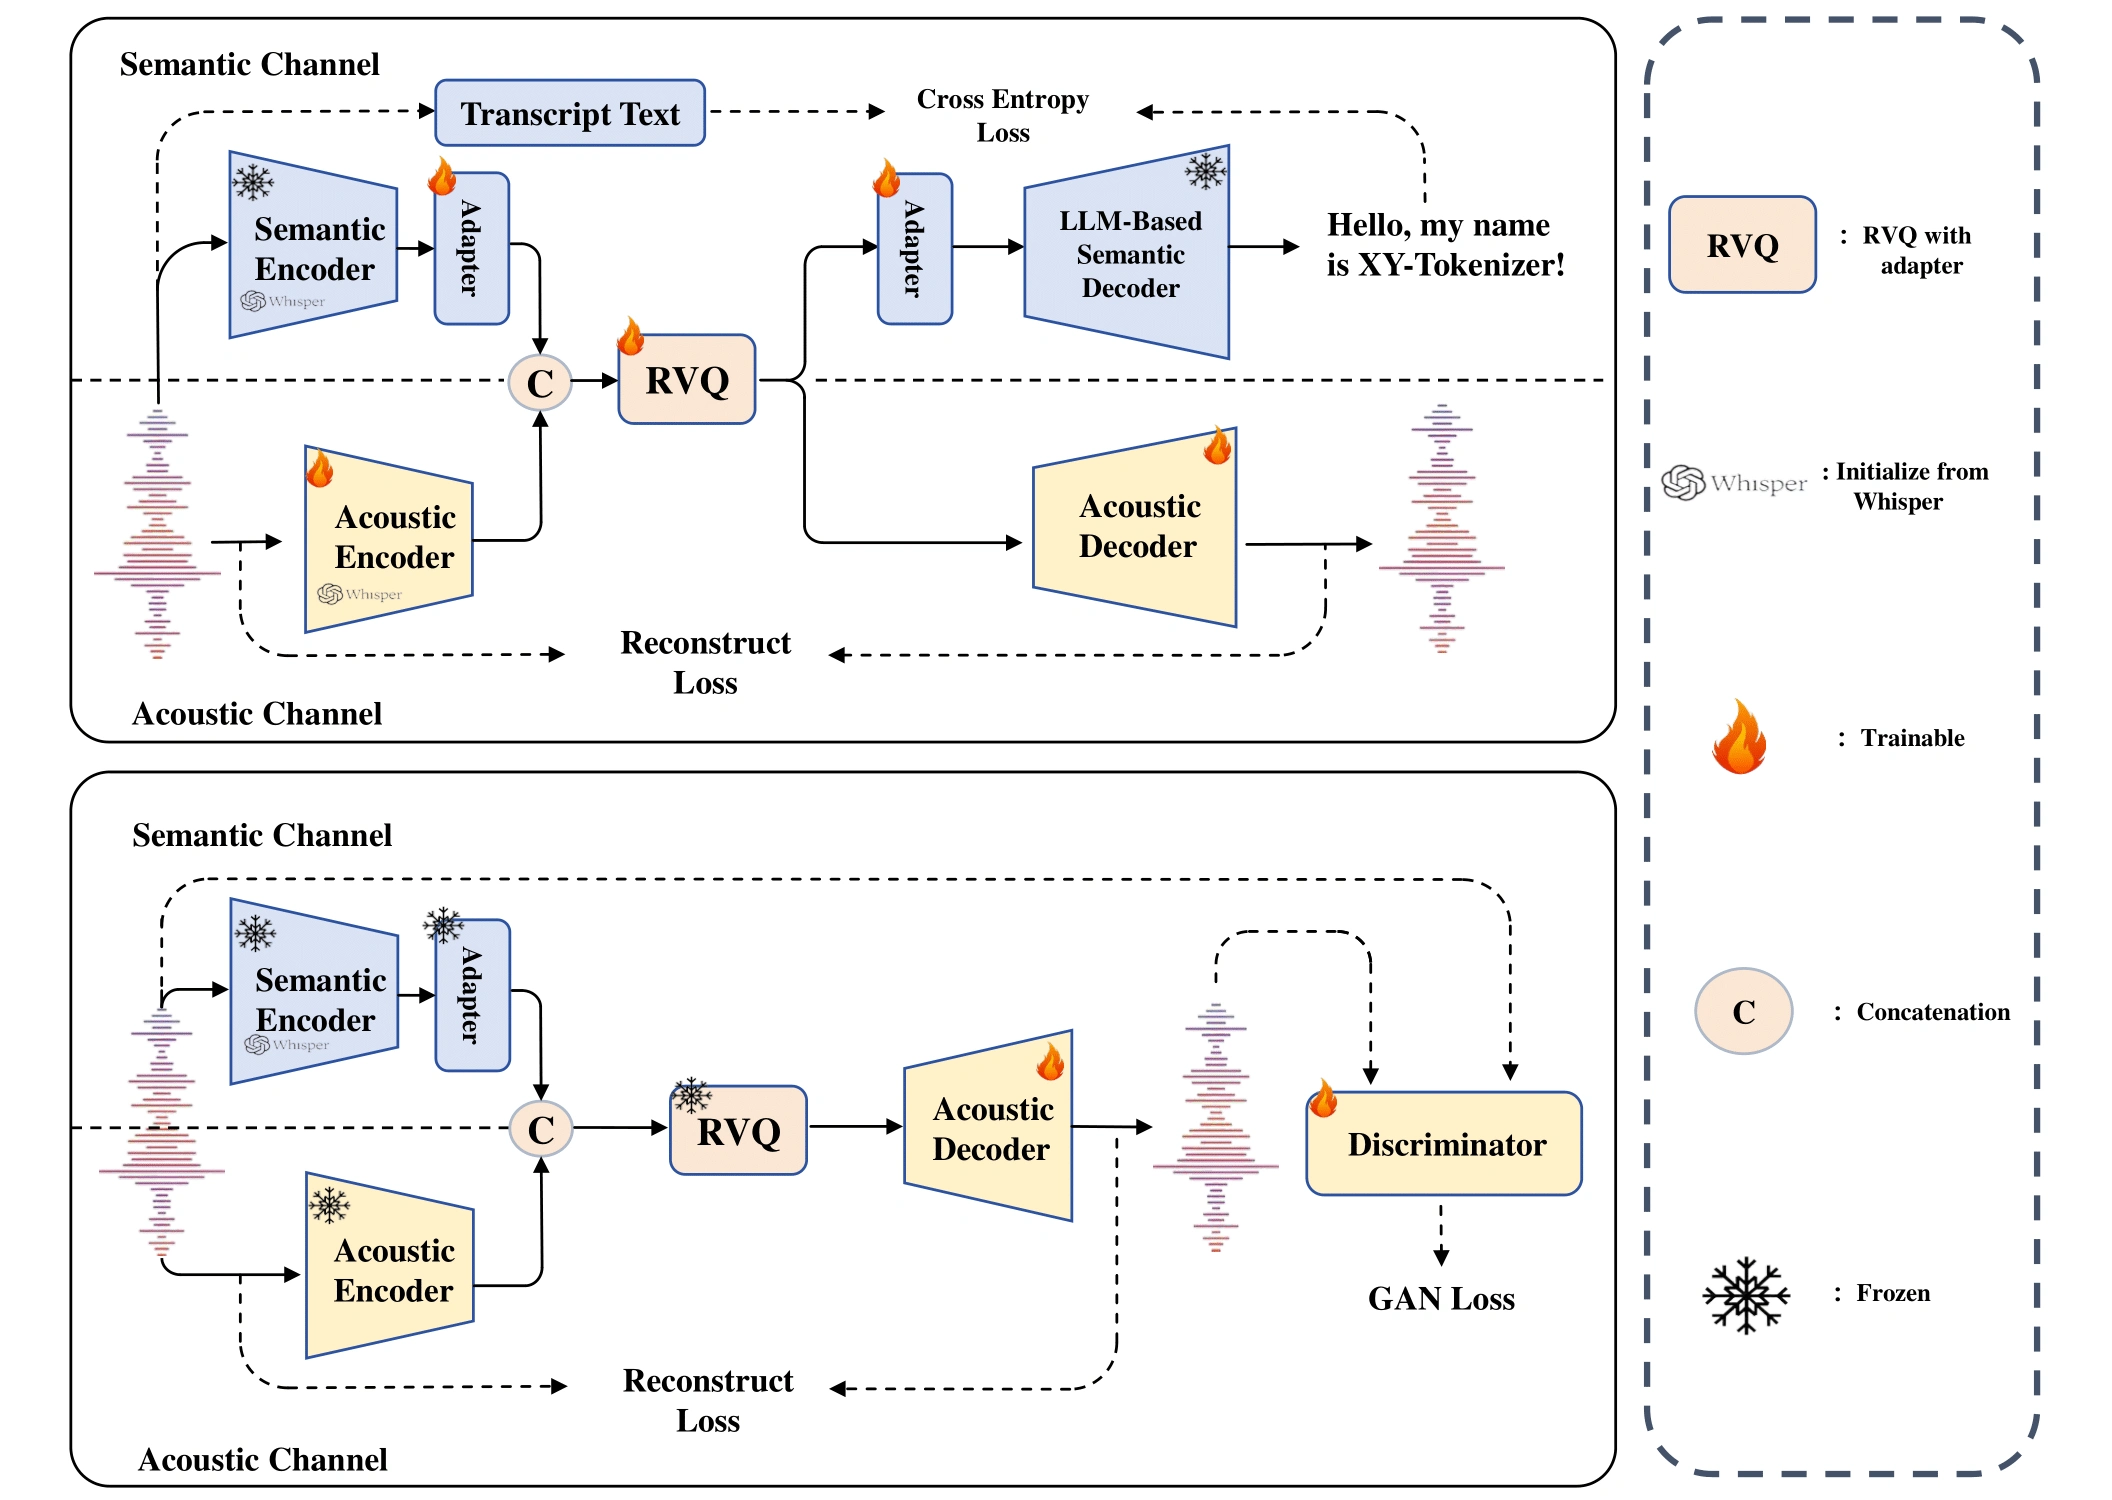
MOSS-TTSD — это модель синтеза двуязычной разговорной речи с открытым исходным кодом, разработанная совместно Лабораторией речи и языка Университета Цинхуа, AI-лабораторией Tencent и другими организациями. Она поддерживает китайский и английский языки и способна преобразовывать диалоговые сценарии двух говорящих в естественную, выразительную разговорную речь. Модель дообучена на базе Qwen3-1.7B-base, использует моделирование дискретных речевых последовательностей, а с помощью XY-Tokenizer сжимает речь до 1 кбит/с, сохраняя при этом семантическую и акустическую информацию.
Модель MOSS-TTSD поддерживает китайский и английский языки, способна клонировать голоса нескольких говорящих без примеров (zero-shot) и генерировать речь длительностью до 960 секунд, что делает её подходящей для таких сценариев, как AI-подкасты, дубляж в кино и на телевидении, длинные интервью и т. д. Веса модели, код для инференса и API-интерфейсы были открыты, а также разрешено бесплатное коммерческое использование.
Основные особенности
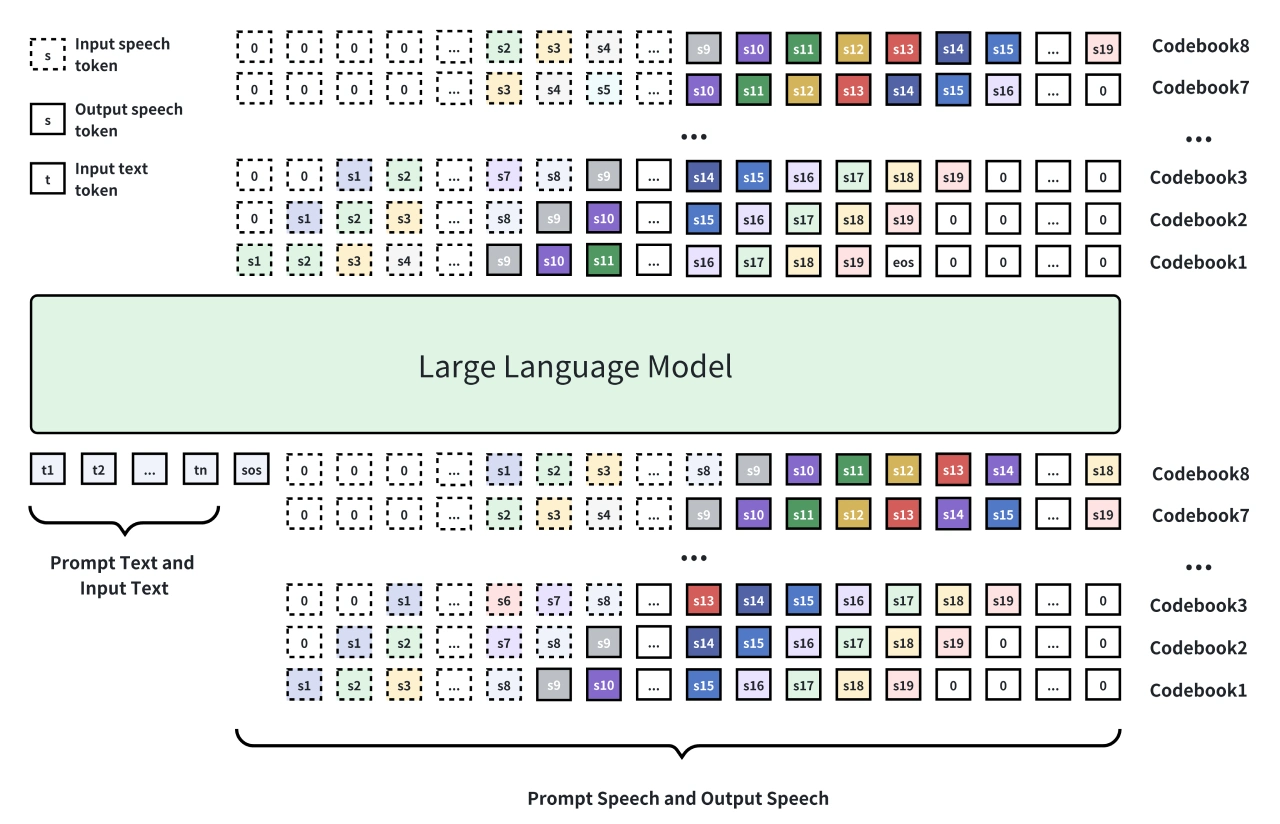
✅Выразительная разговорная речь: благодаря унифицированному семантико-акустическому нейросетевому аудиокодеку, предобученной большой языковой модели, а также миллионам часов данных для TTS и 400 тысячам часов синтетической и реальной разговорной речи, модель способна генерировать человекоподобную разговорную речь с естественной разговорной просодией и высокой выразительностью.
✅Клонирование голоса двух говорящих: поддерживается клонирование голоса двух говорящих без примеров (zero-shot), модель точно переключается между говорящими в соответствии с диалоговым сценарием и генерирует разговорную речь.
✅Поддержка китайского и английского языков: возможность генерировать выразительную речь на китайском и английском языках.
✅Генерация длинной речи: за счёт низкоскоростного кодека и оптимизации обучающего фреймворка модель специально обучена для генерации длинной речи.
✅Полностью открытый исходный код и коммерческое использование: MOSS-TTSD и все его будущие обновления будут полностью открыты, а также разрешено бесплатное коммерческое использование.
Технические принципы MOSS-TTSD
✅Архитектура модели: дообучение на базе модели Qwen3-1.7B-base с использованием моделирования дискретной речи. Речевой сигнал преобразуется в последовательность дискретных токенов с помощью 8-слойного RVQ (Residual Vector Quantization), генерация выполняется авторегрессионным способом с использованием Delay Pattern, а итоговая речь восстанавливается декодером.
✅Ключевые инновации: XY-Tokenizer использует двухэтапный процесс многозадачного обучения. На первом этапе одновременно обучаются задачи автоматического распознавания речи (ASR) и восстановления речи, объединяя семантическую и грубую акустическую информацию; на втором этапе кодировщик и квантизатор фиксируются, обучается только декодер с добавлением потерь восстановления и GAN-потерь для усиления детализации.
✅Объём данных и предобучение: обучение проводилось на примерно 1 миллионе часов данных речи одного говорящего и 400 тысячах часов данных разговорной речи. Данные прошли строгий отбор и разметку, также было выполнено предобучение TTS для китайского и английского языков.
Сценарии применения
✅Создание AI-подкастов: MOSS-TTSD способен автоматически преобразовывать текст в подкаст-аудио с диалогами нескольких человек, поддерживает клонирование голоса без примеров и генерацию длинной речи, что позволяет снизить затраты на производство.
✅Дубляж в кино/на телевидении и анимация: создание естественной разговорной речи для фильмов, телепередач и анимации с поддержкой переключения между языками, что повышает эффективность дубляжа.
✅Длинные интервью и записи совещаний: преобразование текстов интервью или совещаний в речь с сохранением просодии и эмоций диалога, что удобно для архивирования и обмена.
Преимущества и особенности
✅Открытый исходный код и дружелюбность к коммерческому использованию: веса модели MOSS-TTSD, код для инференса и API-интерфейсы были открыты, и пользователи могут бесплатно использовать их в коммерческих целях.
✅Естественность и выразительность: естественность и выразительность звучания достигают передового уровня в отрасли.
✅Поддержка управления звуковыми событиями: например, невербальные звуки, такие как смех, делают речь более выразительной.
Адрес открытого исходного кода:https://github.com/OpenMOSS/MOSS-TTSD
Официальный сайт MOSS-TTSD:https://www.open-moss.com/cn/









