
 Помощник сценариста▸
 AI Приложения
 AI Новости
ThinkSound: мультимодальный ИИ-инструмент для аудио от лаборатории Tongyi Alibaba
小编 ·

ThinkSound: мультимодальный ИИ-инструмент для аудио от лаборатории Tongyi Alibaba
ThinkSound — это мультимодальный AI-инструмент для работы с аудио, разработанный лабораторией Alibaba Tongyi. Он способен генерировать высококачественные звуковые эффекты и сценический звук на основе входных данных в формате видео, текста или аудио.
Основные функции
✅ Преобразование видео в аудио: преобразование любого видео в насыщенные звуковые эффекты, соответствующие изображению. Путём покадрового анализа элементов изображения, траекторий движения и окружающей обстановки генерируются синхронизированный с окружением фоновый звук, пространственные эффекты и многое другое.
✅ Интеллектуальный синтез речи: создание естественных диалогов и закадрового текста на основе содержимого видео. ИИ распознаёт выражения лица, движения губ и эмоциональный контекст, генерируя речь с точной синхронизацией губ, естественной интонацией и реалистичной эмоциональностью.
✅ Мультимодальное проектирование звуковых эффектов: объединение видео и текстовых команд, эталонных звуков и стилистических предпочтений для точной настройки деталей звука, обеспечивая его естественное слияние с изображением. Подходит для профессионального производства в кино, играх и других областях.
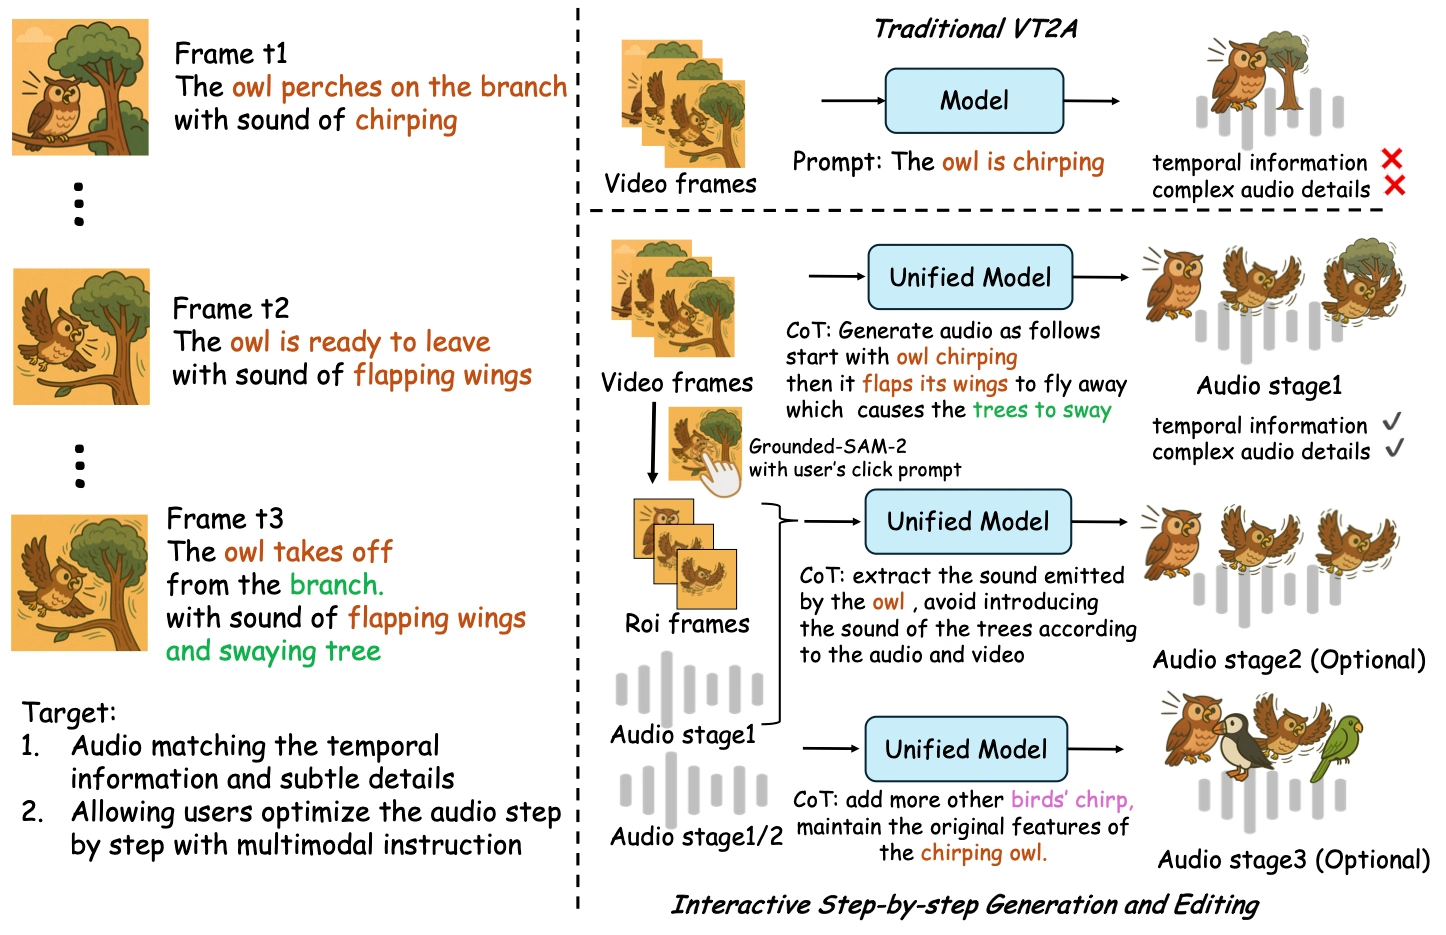
✅ Интерактивное редактирование аудио: пользователи могут уточнять конкретные звуки, нажимая на объекты в видео или вводя команды на естественном языке.
Технические принципы
Трёхэтапный интерактивный механизм:
✅ Базовая генерация звуковых эффектов: система сначала анализирует видео в целом, логически распознаёт звуковые события, элементы окружения, акустические характеристики и временные связи, формируя начальную согласованную фоновую звуковую сцену.
✅ Оптимизация объектов: после нажатия пользователем на целевой объект система с помощью технологии локализации выделяет область и отслеживает движение объекта, целенаправленно генерируя звуковую логику для данного объекта, оптимизируя детали звука при сохранении согласованности с общей звуковой дорожкой.
✅ Редактирование с помощью команд: пользователь вводит команды на естественном языке (например, «добавить пение птиц», «убрать шум автомобиля»), и система преобразует их в точные аудиооперации, согласовывая их с изображением и текущим состоянием звука.
✅ Мультимодальная большая языковая модель (MLLM): ключевая способность — синхронное понимание видеоизображения, текстовых описаний и звукового контекста. После объединения информации модель поэтапно генерирует естественные и реалистичные звуковые эффекты.
Преимущества и особенности
✅ Высокая реалистичность звуковых эффектов, выдающиеся результаты в тестах генерации видео-аудио, отличная адаптация к сценам.
✅ Поддержка создания креативных эффектов с помощью детальных подсказок при сохранении естественной синхронизации звука и изображения.
✅ Совместимость с основными видеоформатами (MP4/MOV/AVI/MKV), поддержка разрешений от стандартной чёткости до 4K и различных частот кадров.
✅ Специально разработан для профессиональных сценариев (кино, реклама, игры и др.), все версии включают лицензию на коммерческое использование.
Сценарии применения
✅ Постпродакшн в кино: быстрое создание фоновых звуков, диалогов или музыкального сопровождения для немого материала, повышение эффективности производства.
✅ Игровые звуковые эффекты: создание динамических окружающих звуков для усиления эффекта погружения в виртуальные сцены.
✅ Интерактивные медиа и образование: многоязычные диалоги благодаря синтезу речи в сочетании с точной синхронизацией губ и эмоциональной выразительностью делают виртуальных персонажей более живыми.
Ссылки на проект
✅ Github: https://github.com/FunAudioLLM/ThinkSound
✅ Официальная страница: https://thinksound-demo.github.io/
✅ HuggingFace: https://huggingface.co/spaces/FunAudioLLM/ThinkSound









