
 Помощник сценариста▸
 AI Приложения
 AI Новости
MultiTalk: открытый инструмент Meituan для генерации видео с разговором нескольких людей на основе аудио
小编 ·

MultiTalk: открытый инструмент Meituan для генерации видео с разговором нескольких людей на основе аудио
MultiTalk — это инструмент генерации видео на основе аудио для диалогов нескольких людей, разработанный и открытый командой визуального интеллекта Meituan. Он способен генерировать видеоролики с диалогами цифровых аватаров с синхронизацией губ и естественными движениями тела на основе аудиозаписей нескольких говорящих, референсных изображений и текстовых подсказок, при этом результаты получаются весьма впечатляющими. Пользователю достаточно загрузить аудио, референсное изображение и промпт, чтобы сгенерировать видео диалога с совпадающей мимикой, а также создавать сцены пения и мультипликационных персонажей.
У этого проекта множество практических возможностей: очень точная синхронизация губ на основе аудио, возможность управлять движениями виртуальных персонажей с помощью промптов, вывод видео в различных разрешениях, а также генерация диалоговых сцен длительностью до 15 секунд. Кроме того, он интегрирует функцию преобразования текста в речь, включает ряд оптимизаций для повышения эффективности генерации, поддерживает режим низкого потребления видеопамяти и инференс на нескольких GPU, и может работать даже на одной видеокарте RTX 4090.
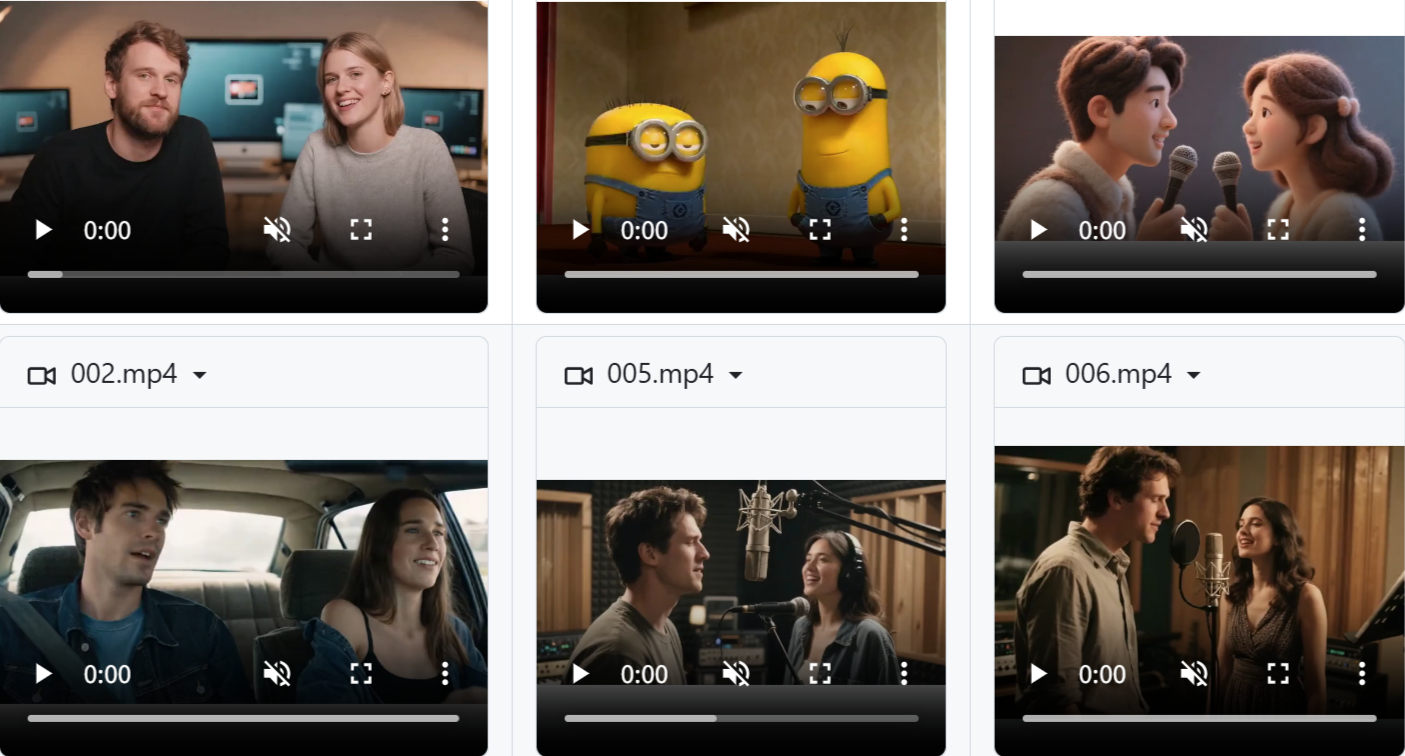
Функциональные особенности
✅ Управление аудио: вводя аудио нескольких говорящих, можно генерировать естественную синхронизацию губ и движения тела
✅ Ввод одной фотографии: достаточно всего одного референсного изображения для генерации видео с взаимодействием нескольких людей
✅ Следование сложным движениям: поддержка сложных текстовых подсказок для генерации движений и сцен в соответствии с описанием
✅ Поддержка нескольких языков: возможность обработки многоязычного аудио с точной синхронизацией губ
✅ Генерация длинных видео: создание связных длинных видеороликов с помощью авторегрессионного метода
✅ Эффективная стратегия обучения: повышение производительности модели за счёт двухэтапного обучения, частичного обновления параметров и многозадачного обучения
✅ Технология L-RoPE: точное связывание нескольких аудиопотоков с персонажами с помощью позиционного кодирования тегов
✅ Высококачественный вывод: генерируемые видеоролики естественны и плавны, визуальные артефакты практически отсутствуют
Технические преимущества
✅ Первоклассная технология L-RoPE: использование позиционного кодирования тегов решает проблему рассогласования нескольких аудиопотоков и персонажей, обеспечивая точное соответствие аудио и персонажей
✅ Генерация видео на основе аудио: вводя аудио нескольких говорящих, референсные изображения и текстовые подсказки, можно создавать интерактивные видео с синхронизацией губ и естественными движениями тела
✅ Частичное обучение параметров + стратегия многозадачного обучения: сохранение способности следовать сложным инструкциям по движениям при одновременной адаптивной локализации динамических персонажей
✅ Поддержка множества сценариев: может применяться в кинопроизводстве, прямых трансляциях электронной коммерции и других областях
Техническая архитектура
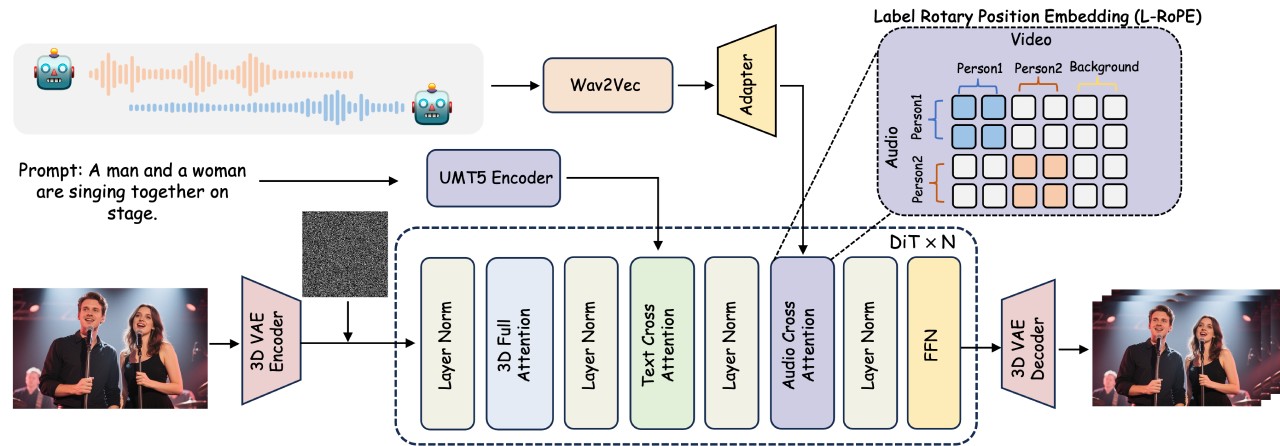
✅ Базовая структура модели: в основе лежит модель диффузии видео DiT, интегрированная с 3D-вариационным автокодировщиком для эффективной обработки видеоданных
✅ Интеграция аудио для одного человека: добавление механизма аудио-кросс-внимания после слоя текстового кросс-внимания в каждом блоке DiT, извлечение аудиопризнаков с помощью Wav2Vec, использование аудиоадаптера для решения проблемы несоответствия временного масштаба видео и аудио
✅ Обработка аудио нескольких говорящих: точное связывание нескольких аудиопотоков с несколькими персонажами благодаря технологии L-RoPE, что предотвращает эффект «одновременной речи»
Стратегия обучения:
✅ Двухэтапное обучение: сначала обучается способность генерировать видео с одним человеком, затем — взаимодействие и связывание нескольких персонажей
✅ Частичное обновление параметров: обновляются только параметры сети слоя аудио-кросс-внимания и аудиоадаптера, остальные параметры базовой модели замораживаются
✅ Многозадачное обучение: сочетание двух методов обучения — «аудио + изображение в видео» и «изображение в видео» — для повышения способности модели следовать инструкциям
Показатели производительности
✅ Количественная оценка: при генерации движений головы и тела, по сравнению с рядом передовых методов, показывает выдающиеся результаты по синхронизации губ (Sync-C, Sync-D) и качеству видео (FID, FVD)
✅ Качественная оценка: эффективно справляется со сложными интерактивными сценами, способна генерировать видео, точно реагирующее на сложные текстовые подсказки, с минимальными визуальными артефактами и естественным, реалистичным изображением
✅ Генерация длинных видео: с помощью авторегрессионного метода, в котором конечная часть ранее сгенерированного видео используется как условие для создания новых видеофрагментов, обеспечивая временную связность и расширяемость
Сценарии применения
Кинопроизводство: взаимодействие виртуальных персонажей, озвучка анимации, создание спецэффектов, создание короткометражных фильмов
Прямые трансляции электронной коммерции: интерактивные виртуальные ведущие, демонстрация и описание товаров, многоязычные трансляции
Образовательная сфера: интерактивные виртуальные преподаватели, изучение языков, исторические реконструкции
Разработка игр: диалоги виртуальных персонажей, взаимодействие с NPC, многопользовательские онлайн-игры
Реклама и маркетинг: виртуальные представители бренда, продвижение продуктов, реклама в социальных сетях
Виртуальное общение: интерактивные виртуальные социальные платформы, виртуальные совещания
Развлечения и творчество: музыкальные клипы, виртуальные концерты, творческие короткометражки
Государственные услуги: выпуск новостей, информационные кампании госслужб
Корпоративное обучение: виртуальные обучающие сценарии, ситуационное моделирование
Международное общение: многоязычные диалоги, культурный обмен
Адрес проекта
Домашняя страница проекта:https://meigen-ai.github.io/multi-talk/
Открытый исходный код:https://github.com/MeiGen-AI/MultiTalk
Техническая работа (статья):https://arxiv.org/abs/2505.22647









