
 Помощник сценариста▸
 AI Приложения
 AI Новости
ColQwen-Omni: мультимодальная open-source RAG-модель
小编 ·

ColQwen-Omni: мультимодальная open-source RAG-модель
ColQwen-Omni — это мультимодальная модель RAG с открытым исходным кодом, построенная на базе ColQwen2 и Qwen2-VL, и первая модель с открытым исходным кодом, которая расширяет парадигму поиска ColBERT на аудио модальность.
Она поддерживает кроссмодальный поиск и способна обрабатывать данные различных модальностей, включая текст, аудио и изображения. Обучающий набор данных содержит 127 460 пар «запрос — страница», из которых 63% — это тренировочные наборы из открытых академических наборов данных, а 37% — синтетические данные; модель обладает возможностью поиска по аудио в режиме zero-shot.
Основные преимущества
Кроссмодальный поиск: поддержка запросов по тексту для поиска аудио, аудио для поиска изображений и т. д. — все модальные данные индексируются в едином векторном пространстве.
Прямая обработка аудио- и видеоматериалов: без необходимости транскрибирования модель обрабатывает исходные аудио- и видеоданные напрямую, сохраняя эмоции, интонацию и визуальные детали.
Сверхбыстрый поиск: 30 минут аудио обрабатываются за 10 секунд, короткие видео — менее 10 секунд на каждый фрагмент, один запрос — менее 100 миллисекунд.
Синхронизация TMRoPE: временнáя согласованность мультимодальных эмбеддингов обеспечивает точное выравнивание видео- и аудиокадров.
Лёгкость и эффективность: 3 миллиарда параметров; модель может работать на бесплатном GPU в Colab.
Технические детали ColQwen-Omni
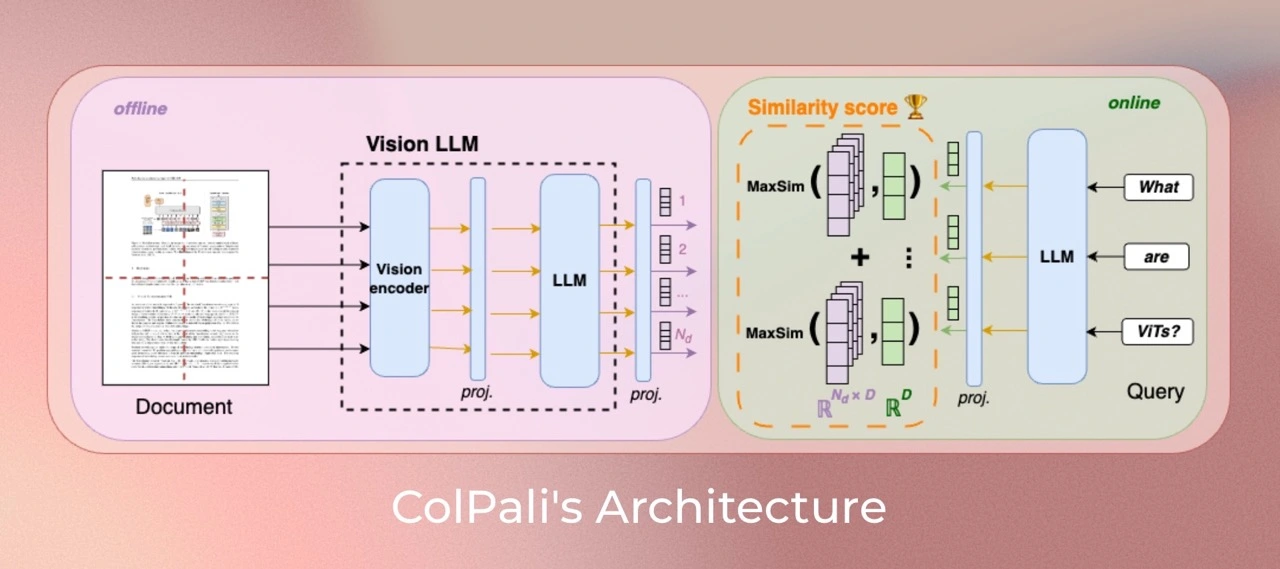
Стратегия обучения: обучение с использованием colpali-engine==0.3.11, построена на базе Qwen2.5-Omni-3B-Instruct, применяется стратегия мультивекторного представления в стиле ColBERT.
Обучающие данные: содержат 127 460 пар «запрос — страница», охватывающих как открытые академические, так и синтетические наборы данных.
Обработка динамического разрешения: поддерживается ввод изображений с динамическим разрешением, изображения не масштабируются и не обрезаются, сохраняется исходное соотношение сторон.
Возможность поиска по аудио в режиме zero-shot: хотя обучающие данные содержат только пары изображение — текст, модель всё же способна выполнять поиск по аудиоконтенту.
Сценарии применения
Поиск по аудио и видео: текстовые запросы для поиска TED-выступлений, аудио для поиска обложек видео на YouTube и т. д.
Вопросно-ответные системы по документам: ответы на вопросы по PDF/изображениям без OCR, с возможностью разбора структуры и графиков.
Образование и исследования: поиск по учебным видео / материалам лекций и проведение кроссмодального анализа.
Анализ развлекательного контента: поиск по коротким видео / подкастам с сохранением эмоций и фоновых звуков.
Сценарии с высокими требованиями к конфиденциальности: возможен локальный запуск в Colab, данные не нужно выгружать.
Ключевые вопросы
Каковы особенности обучающего набора данных ColQwen2.5-Omni?
Обучающий набор данных этой модели содержит 127 460 пар «запрос — страница», из которых 63% — это тренировочные наборы из открытых академических наборов данных, а 37% — синтетические данные (включая PDF-страницы, полученные путём веб-скрапинга, и псевдовопросы, сгенерированные VLM). Набор данных полностью англоязычный, что удобно для исследования возможностей zero-shot-обобщения на неанглийские языки. 2% образцов выделены в валидационный набор для подбора гиперпараметров. Кроме того, многостраничные PDF-документы не используются одновременно в ViDoRe и обучающем наборе, чтобы избежать загрязнения оценки. Предобучающие корпуса языковой модели и данные мультимодального обучения могут содержать многоязычные данные.
Чем ColQwen2.5-Omni отличается от ColPali в обработке изображений?
ColQwen2.5-Omni принимает изображения с динамическим разрешением, не масштабируя их с изменением соотношения сторон, и создаёт до 1024 патчей изображения при максимальном разрешении; ColPali изменяет соотношение сторон изображения.
Как использовать ColQwen2.5-Omni для поиска по аудио?
Сначала установите версию colpali-engine выше 0.3.11 (можно с помощью pip install git+https://github.com/illuin-tech/colpali); затем импортируйте необходимые библиотеки и загрузите модель и процессор; обработайте аудио набор данных и создайте загрузчик данных для генерации векторных представлений аудио; наконец, определите функцию поиска, введите текст запроса, сгенерируйте с помощью модели векторное представление запроса и сравните его с векторными представлениями аудио, чтобы получить результаты top_k, после чего можно отобразить соответствующие аудиофайлы.
Ссылки на проект
Адрес на GitHub: https://github.com/illuin-tech/colpali.
Адрес модели: https://huggingface.co/vidore/colqwen-omni-v0.1.









