
 Помощник сценариста▸
 AI Приложения
 AI Новости
Kyutai TTS: open-source инструмент синтеза речи для реального времени
小编 ·

Kyutai TTS: open-source инструмент синтеза речи для реального времени
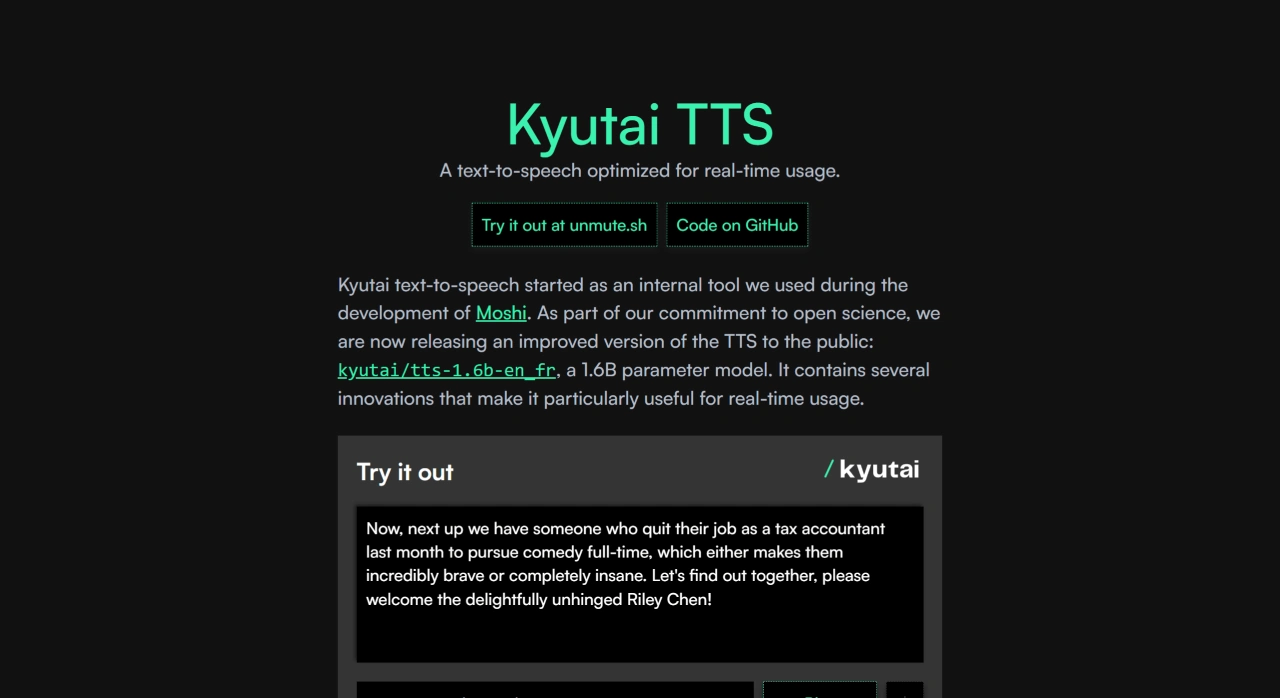
Kyutai TTS — это модель преобразования текста в речь с открытым исходным кодом, разработанная французской лабораторией Kyutai Labs и предназначенная для приложений реального времени. Она содержит 1,6 млрд параметров, частота ошибок на уровне слов для английского и французского языков составляет 2,82% и 3,29% соответственно, а задержка генерации речи — всего 220 миллисекунд, что делает её подходящей для прямых трансляций и голосовых помощников. Технологии потоковой обработки и моделирования с малой задержкой обеспечивают более эффективную генерацию текста и речи.
Технические особенности:
Потоковая обработка и низкая задержка: Kyutai TTS может генерировать аудио сразу после получения первого текстового токена, с задержкой всего 220 миллисекунд. При обработке 32 запросов на GPU NVIDIA L40S задержка составляет около 350 миллисекунд.
Высокоточное распознавание речи: частота ошибок на уровне слов для английского и французского языков составляет 2,82% и 3,29% соответственно, а сходство голоса диктора достигает 77,1% и 78,7% — речь звучит естественно и близко к исходным образцам.
Генерация длинного контента: модель способна обрабатывать длинные тексты, преодолевая традиционное для TTS-моделей ограничение в 30 секунд.
Клонирование голоса: пользователь предоставляет 10-секундный аудиообразец, и модель способна воспроизвести тембр, интонацию и другие характеристики голоса говорящего. В целях соблюдения правовых норм Kyutai TTS предоставляет голосовую библиотеку на основе открытых наборов данных и не публикует напрямую модели голосовых эмбеддингов.
Временны́е метки слов: каждое слово в сгенерированном аудио имеет точную временну́ю метку, что удобно для генерации субтитров в реальном времени или для интерактивных приложений.
Архитектура и обучение:
Моделирование с задержкой потока (DSM): модель генерирует речь в реальном времени по мере поступления текста, поддерживает потоковый ввод текста и способна одновременно обрабатывать несколько запросов.
Обучающие данные и оборудование: модель обучена на 2,5 миллионах часов открытых аудиоданных с использованием транскрипций, сгенерированных Whisper; для обучения использовались 32 GPU H100.
Сценарии применения:
Взаимодействие в реальном времени: подходит для виртуальных ассистентов, образовательных онлайн-платформ и генерации субтитров в реальном времени.
Создание контента: может использоваться для создания подкастов, аудиокниг и другого длинного контента.
Вспомогательные инструменты: обеспечивает высококачественное чтение текста для людей с нарушениями зрения.
Сравнение с другими TTS:
По сравнению с другими TTS-моделями на рынке Kyutai TTS демонстрирует отличные показатели по частоте ошибок на уровне слов и сходству голоса диктора, особенно в сценариях взаимодействия в реальном времени.
Kyutai TTS распространяется с открытым исходным кодом под лицензией CC-BY-4.0; исходный код и веса доступны на GitHub и Hugging Face. Разработчики могут помочь расширить голосовые стили и языковую поддержку модели, жертвуя голосовые данные.
Адрес проекта: https://kyutai.org/next/tts









