
 Помощник сценариста▸
 AI Приложения
 AI Новости
X-UniMotion: видеомодель, воспроизводящая детализированные движения рук
小编 ·

X-UniMotion: видеомодель, воспроизводящая детализированные движения рук
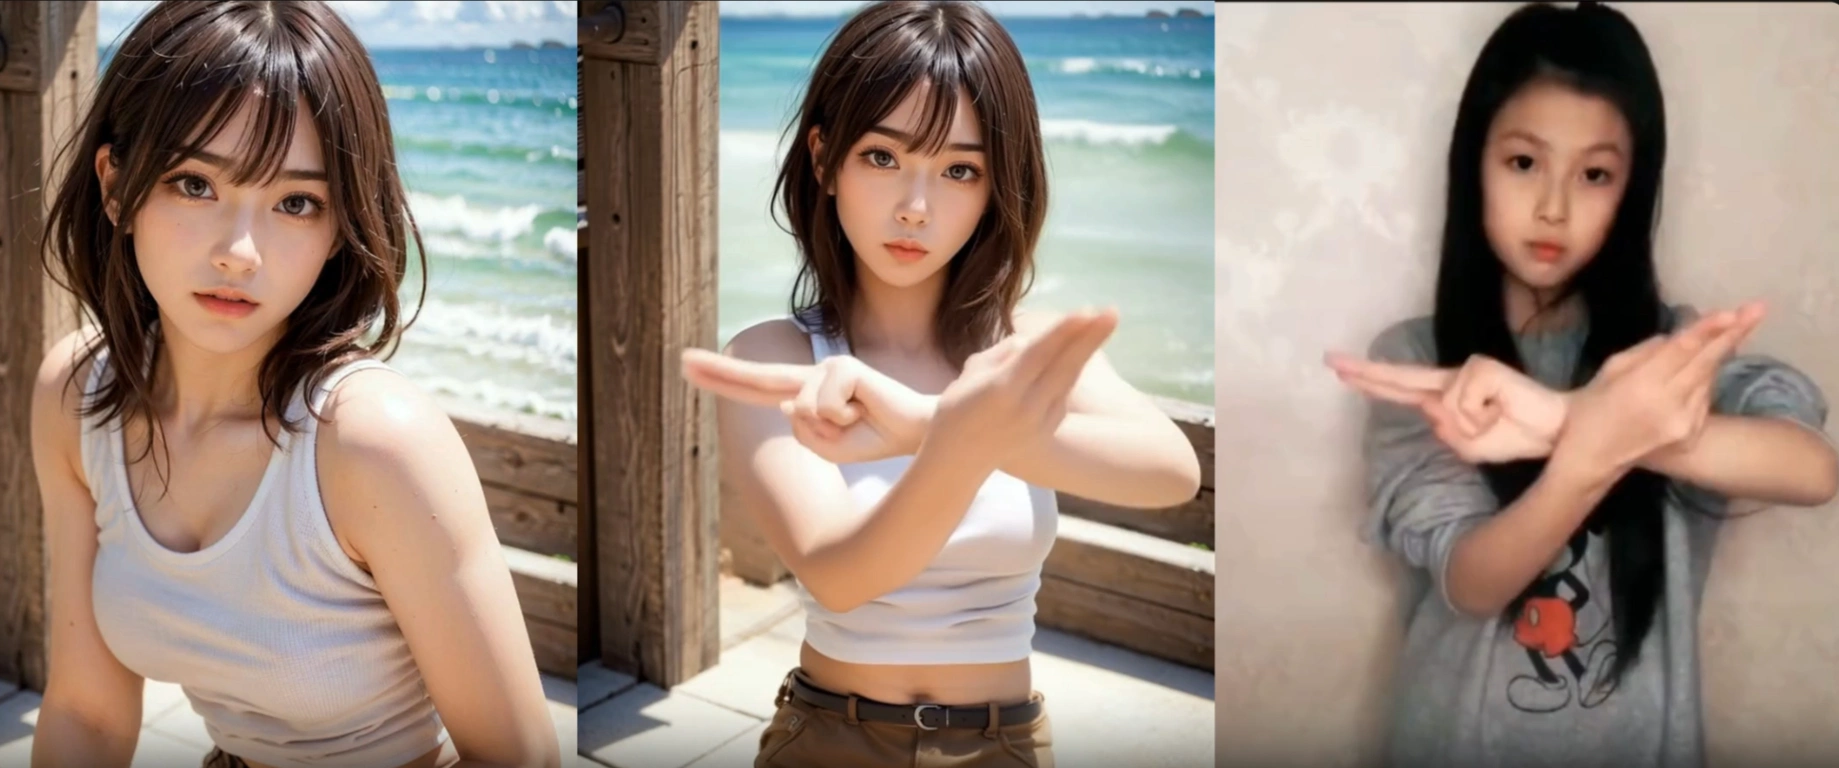
X-UniMotion — это модель видео, способная воспроизводить движения рук. Принимая на вход изображение эталонного человека и видео с движениями, она позволяет эталонному человеку точно выполнять те же движения, что особенно подходит для сложных манипуляций руками. Её ключевое техническое преимущество — высокая детализация воспроизведения движений рук, а также точность и плавность действий.
Функциональные особенности
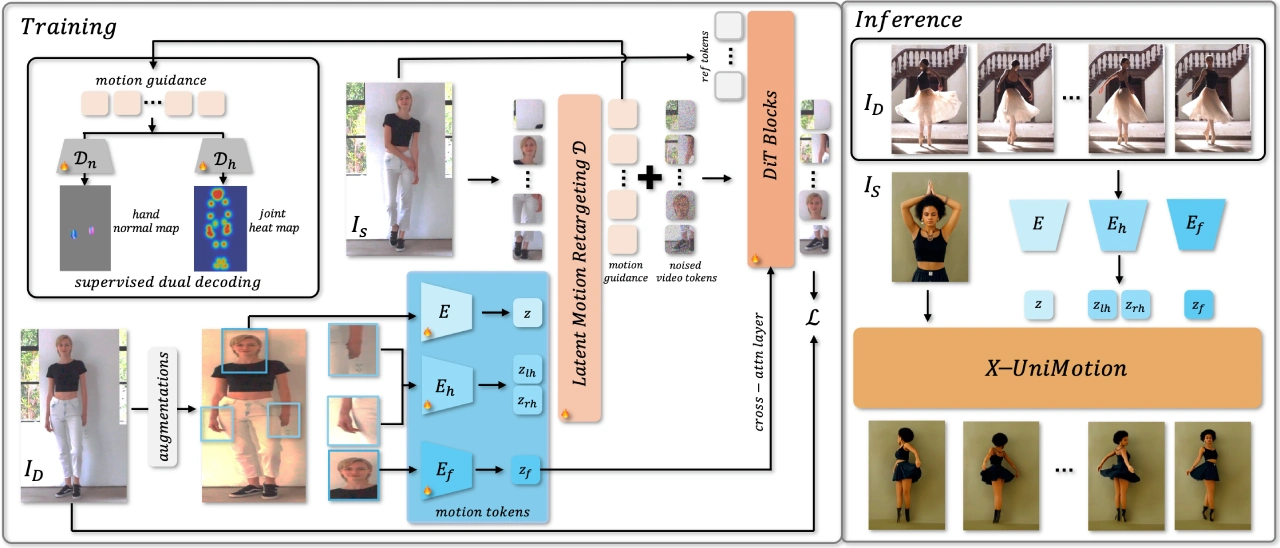
Сквозное обучение: X-UniMotion обучается сквозным образом, изучая латентное представление движений всего тела и генерируя реалистичное видео с помощью сети DiT.
Точный захват движений: способна точно улавливать локальные детализированные движения, такие как движения рук и лица.
Представление, не зависящее от идентичности: за счёт пространственного и цветового расширения разделяет идентификационные признаки и латентные движения, обеспечивая независимое от идентичности представление движений.
Генерация высококачественной анимации: создаваемая анимация реалистична, движения согласованы и в высокой степени соответствуют эталонному изображению.
Технология X-UniMotion
Кодировщик изображений: извлекает из эталонного изображения латентные дескрипторы движений суставов всего тела, а также локальные дескрипторы рук и лица.
Декодер ViT: переносит дескрипторы движений на структуру тела эталонного субъекта, выдавая пространственные управляющие сигналы движения.
Сеть DiT: объединяет пространственные управляющие сигналы движения, латентное представление зашумлённого видео и латентное представление эталонного изображения для генерации итоговой анимации.
Слой перекрёстного внимания: внедряет латентное представление движений лица в сеть DiT, обеспечивая управление мимикой.
Сценарии применения
Кинопроизводство: используется для генерации анимации движений персонажей, снижая затраты и повышая качество спецэффектов.
Создание анимации: быстрая генерация высококачественных анимационных фрагментов, повышение эффективности производства.
Разработка игр: делает движения игровых персонажей более естественными и реалистичными, усиливая эффект погружения.
Онлайн-образование: создание детализированных демонстрационных видео движений, помогающих в обучении ремёслам, игре на музыкальных инструментах и т. д.
Виртуальные лаборатории: моделирование экспериментальных операций для помощи в обучении студентов.
Изучение языков: создание обучающих видео с языком жестов (например, жестовым языком), помогающих учащимся в обучении.
Реабилитационные тренировки: создание видео с реабилитационными упражнениями, помогающих пациентам в восстановлении подвижности рук и мимики.
Хирургическое моделирование: создание детализированных видео хирургических операций, помогающих врачам осваивать хирургические техники.
Психотерапия: создание видео с выражениями лица и движениями, помогающих пациентам учиться распознавать и выражать эмоции.
Виртуальные ассистенты: создание анимации движений виртуальных ассистентов, повышающей естественность взаимодействия.
VR/AR: создание анимации движений виртуальных персонажей, улучшающей интерактивный опыт в виртуальных средах.
Распознавание жестов: генерация детализированных образцов движений рук для обучения моделей распознавания жестов.
Инструкция по использованию
Входные данные: требуется одно эталонное изображение и одно видео с движениями.
Извлечение дескрипторов движений: из эталонного изображения извлекаются латентные дескрипторы движений суставов всего тела, а также локальные дескрипторы рук и лица.
Перенос движений: дескрипторы движений переносятся на структуру тела эталонного субъекта.
Генерация анимации: управляющие сигналы движения, латентное представление зашумлённого видео и латентное представление эталонного изображения объединяются и подаются в модель DiT для генерации анимации.
Управление мимикой: латентное представление движений лица внедряется в сеть DiT, обеспечивая управление выражениями лица.









