
 Помощник сценариста▸
 AI Приложения
 AI Новости
XVerse: open-source инструмент ByteDance для синтеза изображений с несколькими субъектами
小编 ·

XVerse: open-source инструмент ByteDance для синтеза изображений с несколькими субъектами
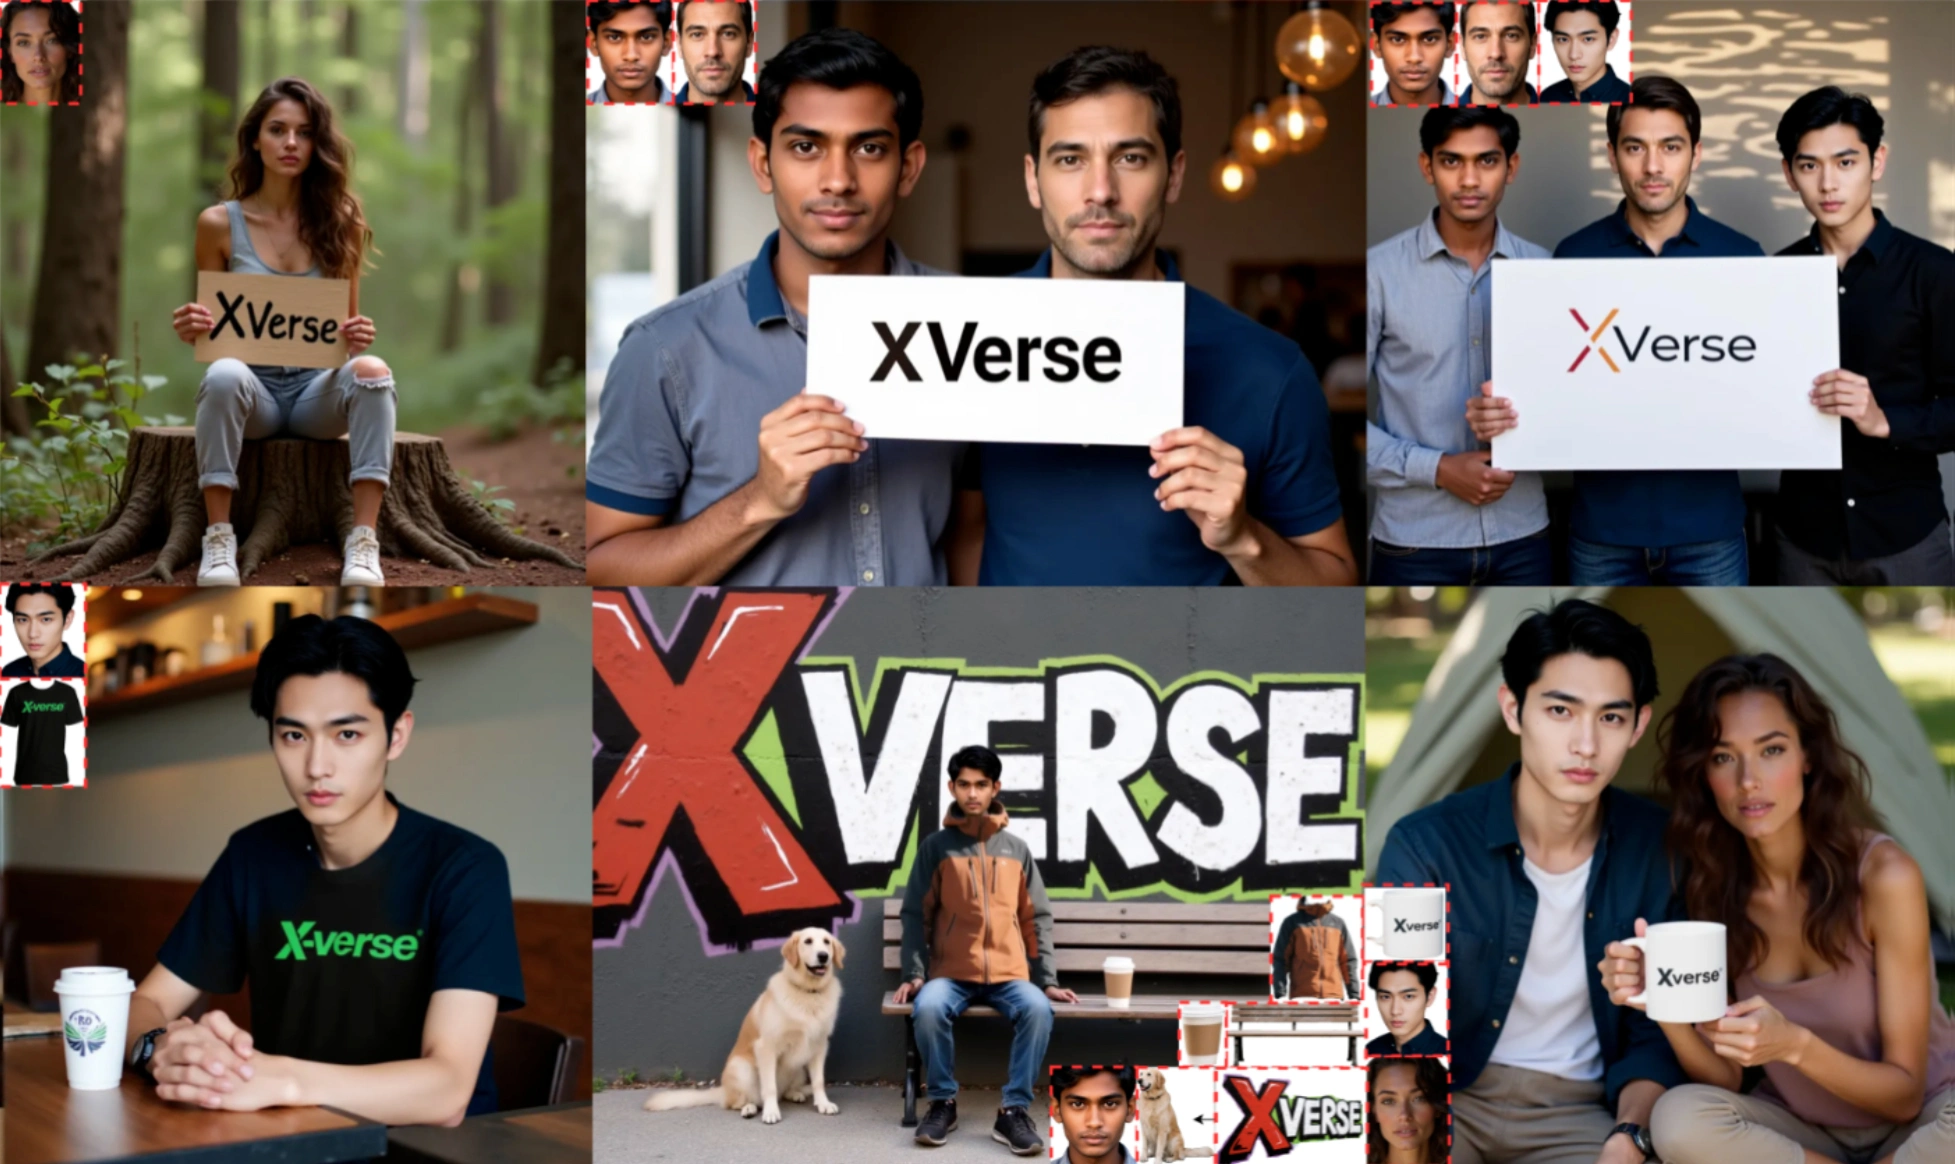
XVerse — это ByteDance推出的多主体图像合成инструмент, который позволяет осуществлять высокоточную генерацию изображений с несколькими объектами. Он обеспечивает независимое и точное управление несколькими объектами со стороны пользователя, что значительно повышает возможности генерации сложных сцен.
Основные функции
Управление несколькими объектами: XVerse преобразует референсные изображения в смещения, модулированные потоком текста, что позволяет точно контролировать характеристики идентичности каждого объекта и независимо настраивать семантические атрибуты (позу, стиль, освещение и т. д.). Это решает распространённые проблемы традиционных моделей в сценах с несколькими объектами, такие как путаница идентичности и запутывание атрибутов, обеспечивая высококачественный и редактируемый синтез изображений с несколькими объектами.
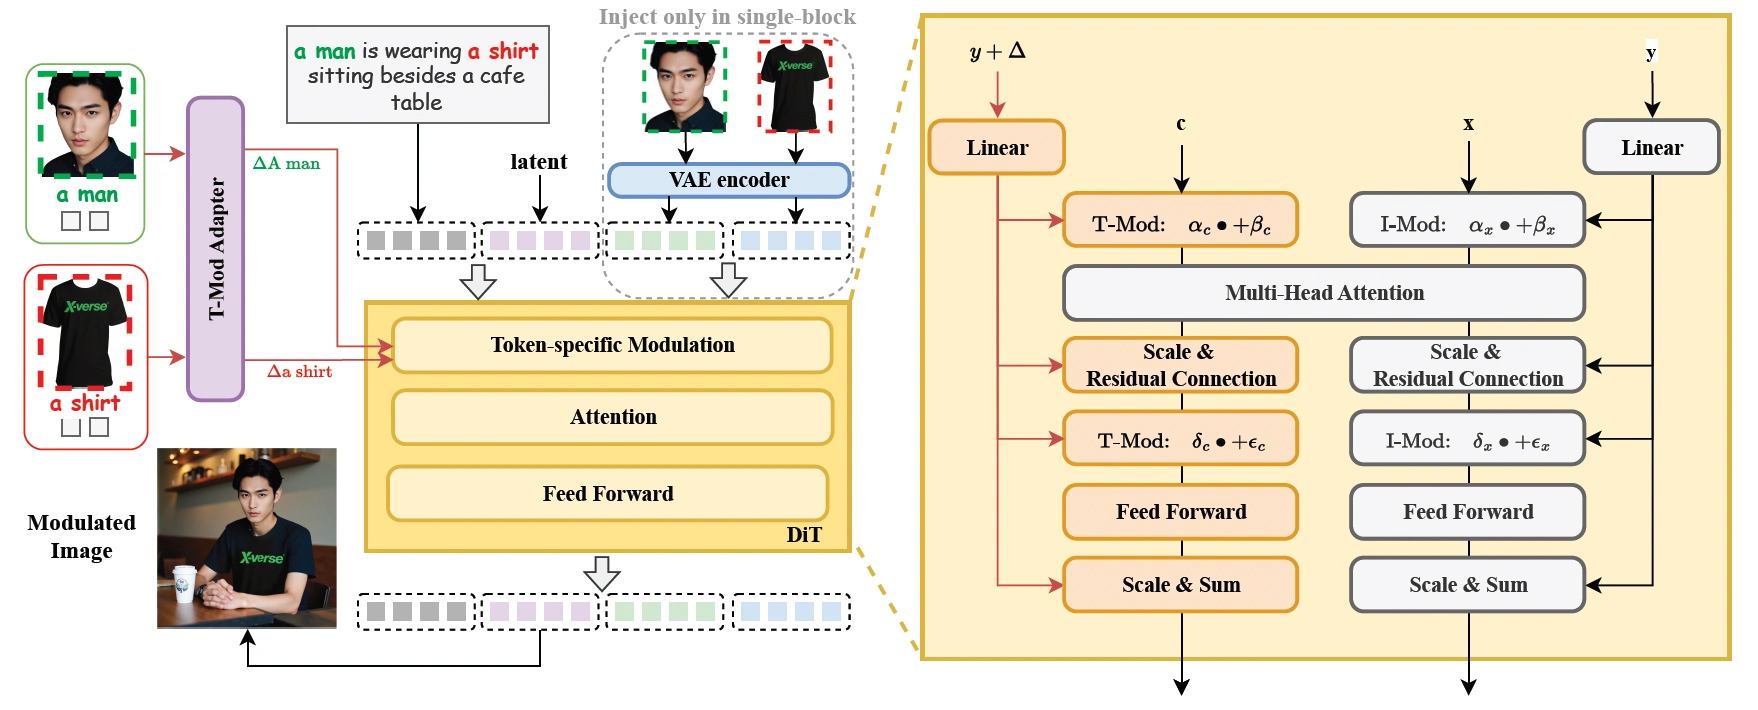
Усиление за счёт модуляции потоком текста: объединяя признаки референсных изображений с признаками текстовых подсказок для генерации смещений и внедряя их в эмбеддинги определённых текстовых токенов, XVerse обеспечивает точный контроль над каждым объектом, сохраняя при этом общую структуру сгенерированного изображения и позволяя тонко настраивать детали.
VAE-кодирование признаков изображений: XVerse вводит закодированные с помощью VAE признаки изображений в качестве вспомогательного входа в отдельные блоки DiTs. Это помогает захватывать и воспроизводить детали информации об изображении, избегая артефактов и снижения качества, которые могут возникнуть при прямом внедрении признаков изображений.
Методы регуляризации: используется региональная сохраняющая потеря, которая заставляет модель поддерживать согласованность в немодулированных областях, различая и сохраняя характеристики разных объектов. С помощью потери внимания «текст-изображение» выравниваются карты перекрёстного внимания между модулированной моделью и референсной ветвью T2I, что обеспечивает согласованность и редактируемость семантического взаимодействия в процессе модуляции.
Технические принципы XVerse
Механизм модуляции потоком текста: XVerse преобразует референсные изображения в специфичные для токенов смещения модуляции потоком текста, которые добавляются в текстовые эмбеддинги модели, что обеспечивает точный контроль над конкретными объектами без вмешательства в латентные переменные или признаки изображения.
Модуль VAE-кодирования признаков изображений: для повышения способности сохранять детали сгенерированного изображения XVerse вводит модуль VAE-кодирования признаков изображений. Этот модуль выступает в качестве вспомогательного компонента, помогающего модели сохранять больше деталей в процессе генерации и уменьшать артефакты и искажения.
Методы регуляризации: на основе случайного сохранения модуляции на одной стороне модель принуждается поддерживать согласованность в немодулированных областях. Регуляризуются характеристики, специфичные для конкретного объекта, что служит стратегией аугментации данных для наборов данных с несколькими объектами и повышает способность модели различать и сохранять характеристики объектов в сценах с несколькими объектами. Вычисление L2-потери карт перекрёстного внимания «текст-изображение» между модулированной моделью и референсной ветвью T2I обеспечивает соответствие паттернов внимания модулированной модели паттернам ветви T2I, сохраняя тем самым согласованность и редактируемость семантического взаимодействия.
Сценарии применения
Создание цифрового контента: XVerse помогает создателям легко реализовать точный контроль над несколькими объектами. Инструмент можно использовать для рисования комиксов, создания иллюстраций к рассказам, построения сложных виртуальных сцен и т. д., делая произведения более живыми, насыщенными и выразительными.
Рекламная индустрия: XVerse способен точно контролировать атрибуты каждого объекта, обеспечивая высокую достоверность и согласованность рекламного изображения, делая рекламу более привлекающей внимание и повышая эффективность её распространения.
Область искусства: предоставляет художникам совершенно новый инструмент для творчества, позволяющий преодолевать ограничения традиционного создания произведений и создавать уникальные, выразительные художественные работы.
Как пользоваться XVerse
Пользователю необходимо создать conda-окружение с Python 3.10.16, установить зависимости, а также загрузить соответствующие чекпойнты и модели распознавания лиц. Интерфейс пользователя дружелюбный и предоставляет множество настроек ввода, включая функцию «обнаружение и сегментация», которая может анализировать загруженные изображения, автоматически обрезать лица и генерировать описания. Кроме того, доступно интерактивное демо на базе Gradio, где пользователи могут загружать изображения, вводить описания и генерировать изображения в реальном времени, оптимизируя результат путём настройки параметров.
Адрес проекта
Официальный сайт проекта:https://bytedance.github.io/XVerse/
Репозиторий на GitHub:https://github.com/bytedance/XVerse
Модель на HuggingFace:https://huggingface.co/ByteDance/XVerse
Техническая статья на arXiv:https://arxiv.org/pdf/2506.21416









