
 Помощник сценариста▸
 AI Приложения
 AI Новости
Alibaba Ovis-U1: модель, объединяющая мультимодальное понимание, генерацию и редактирование изображений
小编 ·

Alibaba Ovis-U1: модель, объединяющая мультимодальное понимание, генерацию и редактирование изображений
29 июня 2025 года команда международного подразделения Alibaba ai выпустила мультимодальную большую модель Ovis-U1 — новейшую версию серии Ovis, разработанную на базе原有 архитектуры с количеством параметров 300 миллионов.
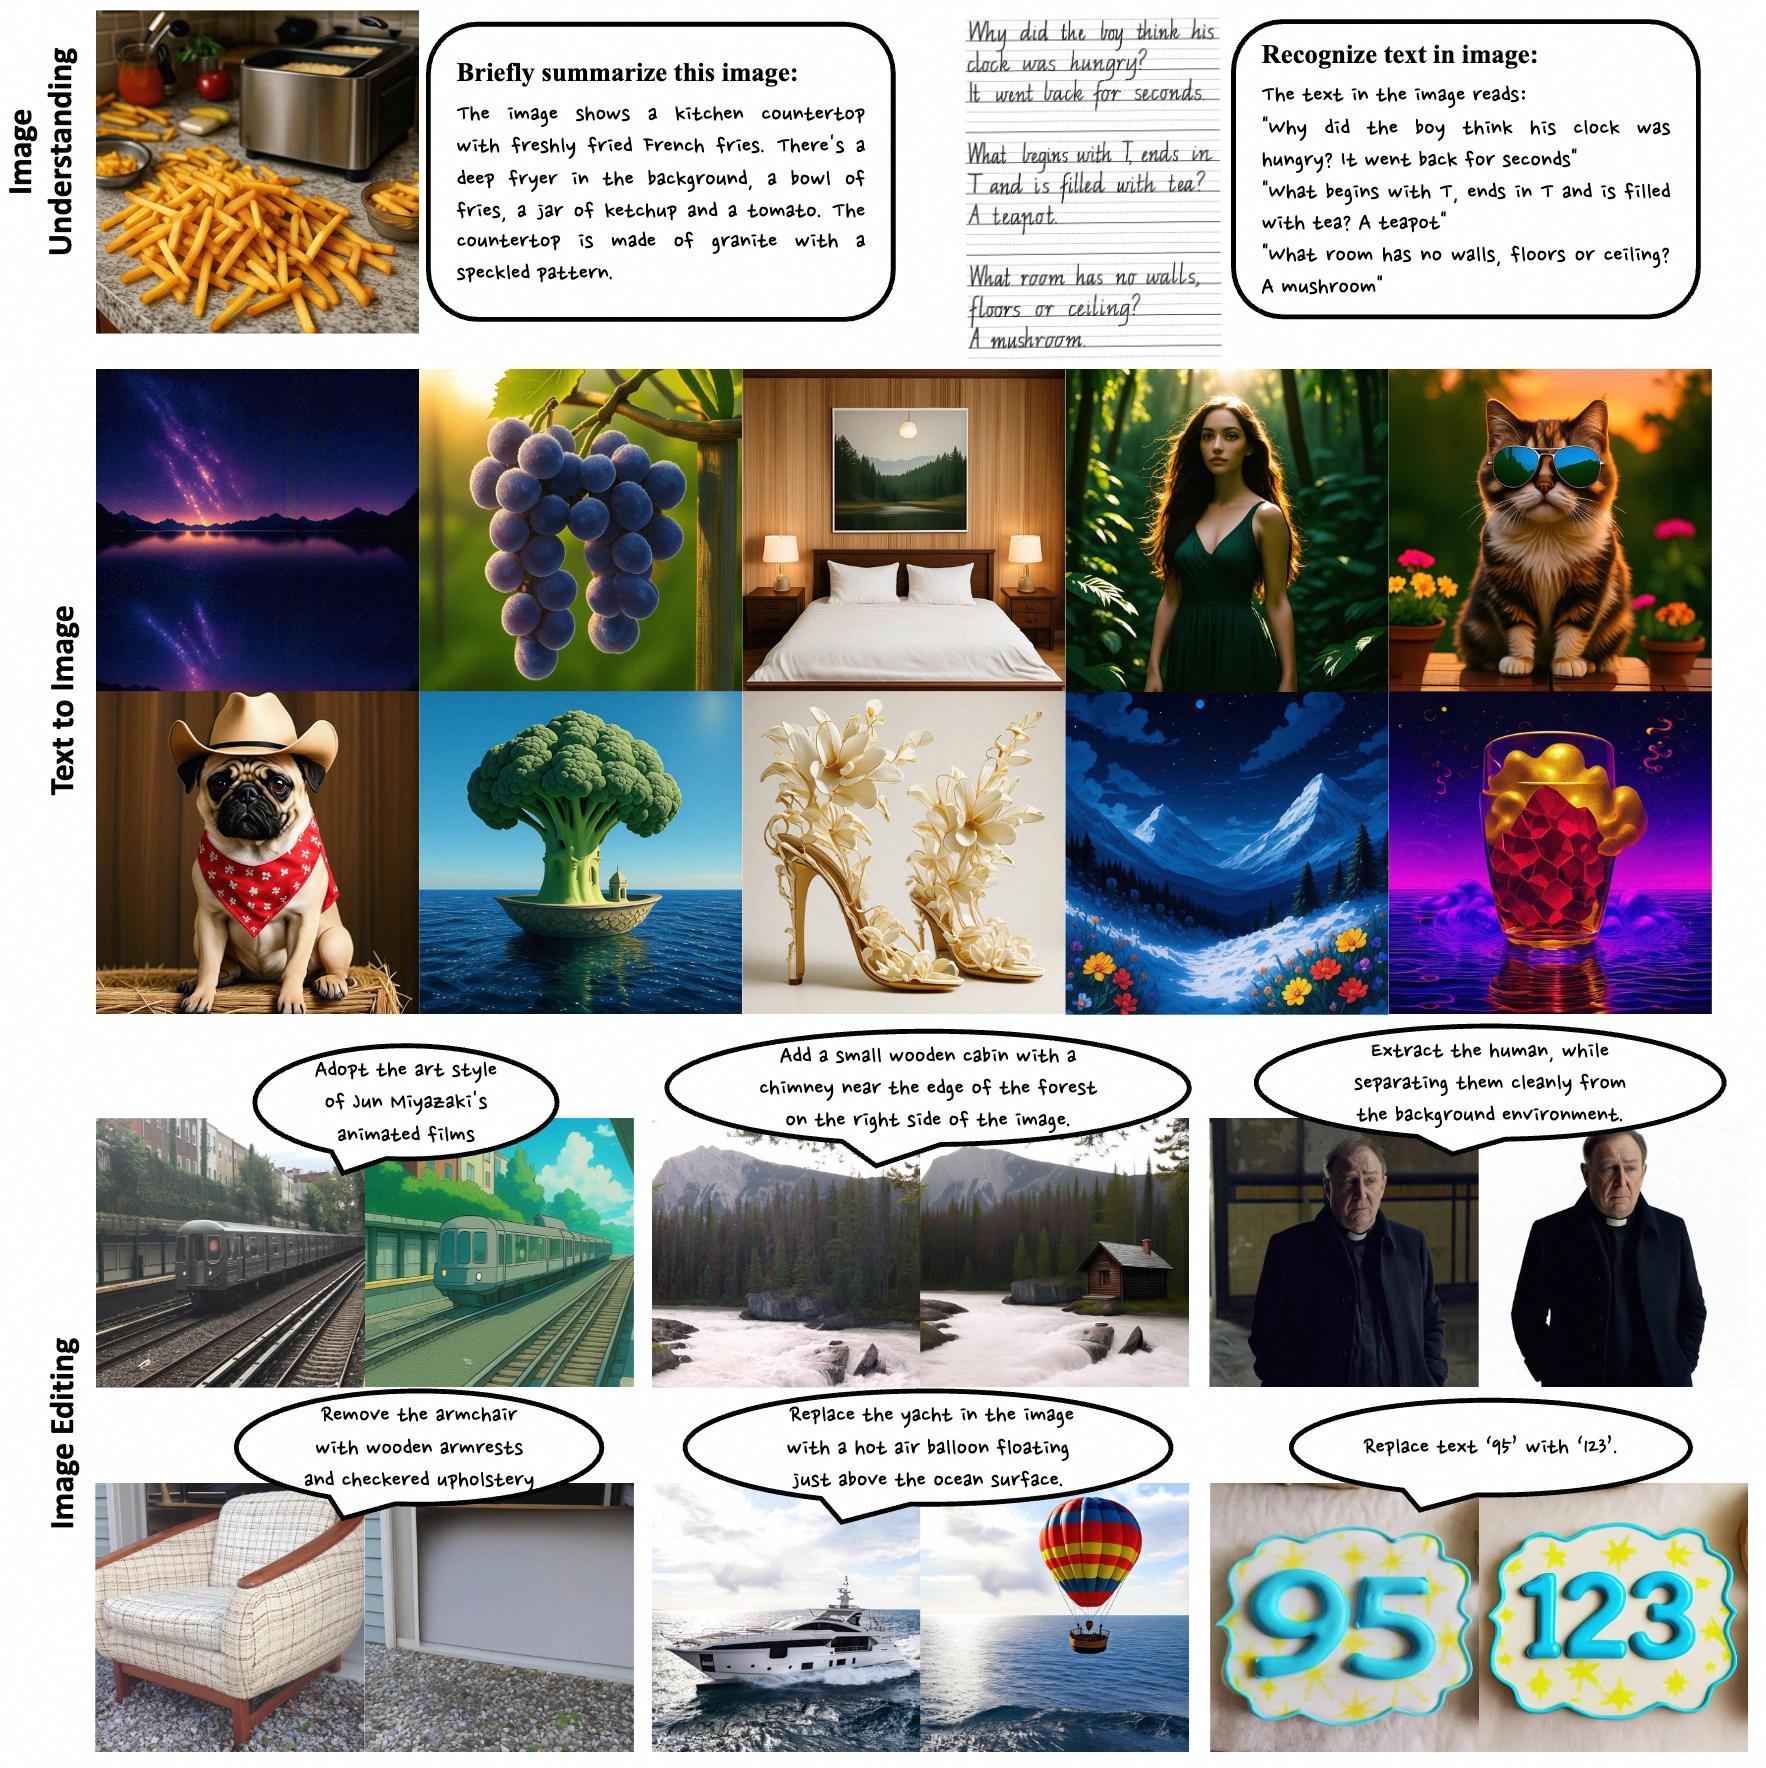
Модель объединяет функции мультимодального понимания, генерации и редактирования изображений, основными компонентами являются визуальный токенизатор, таблица визуальных эмбеддингов и большая языковая модель. За счёт оптимизации согласования визуальных и текстовых эмбеддингов были устранены некоторые ограничения традиционных мультимодальных моделей, что обеспечивает лучшую производительность в сложных сценариях. Поддерживается ввод текста и изображений, модель показывает выдающиеся результаты в задачах математического рассуждения, распознавания объектов и других, способна точно распознавать объекты или рукописный текст на изображениях, а также генерировать или изменять изображения по инструкциям.
Ключевые возможности
Мультимодальное понимание: анализ сложных визуальных сцен и текстового содержимого, ответы на вопросы по изображениям, выполнение задач визуального вопросно-ответного взаимодействия (VQA), генерация описаний изображений и других задач.
Генерация изображений по тексту: создание высококачественных изображений по текстовым описаниям, адаптация к различным стилям и сложным сценариям.
Редактирование изображений: добавление, корректировка, замена, удаление элементов изображений и преобразование стилей с помощью текстовых инструкций.
Техническая архитектура
Визуальный декодер: использует архитектуру Transformer на основе диффузии (MMDiT) для преобразования текстовых эмбеддингов в высококачественные изображения.
Двунаправленный уточнитель токенов: усиливает взаимодействие текстовых и визуальных эмбеддингов, повышая качество синтеза и редактирования изображений.
Визуальный кодировщик: дообучен на базе предварительно обученных моделей (например, Aimv2-large-patch14-448) для задач мультимодального типа.
Адаптер: соединяет визуальный кодировщик с мультимодальной большой языковой моделью (MLLM), согласовывая данные двух типов эмбеддингов.
Мультимодальная большая языковая модель: выступает основным модулем, обрабатывающим текстовую и визуальную информацию и поддерживающим многозадачную обработку.
Методы обучения
Ovis-U1 обучается с одновременным выполнением задач мультимодального понимания, генерации и редактирования изображений, разделяя знания для повышения способности к обобщению. Обучение проводится в шесть этапов с постепенной оптимизацией показателей по каждой задаче.
Состав данных
Данные для мультимодального понимания: взяты из открытых наборов данных COYO, Wukong, Laion и внутренних разработанных данных.
Данные для генерации изображений: подробные описания, созданные на основе наборов данных Laion5B, JourneyDB и предварительно обученных моделей.
Данные для редактирования изображений: включают данные для задач генерации на основе референсных изображений, попиксельного управления и других.
Оптимизация производительности
В задачах редактирования изображений точное управление выполнением инструкций достигается за счёт настройки коэффициентов направляющего воздействия текста и изображения (CFG). Для всесторонней оценки возможностей модели используются бенчмарки OpenCompass, GenEval и другие.
Сценарии применения
Создание контента: помощь художникам и редакторам видео в генерации творческих идей.
Реклама и маркетинг: создание рекламных изображений и плакатов на основе описаний продукта и целевой аудитории.
Разработка игр: генерация изображений игровых сцен, персонажей и реквизита.
Архитектурное проектирование: создание архитектурных концепт-артов и схем интерьеров.
Научные исследования: визуализация сложных научных явлений и экспериментальных сценариев.
Продолжая традиции открытого исходного кода серии Ovis, код модели, веса и обучающие данные опубликованы под лицензией Apache 2.0 на Hugging Face и GitHub, что позволяет разработчикам быстро воспроизвести и развернуть модель.
Адреса проекта
Репозиторий GitHub: https://github.com/AIDC-AI/Ovis-U1
Библиотека моделей HuggingFace: https://huggingface.co/AIDC-AI/Ovis-U1-3B
Техническая статья: https://github.com/AIDC-AI/Ovis-U1/blob/main/docs/Ovis_U1_Report.pdf
Онлайн-демо: https://huggingface.co/spaces/AIDC-AI/Ovis-U1-3B









