
 Помощник сценариста▸
 AI Приложения
 AI Новости
DreamActor-H1: генерация видео с людьми, представляющими товары, для рекламных роликов
小编 ·

DreamActor-H1: генерация видео с людьми, представляющими товары, для рекламных роликов
DreamActor-H1 — это фреймворк для генерации видео, выпущенный ByteDance в июне 2025 года. Он основан на технологии диффузионного трансформера (DiT) и в первую очередь ориентирован на сферу электронной коммерции и цифрового маркетинга. Фреймворк может использоваться для создания рекламных видеороликов с демонстрацией товаров.
Этот фреймворк способен на основе пар изображений человека и продукта генерировать высококачественные видеоролики с демонстрацией человека и товара. Благодаря обучению с использованием многокатегорийного расширения на крупномасштабном смешанном наборе данных, он превосходит существующие методы в сохранении идентичности человека и продукта, а также в генерации физически правдоподобных демонстрационных движений, что делает его подходящим для персонализированной рекламы в электронной коммерции и интерактивных медиа. Используя 3D-шаблон сетки тела и ограничивающие рамки продукта для точного управления движением, в сочетании с управлением внешним видом через VAE-кодирование, структурированным текстовым кодированием категорийно-уровневой семантики, а также механизмами внимания к референсу и внимания к объекту, он решает проблемы существующих фреймворков в сохранении идентичности и понимании пространственных связей.
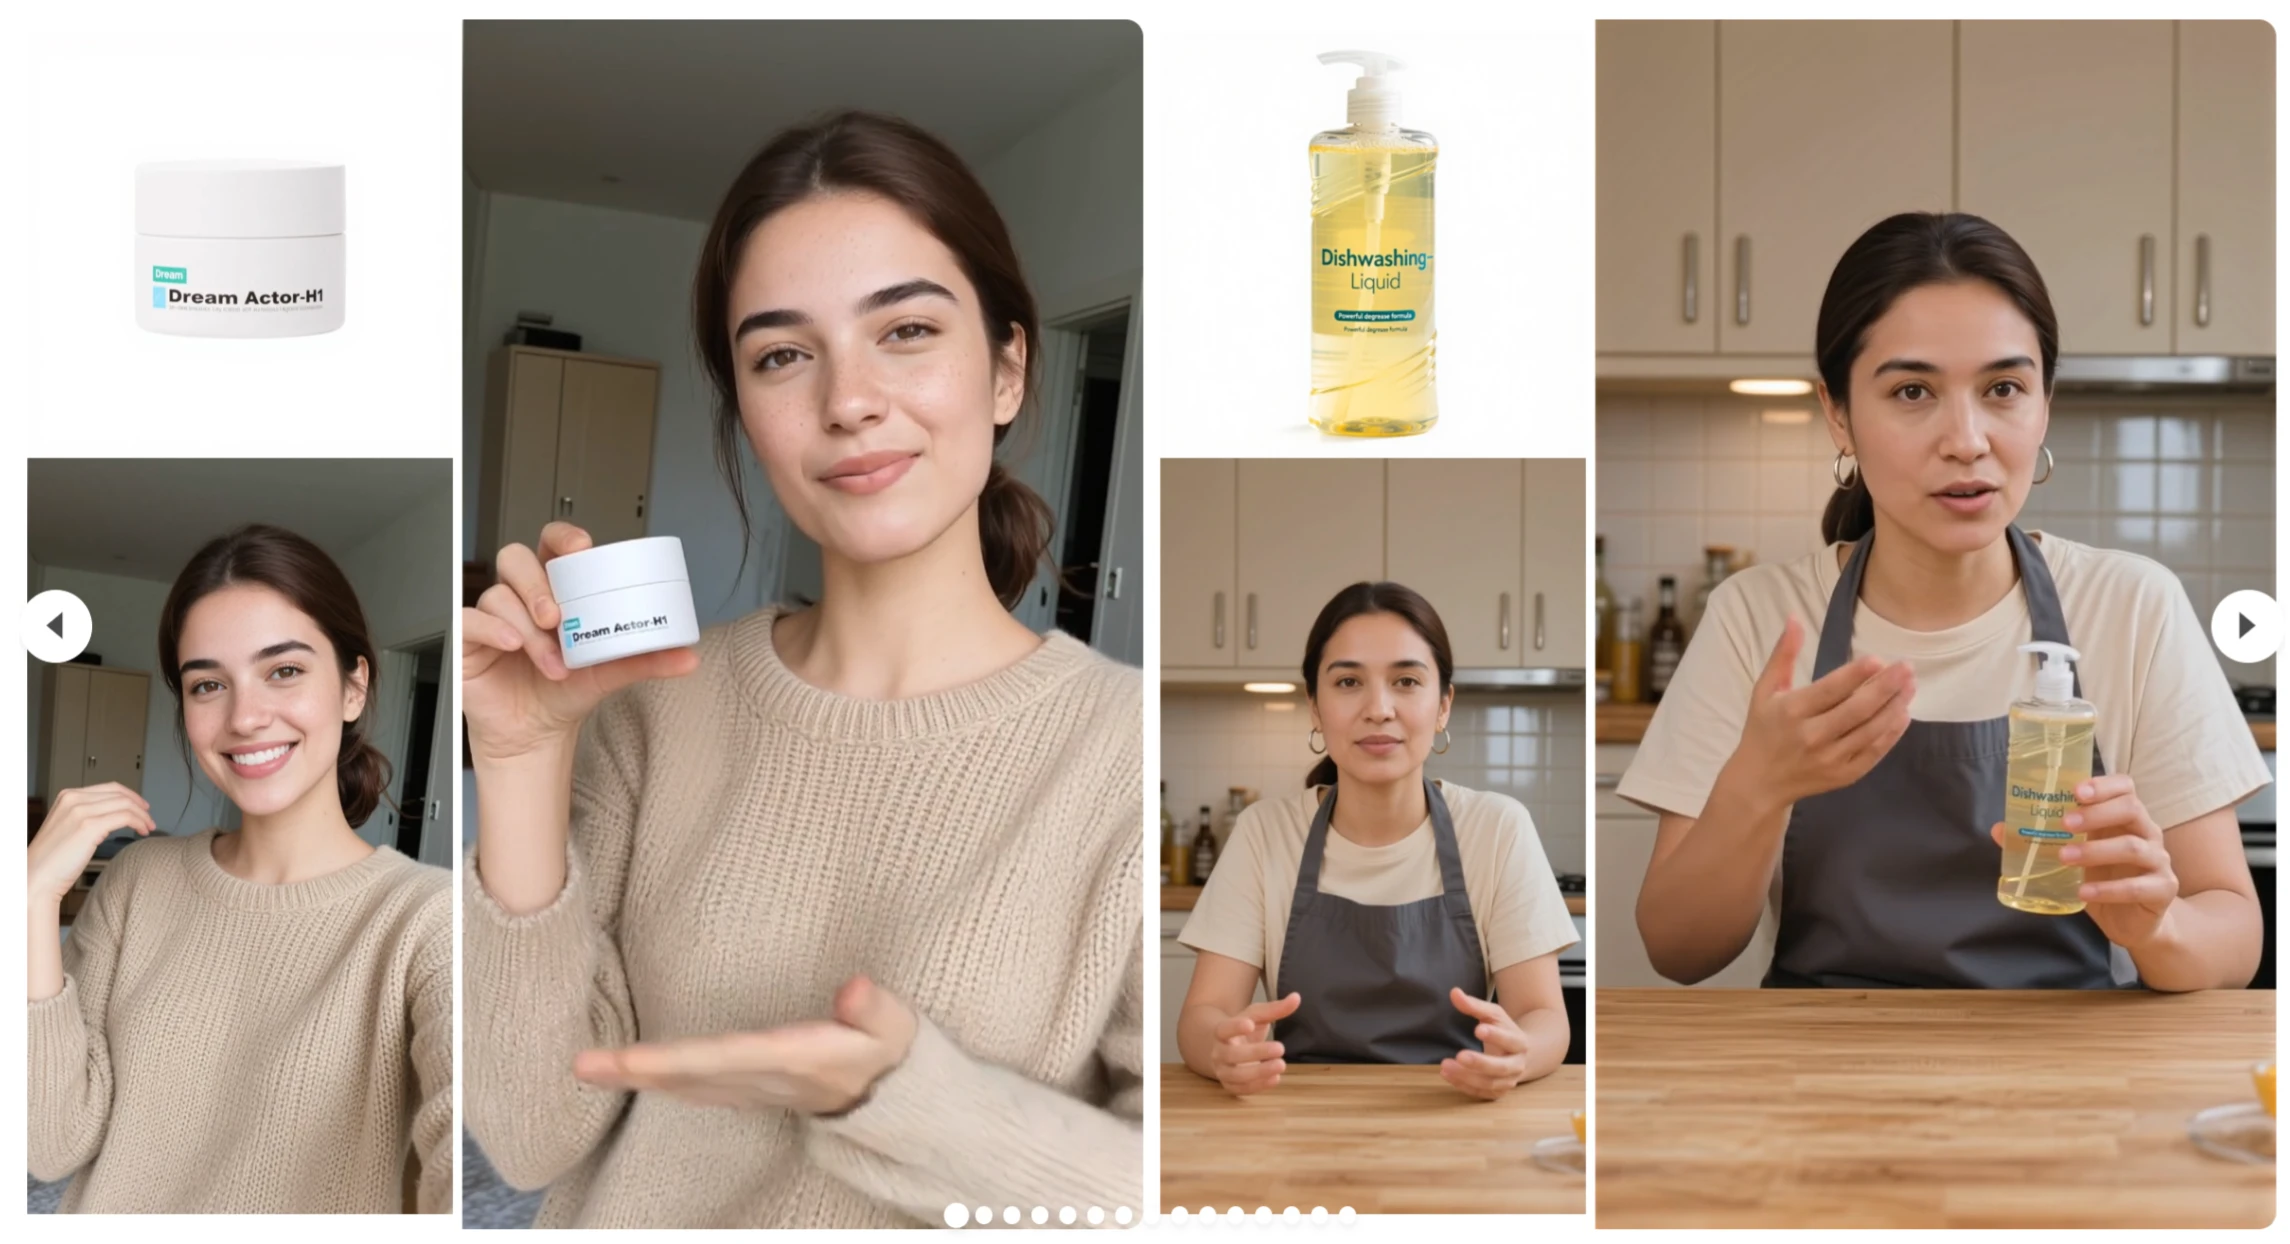
Основные преимущества DreamActor-H1:
Динамическое согласование человек-объект: он автоматически сопоставляет жесты с положением товара. Например, при демонстрации «взятия косметики» точки контакта пальцев и флакона выглядят естественно, без артефактов проникновения или смещений. Кроме того, поддерживается совместное управление с использованием 3D-шаблона сетки тела и ограничивающих рамок продукта, что обеспечивает соответствие движений физическим законам, таким как гравитация и угол захвата.
Многомерная детальная достоверность: при сохранении идентичности человека удаётся сохранять такие черты, как причёска и цвет кожи; для товара обеспечивается высокая степень воспроизведения, точно отображаются текстуры материалов, логотипы и другие детали.
Семантически усиленная трёхмерная согласованность: в сочетании с категорийно-уровневыми текстовыми описаниями, такими как «вращение помады для демонстрации», картинка при небольших вращениях получается более плавной, без дрожания или деформации товара.
Технические принципы:
Этап обработки данных: визуально-языковая модель (VLM) выполняет разбор текстовых инструкций, например «держать телефон и повернуть его». Затем с помощью оценки позы генерируется скелет человека, а в сочетании с ограничивающими рамками товара строится пространственная связь, что позволяет извлекать характеристики движения.
Проектирование архитектуры модели: глобальное внимание отвечает за временну́ю согласованность всей картинки; внимание к референсу внедряет признаки референсного изображения человека или товара; внимание к объекту специально обрабатывает латентные признаки товара, обеспечивая сохранение деталей. Диффузионный трансформер (DiT) с тройным механизмом внимания построен на базовой модели Seaweed-7B с 7 миллиардами параметров и объединяет информацию о человеке и объекте с помощью маскированного перекрёстного внимания.
Оптимизация вывода: выполняется динамический поиск в предопределённой библиотеке шаблонов движений с регулировкой масштаба ограничивающей рамки объекта, например, рамка для товара небольшого размера может быть увеличена.
Сценарии применения DreamActor-H1:
Прямые трансляции в электронной коммерции: можно автоматически генерировать видеоролики с виртуальным ведущим, демонстрирующим товар, что снижает затраты на проведение трансляций и повышает их эффективность.
Реклама и маркетинг: позволяет недорого создавать многоракурсные анимации с использованием продукта, например, вращательный показ модели обуви, привлекающие внимание потребителей.
Ограничения DreamActor-H1:
Ограничения по товарам: в настоящее время поддерживаются только товары малого и среднего размера; крупная бытовая техника и подобное не могут быть обработаны.
Зависимость от шаблонов движений: требуется предопределить движение, например «поднять предмет со стола», а также необходимо соответствие начальной позы человека.
Артефакты динамики: при быстром движении возможно мерцание текстуры товара.
Процесс создания рекламного видео с помощью DreamActor-H1:
Подготовка материалов: подготовьте изображение человека и изображение продукта. Для изображения человека рекомендуется выбирать фронтальный портретный снимок по пояс с разрешением более 800×800, чтобы обеспечить чёткость черт человека в сгенерированном видео. Изображение продукта должно чётко отображать все детали товара, такие как логотип и текстура.
Ввод текстовой инструкции: в соответствии с потребностями рекламной демонстрации введите соответствующее категорийно-уровневое текстовое описание, например «держать телефон и повернуть его», «показать детали помады» и т. д., чтобы задать генерации видео конкретные действия и требования к показу.
Генерация видео: введите подготовленные материалы и текстовые инструкции в систему DreamActor-H1, которая обработает их на основе многоэтапной совместной архитектуры и механизма смешанного внимания. На этапе обработки данных визуально-языковая модель (VLM) разбирает текстовые инструкции, а модуль извлечения характеристик движения с помощью оценки позы генерирует скелет человека и в сочетании с ограничивающими рамками товара строит пространственные связи; в архитектуре модели совместно работают глобальное внимание, внимание к референсу и внимание к объекту, и в итоге генерируется высокодетализированное видео с демонстрацией взаимодействия человека и товара.
Адреса проекта:
Домашняя страница проекта:https://submit2025-dream.github.io/DreamActor-H1/
Техническая статья:https://arxiv.org/abs/2506.10568









