
 Помощник сценариста▸
 AI Приложения
 AI Новости
TableRAG: фреймворк генерации с расширенным поиском, созданный специально для понимания таблиц
小编 ·

TableRAG: фреймворк генерации с расширенным поиском, созданный специально для понимания таблиц
TableRAG — это фреймворк, предназначенный для решения проблем потери структурной информации и отсутствия глобального представления при ответах на вопросы по гетерогенным документам. Он объединяет выполнение SQL и текстовый поиск, обеспечивая единое понимание табличных данных и возможность выполнения сложных операций. Фреймворк включает автономное построение базы данных и четырёхэтапный процесс итеративного онлайн-вывода. На новом бенчмарке HeteQA и других общедоступных бенчмарках TableRAG демонстрирует превосходные результаты, превосходя существующие методы RAG и программные подходы, и становится передовым решением для обработки сложного логического вывода по гетерогенным документам.
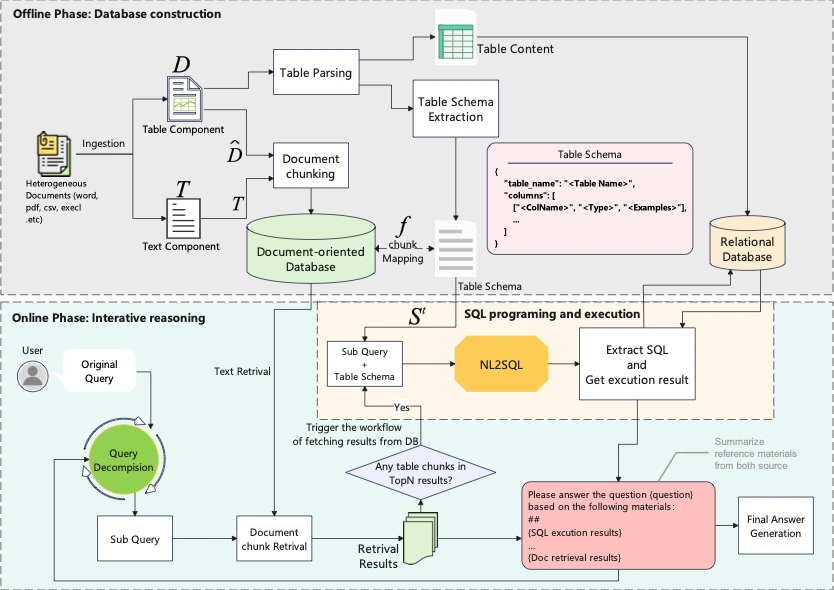
Основные принципы
Расширение запроса и поиск: TableRAG определяет ключевую информацию в таблице с помощью расширения запроса, поиска по схеме и поиска по ячейкам. Он генерирует отдельные запросы для значений схемы и ячеек, избегая избыточной информации, характерной для единого запроса.
Поиск по схеме: ai языковая модель может распознавать ключевые столбцы и их типы данных по именам столбцов без кодирования всего столбца. Например, для вопроса «Какова средняя цена кошелька?» языковая модель сгенерирует запросы по именам столбцов, такие как «продукт» и «цена».
Поиск по ячейкам: на основе запросов, сгенерированных языковой моделью, выполняется поиск имён столбцов и ячеек, относящихся к вопросу. Например, поиск значений ячеек, связанных со словом «кошелёк».
Усечение с учётом частотности: вводится бюджет кодирования ячеек B; если количество различных значений превышает B, кодируются только B наиболее часто встречающихся значений.
Основные модули TableRAG
online_inference/main.py: основной код вывода TableRAG, содержащий класс TableRAG, реализующий главную логику онлайн-вывода.
offline_data_ingestion_and_query_interface/src/interface.py: использует фреймворк Flask для предоставления интерфейса SQL-запросов.
online_inference/tools/sql_tool.py: содержит функции-инструменты для генерации и выполнения SQL, поддерживает механизм повторных попыток.
offline_data_ingestion_and_query_interface/src/sql_alchemy_helper.py: предоставляет вспомогательный класс для операций с базой данных SQLAlchemy, поддерживающий вставку и запрос данных.
offline_data_ingestion_and_query_interface/src/service.py: содержит основную логику обработки запросов TableRAG, включая получение SQL-операторов от LLM и их выполнение.
online_inference/chat_utils.py: содержит служебные функции для получения результатов генерации LLM, поддерживающие различные серверные API.
offline_data_ingestion_and_query_interface/src/data_persistent.py: содержит служебные функции для очистки имён столбцов DataFrame.
offline_data_ingestion_and_query_interface/src/handle_requests.py: вызывает интерфейс вывода большой модели, включает перехват исключений и механизм повторных попыток с экспоненциальной задержкой.
online_inference/tools/retriever.py: реализует функции семантического поиска и гибридного поиска по документам, включая отзыв и повторное ранжирование.
Преимущества
Эффективное кодирование данных: благодаря поиску по схеме и поиску по ячейкам TableRAG сокращает длину входных данных для языковой модели, делая её независимой от размера таблицы, повышает эффективность кодирования и снижает вычислительные затраты.
Уменьшение потери информации: языковой модели предоставляются только найденные схема и ячейки, что позволяет избежать потери ключевой информации, возникающей при обработке всей таблицы.
Повышение возможностей логического вывода: TableRAG расширяет способность языковой модели к логическому выводу по таблицам, предоставляя ключевую информацию.
Сценарии применения TableRAG
Анализ данных и формирование отчётов: подходит для сценариев, требующих обработки крупномасштабных табличных данных, таких как анализ данных, формирование отчётов и обработка финансовой отчётности.
Кросс-табличные вопросы-ответы: способен обрабатывать задачи проверки фактов на основе таблиц, одношаговые и многошаговые вопросы-ответы по таблицам.
Экспериментальная проверка
Исследователи разработали бенчмарк с миллионным масштабом разметки на основе наборов данных Arcade и BIRD-SQL для оценки производительности TableRAG в задачах крупномасштабного понимания таблиц. Экспериментальные результаты показывают, что TableRAG превосходит существующие методы по качеству поиска и производительности при крупномасштабном понимании таблиц.
Ссылка на проект
Github:https://github.com/yxh-y/TableRAG









