
 Помощник сценариста▸
 AI Приложения
 AI Новости
Nanonets-OCR-s: модель, преобразующая таблицы из изображений в Markdown
小编 ·

Nanonets-OCR-s: модель, преобразующая таблицы из изображений в Markdown
Что такое Nanonets-OCR-s?
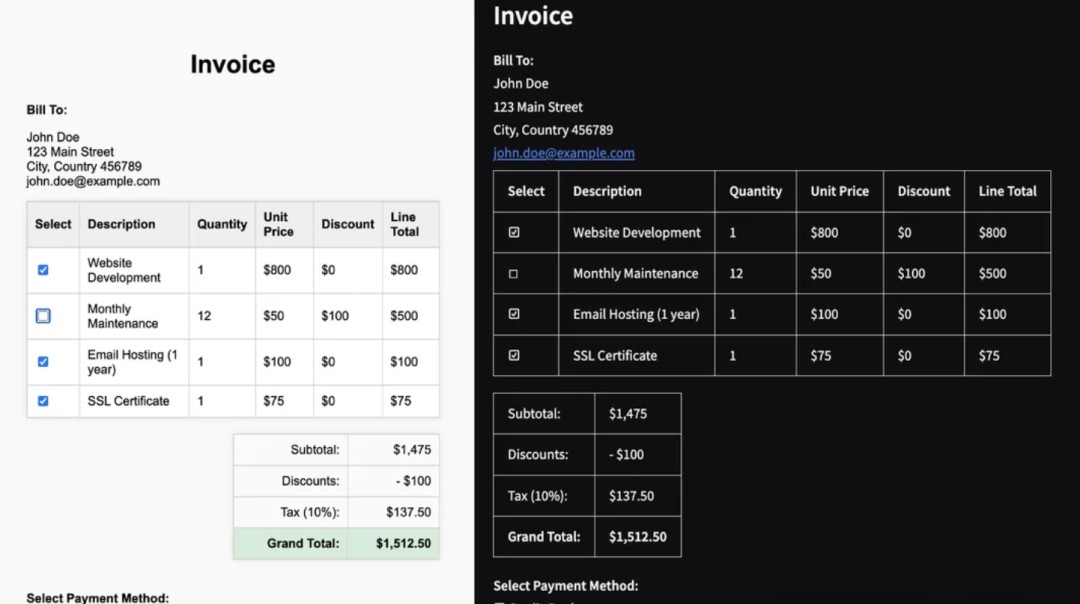
Nanonets-OCR-s умеет преобразовывать таблицы из изображений в формат Markdown, а также распознавать синтаксис LaTeX. Кроме того, он способен находить расположение изображений и преобразовывать их в теги <img>. Подписи преобразуются в теги <signature>, а символы вроде флажков отображаются с помощью эмодзи. Он также умеет обрабатывать таблицы с объединёнными ячейками и выводить их в формате HTML. Размер модели составляет 3,75B — она дообучена на базе Qwen2.5-VL-3B-Instruct, поэтому хорошо поддерживает китайский язык.
Ключевые особенности
Преобразование таблиц: точно извлекает сложные таблицы и преобразует их в понятные форматы Markdown и HTML.
Распознавание формул: точно преобразует математические формулы в документе в синтаксис LaTeX, легко справляясь как с встроенными, так и с вынесенными формулами.
Обработка изображений: автоматически распознаёт изображения в документе и описывает их с помощью тегов <img>, что удобно для последующей обработки.
Извлечение подписей и водяных знаков: обнаруживает подписи и водяные знаки в документе и помечает их тегами <signature> и <watermark> соответственно.
Обработка флажков: преобразует флажки и переключатели в документе в стандартные символы Unicode, удобные для чтения и редактирования.
Способы использования
Через Python-библиотеку:
Установите необходимые библиотеки (например, transformers и др.).
Загрузите предобученную модель, затем обработайте изображение и извлеките содержимое.
Через серверный интерфейс:
Запустите сервер, отправляйте запросы через Python и соответствующий клиент и получайте результаты преобразования.
С помощью упрощённых инструментов:
Используйте такие инструменты, как docext, чтобы запустить приложение в один клик и упростить рабочий процесс.
Сценарии применения
Академические исследования: быстро преобразует формулы, диаграммы и таблицы из статей в редактируемый формат Markdown, что удобно для систематизации и дальнейших исследований.
Деловой офис: обработка контрактов, отчётов и других документов, извлечение ключевой информации с сохранением единообразия форматирования и повышение эффективности работы.
Юридическая сфера: распознавание и выделение подписей, водяных знаков и других важных элементов, обеспечение полноты и точности документа.
Преимущества
Мощный функционал: распознаёт множество элементов документа, удовлетворяя потребности различных сценариев.
Интеллектуальность и эффективность: благодаря интеллектуальному распознаванию и семантической разметке выходные данные становятся более удобными для обработки.
Лёгкость и удобство: модель имеет умеренный размер, оптимизирована на основе существующих технологий и поддерживает китайский язык.
Адрес проекта
https://huggingface.co/nanonets/Nanonets-OCR-s









