
 Помощник сценариста▸
 AI Приложения
 AI Новости
VRAG-RL: фреймворк RAG на основе визуального восприятия от команды Tongyi Alibaba
小编 ·

VRAG-RL: фреймворк RAG на основе визуального восприятия от команды Tongyi Alibaba
Что такое VRAG-RL?
VRAG-RL — это модель, основанная на фреймворке визуально-воспринимаемого RAG, недавно представленная командой Alibaba Tongyi. Производительность модели увеличена на 30% на Qwen2.5-VL-3B и на 20% на Qwen2.5-VL-7B.
VRAG-RL обучается с помощью обучения с подкреплением, что позволяет модели выполнять многоэтапное мышление и рассуждение, постепенно усиливая понимание визуально-языковой моделью (VLM) и точность ответов. Фреймворк определяет пространство действий визуального восприятия, позволяя модели фокусироваться на информационно-насыщенных областях от грубого к точному, точно извлекать ключевую визуальную информацию и улучшать возможности VLM в области поиска, рассуждения и понимания визуальной информации.
Кроме того, VRAG-RL обладает возможностями мультимодального поиска и итеративного рассуждения, постепенно совершенствуя понимание визуальной информации посредством многораундового взаимодействия и в конечном итоге генерируя точные и исчерпывающие ответы. Модель подходит для различных визуальных задач, таких как понимание изображений, анализ диаграмм, разбор сложных макетов и другие сценарии.
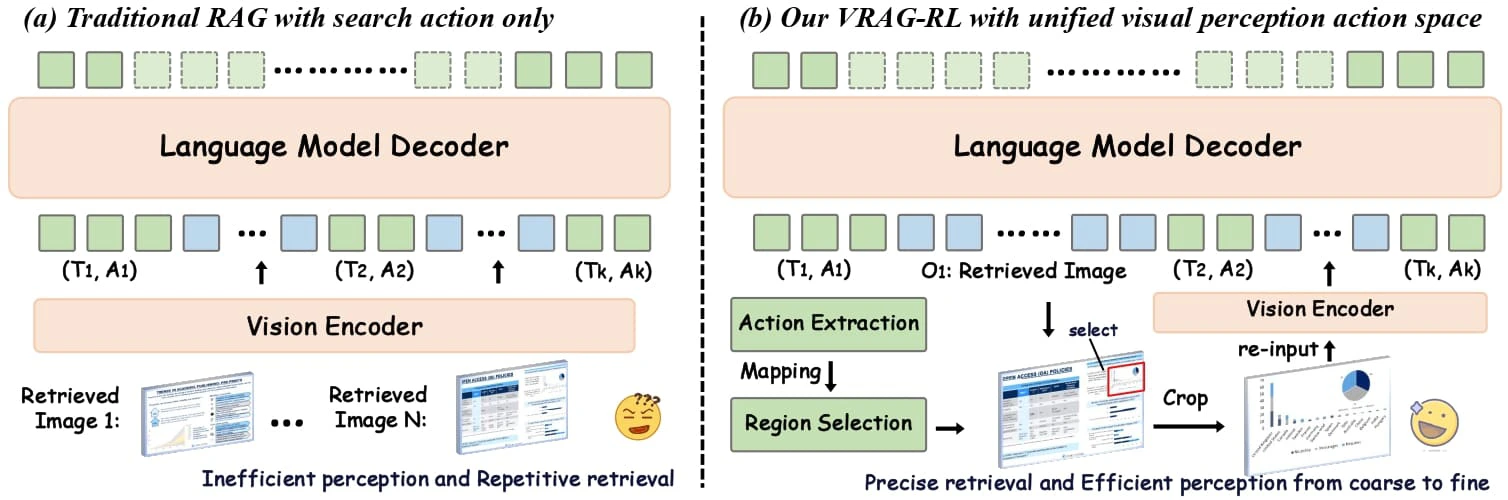
Ограничения традиционных методов RAG
Недостаточные возможности обработки визуальной информации: невозможность эффективного анализа информации в изображениях, отсутствие понимания и рассуждения в отношении визуальных данных.
Фиксированный процесс ограничивает динамическое рассуждение: часто используется фиксированный процесс поиска-генерации, что затрудняет динамическую корректировку пути рассуждения в сложных задачах и ограничивает способность модели извлекать визуальную информацию.
Недостаточная эффективность поиска и глубина рассуждений: при обработке сложных визуальных задач часто не удаётся эффективно локализовать ключевую информацию, что приводит к недостаточной точности генерируемых результатов.
Ключевые инновации VRAG-RL
Пространство действий визуального восприятия: введены различные действия визуального восприятия, такие как выбор области, кадрирование и масштабирование, что позволяет модели постепенно фокусироваться на информационно-насыщенных областях от грубого к точному уровню и точно извлекать ключевую визуальную информацию. Такой подход восприятия от грубого к точному не только улучшает способность модели понимать визуальную информацию, но и значительно повышает эффективность поиска.
Фреймворк обучения с подкреплением: оптимизация возможностей рассуждения и поиска модели с помощью обучения с подкреплением (RL). Модель взаимодействует с поисковой системой в несколько раундов, автономно выбирает одно- или многораундовые траектории рассуждений и постоянно оптимизируется на основе выборок.
Комплексный механизм вознаграждения: разработана комплексная функция вознаграждения, включающая вознаграждение за эффективность поиска, вознаграждение за согласованность шаблонов и вознаграждение за результаты на основе модели. Этот механизм вознаграждения ориентирован на конечный результат и оптимизирует процесс поиска, позволяя модели более эффективно получать релевантную информацию.
Стратегия мультиэкспертного сэмплирования: сочетает возможности рассуждения крупномасштабных моделей и точность аннотирования экспертных моделей, что позволяет модели изучать более эффективные стратегии визуального восприятия.
Обучение с многораундовым взаимодействием: на основе стратегии обучения с многораундовым взаимодействием модель постепенно оптимизирует процесс рассуждения в ходе непрерывного взаимодействия с внешней средой, повышая стабильность и согласованность рассуждений.
Технические преимущества VRAG-RL
Повышение производительности: экспериментальные результаты показывают, что VRAG-RL значительно превосходит существующие методы на нескольких бенчмарк-наборах данных визуального языка. Типы задач охватывают широкий спектр визуально-насыщенных сценариев — от одношаговых до многошаговых рассуждений, от понимания чистого текста до распознавания диаграмм и разбора сложных макетов.
Поддержка многораундового взаимодействия: возможность постепенной фокусировки на информационно-насыщенных областях на этапе рассуждения, обеспечивая получение информации от грубого к точному.
Эффективное обучение: внедрён передовой в отрасли алгоритм GRPO, который моделирует реальные сценарии применения за счёт локального развёртывания поисковой системы, обеспечивая нулевую стоимость вызовов поисковой системы и более эффективное обучение модели.
Сценарии применения VRAG-RL
Анализ сложных диаграмм: извлечение ключевых данных из финансовых отчётов и научных диаграмм.
Разбор макетов дизайна: понимание и логический анализ компоновки и элементов в дизайн-макетах.
Поиск по документам: эффективный поиск информации в базах знаний документов, содержащих изображения и таблицы.
Мультимодальный вопрос-ответ: сочетание текста и изображений для многошагового рассуждения при ответах на сложные вопросы.
Ссылки на проект
Репозиторий на GitHub:https://github.com/Alibaba-NLP/VRAG
Коллекция моделей на HuggingFace:https://huggingface.co/collections/autumncc/vrag-rl
Техническая статья на arXiv:https://arxiv.org/pdf/2505.22019









