
 Помощник сценариста▸
 AI Приложения
 AI Новости
Alibaba выпускает QwenLong-L1-32B: LLM для рассуждений в длинном контексте
小编 ·

Alibaba выпускает QwenLong-L1-32B: LLM для рассуждений в длинном контексте
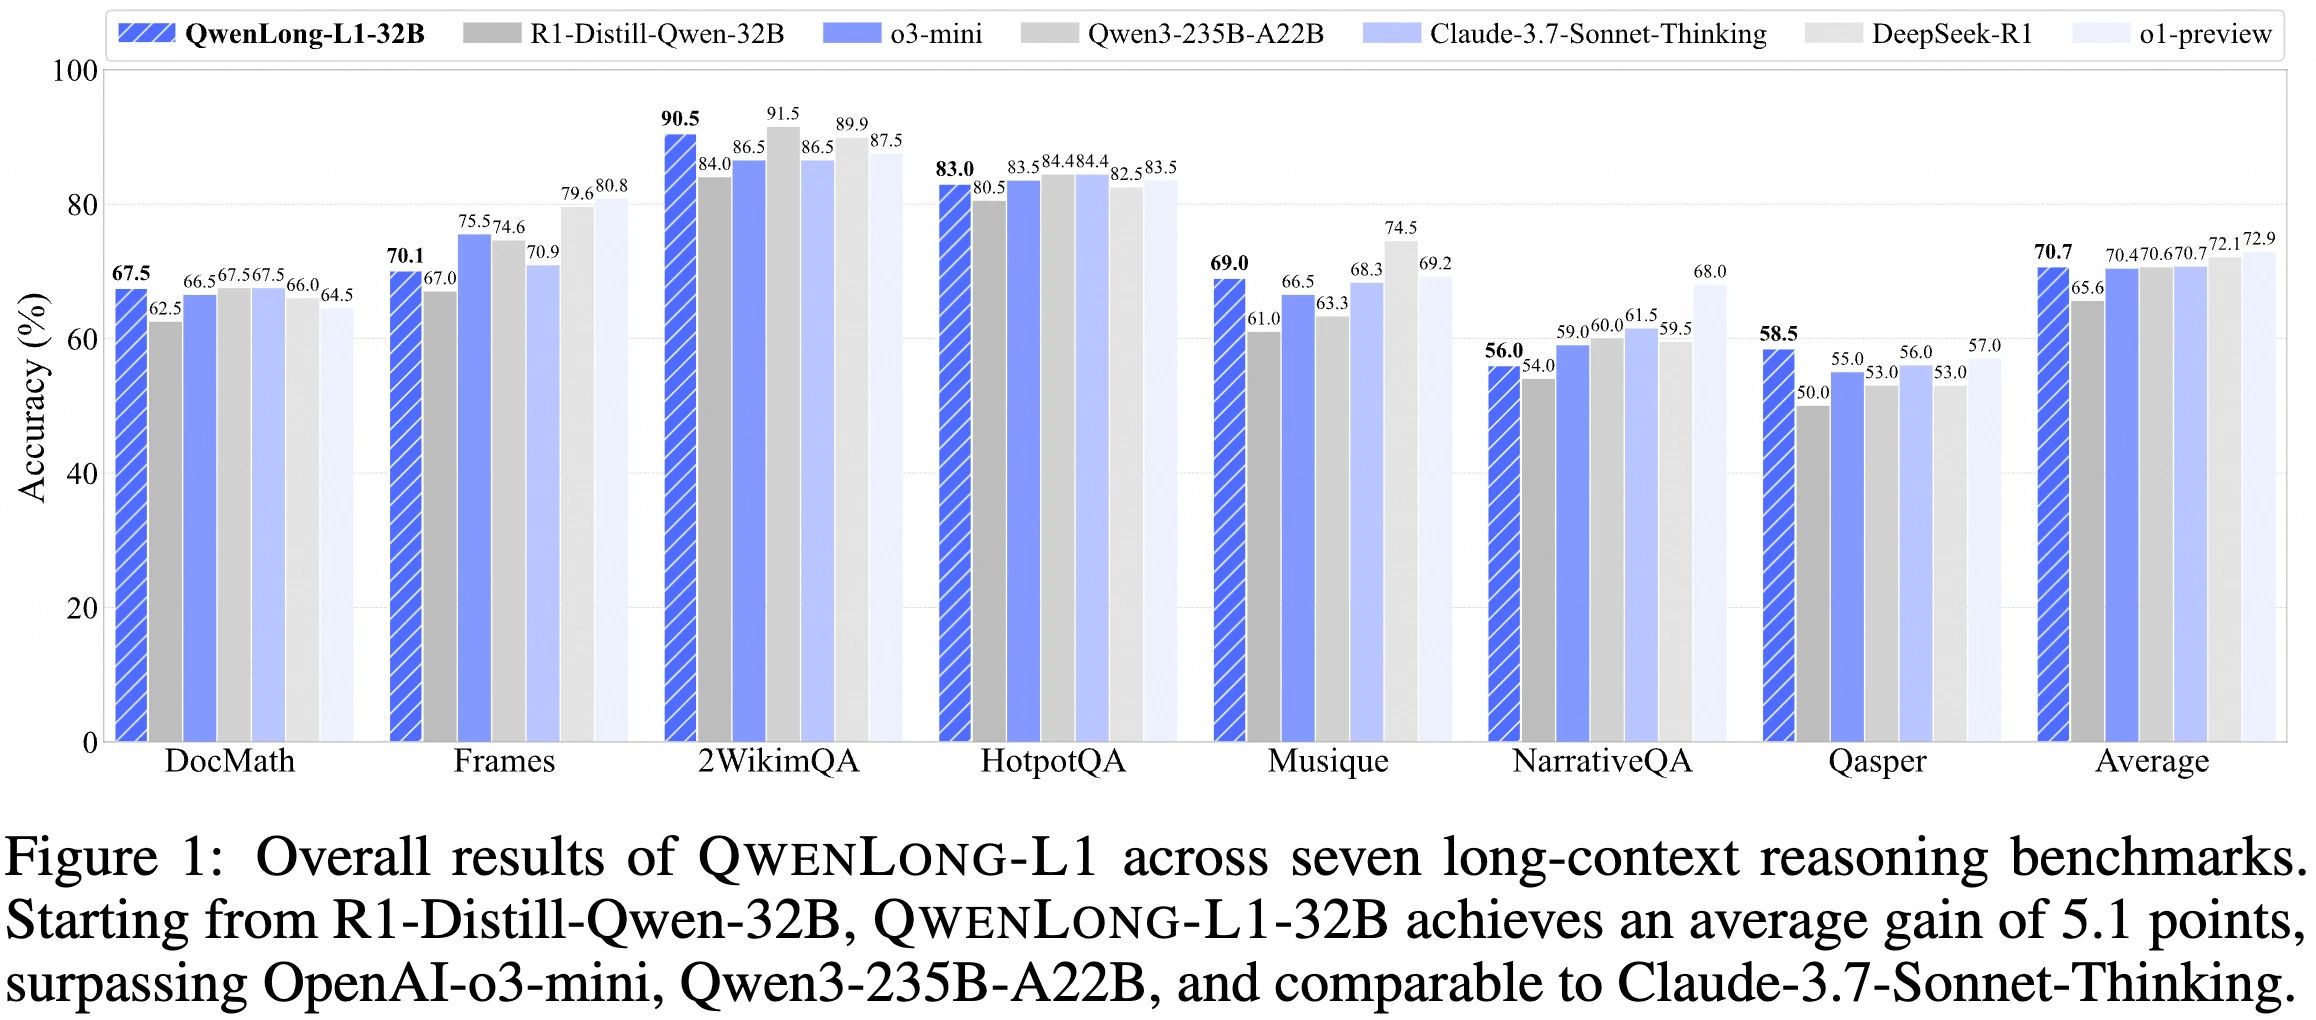
26 мая 2025 года команда Alibaba выпустила QwenLong-L1-32B — первую крупную модель рассуждений с длинным контекстом, обученную с помощью обучения с подкреплением, а также датасет DocQA-RL-1.6K (содержащий 1600 вопросов для ответов на вопросы по документам в областях математики, логики и многошаговых рассуждений). Её фреймворк решает проблемы низкой эффективности обучения и нестабильности процесса оптимизации при обучении с подкреплением для рассуждений с длинным контекстом за счёт разогревочной контролируемой донастройки, управляемого курсового обучения с подкреплением и механизма выборки с учётом сложности и ретроспективным анализом. На 7 бенчмарках длинного контекста для DocQA модель превосходит по производительности Openai-o3-mini и Qwen3-235B-A22B и находится на одном уровне с Claude-3.7-Sonnet-Thinking.
Архитектура модели
Ключевая идея: адаптация короткоконтекстных крупных моделей рассуждений (LRM) к сценариям с длинным контекстом с помощью обучения с подкреплением (RL).
Основные компоненты:
Этап разогревочной контролируемой донастройки (SFT): формирование устойчивой начальной стратегии.
Поэтапная техника обучения с подкреплением на основе учебного плана: стабильная эволюция стратегии.
Стратегия выборки с учётом сложности и ретроспективного анализа: стимулирование исследования стратегии.
Обучающие данные
Использовался специализированный датасет для обучения с подкреплением под названием DocQA-RL-1.6K, содержащий 1600 вопросов для ответов на вопросы по документам в областях математики, логики и многошаговых рассуждений.
Производительность
На семи бенчмарках длинного контекста для ответов на вопросы по документам QwenLong-L1-32B превзошёл такие флагманские LRM, как OpenAI-o3-mini и Qwen3-235B-A22B, достигнув уровня, сопоставимого с Claude-3.7-Sonnet-Thinking, демонстрируя лидирующую производительность среди современных передовых LRM.
Дизайн экспериментов
Был создан специализированный датасет для обучения с подкреплением DocQA-RL-1.6K, содержащий 1600 вопросов для ответов на вопросы по документам, охватывающих области математики, логики и многошаговых рассуждений.
Для раздела математических рассуждений использовались 600 вопросов из датасета DocMath, из которых 75% предназначены для обучения, а 25% — для оценки.
Для раздела логических рассуждений с помощью DeepSeek-R1 было синтезировано 600 вопросов с множественным выбором, охватывающих реальные документы из правовой, финансовой, страховой и производственной сфер.
Для раздела многошаговых рассуждений было отобрано по 200 примеров из MultiHopRAG и Musique с акцентом на меж文档овые рассуждения.
Оценка проводилась на семи бенчмарках длинного контекста для DocQA, включая 2WikiMultihopQA, HotpotQA, Musique, NarrativeQA, Qasper, Frames и DocMath.
Результаты и анализ
QwenLong-L1-32B продемонстрировал отличные результаты на семи бенчмарках длинного контекста для DocQA, превзойдя флагманские модели LRM, такие как OpenAI-o3-mini и Qwen3-235B-A22B, достигнув производительности, сопоставимой с Claude-3.7-Sonnet-Thinking.
На бенчмарке математических рассуждений DocMath показатели точного совпадения и точности по оценке LLM у QwenLong-L1-32B достигли 85,3%.
На бенчмарке многошаговых рассуждений HotpotQA производительность модели достигла 87,6%, что значительно превосходит существующие модели.
Ссылки на проект
Github: https://github.com/Tongyi-Zhiwen/QwenLong-L1
Huggingface: https://huggingface.co/Tongyi-Zhiwen/QwenLong-L1-32B
Modelscope: https://www.modelscope.cn/models/iic/QwenLong-L1-32B









