
 Помощник сценариста▸
 AI Приложения
 AI Новости
ParseStudio: Python-библиотека для упрощения разбора PDF
小编 ·

ParseStudio: Python-библиотека для упрощения разбора PDF
Что такое ParseStudio?
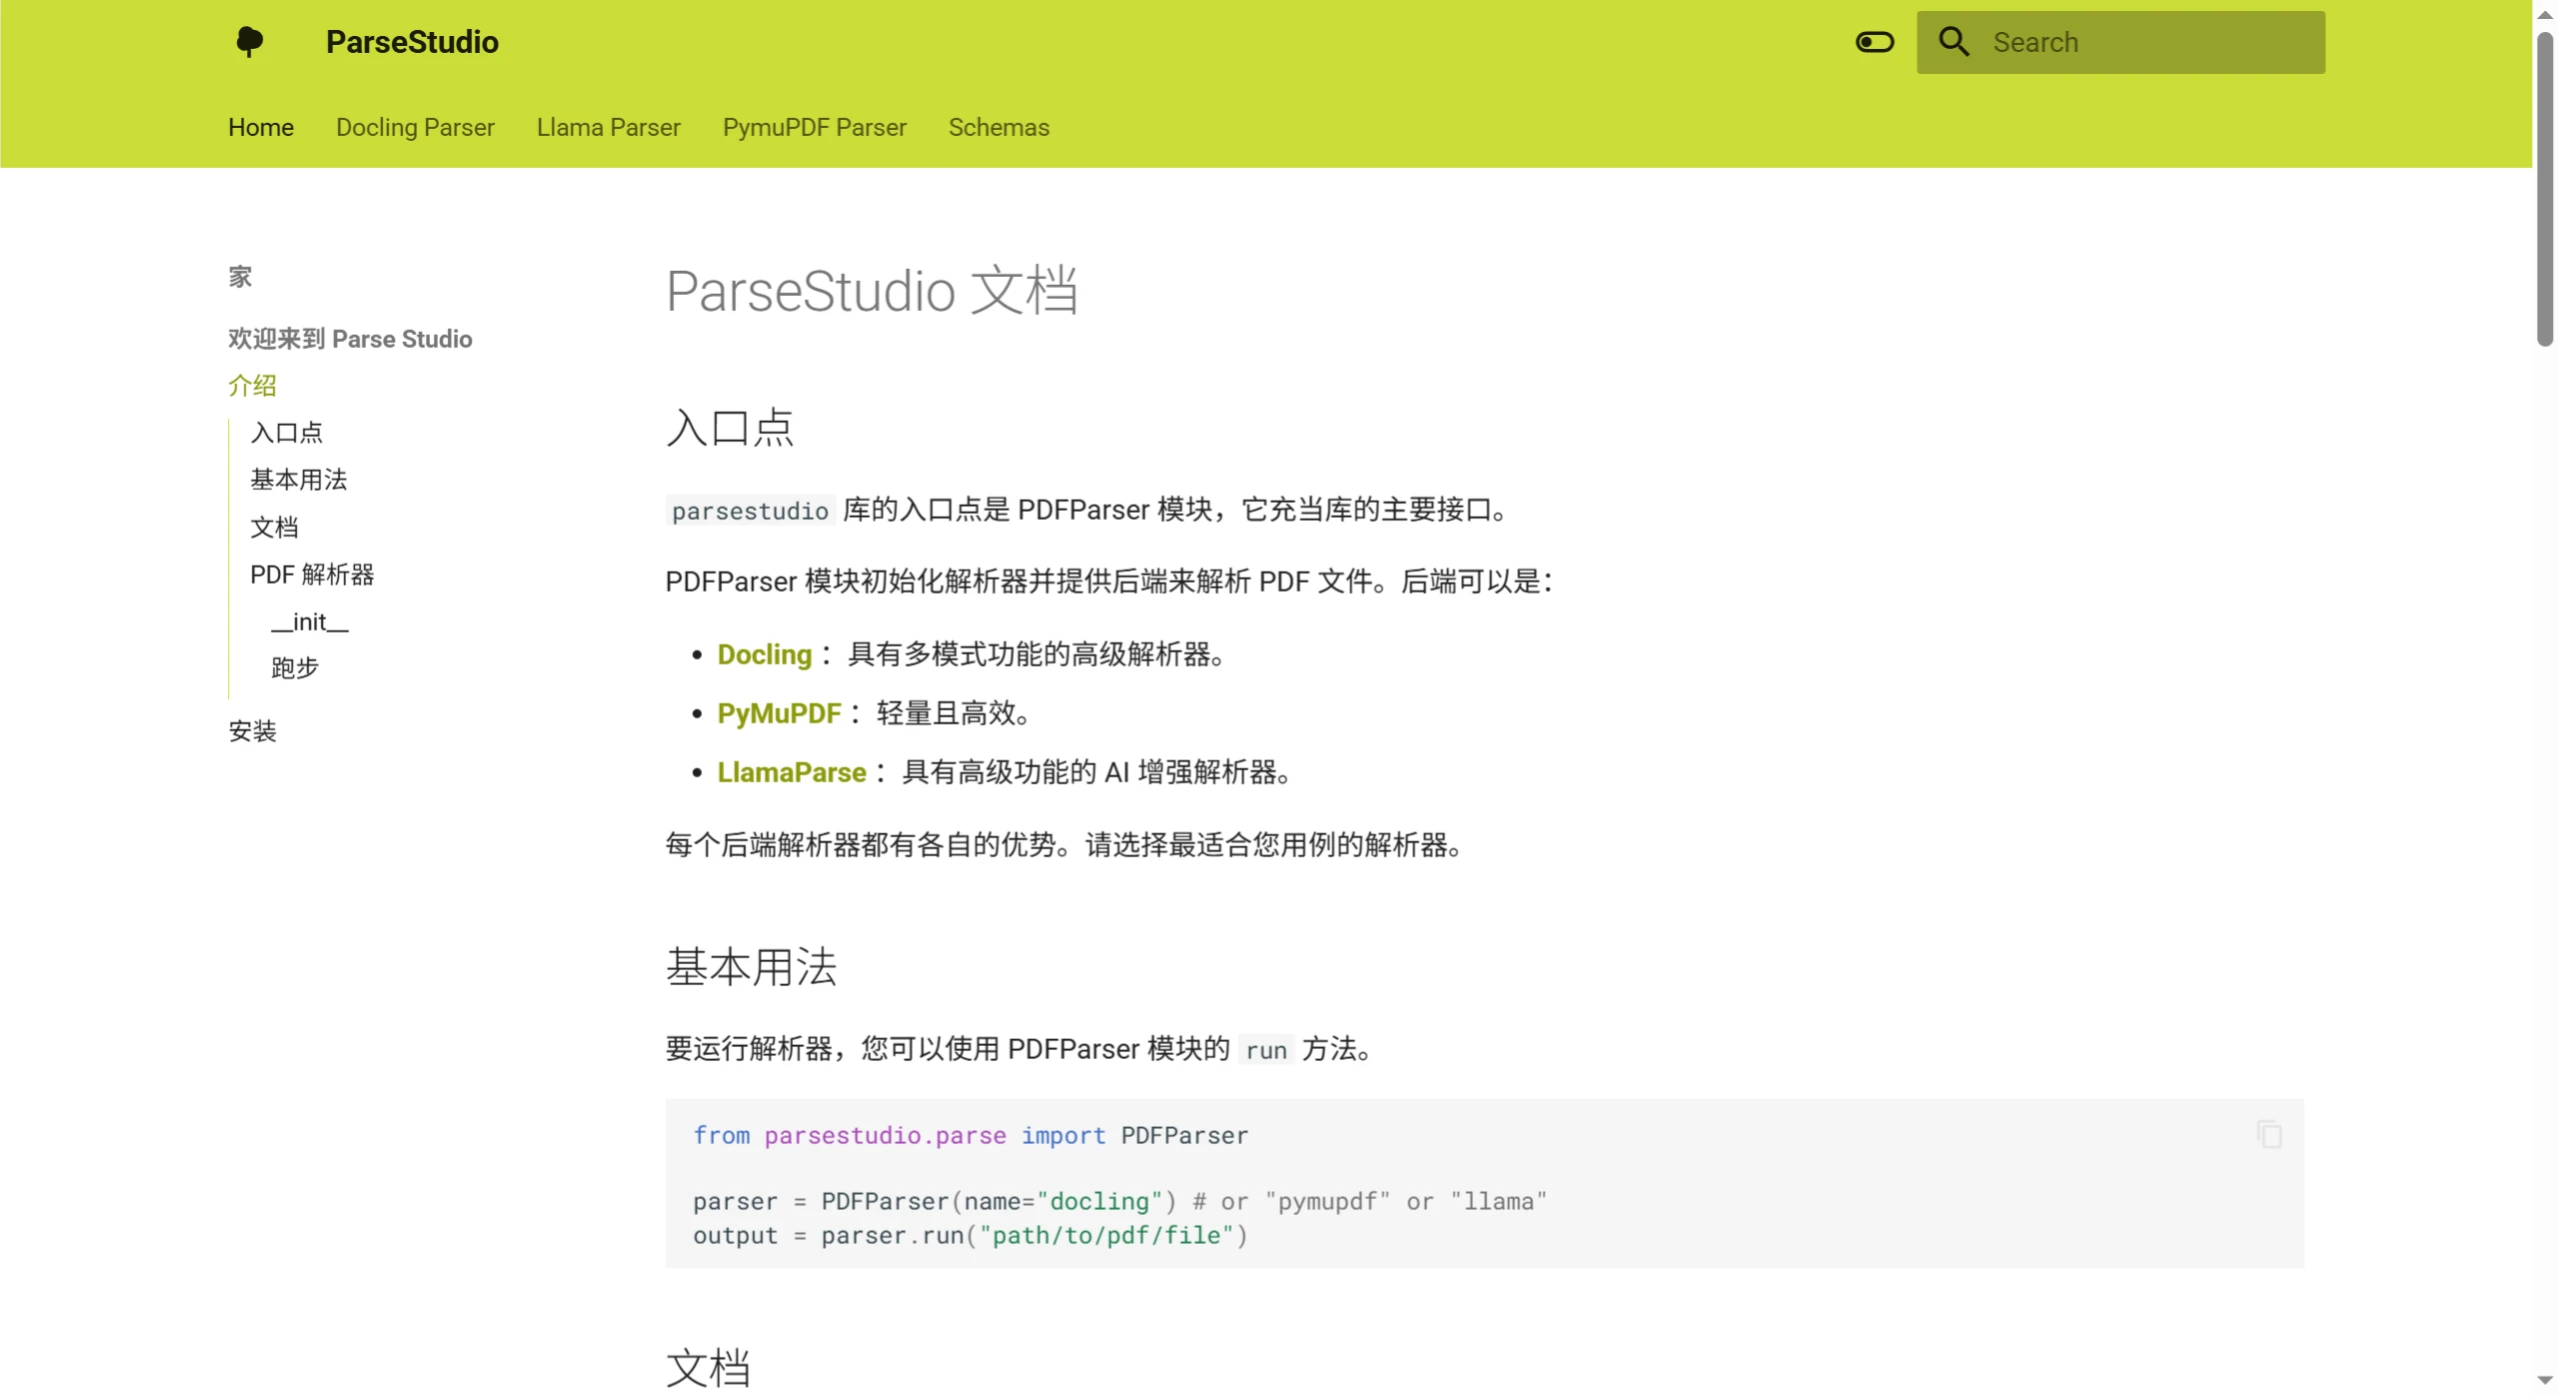
При работе с PDF-документами извлечение текста, таблиц и изображений часто вызывает затруднения, а разные библиотеки используются по-разному, что делает код повторяющимся и сложным в сопровождении. ParseStudio — это Python-библиотека, которая предлагает упрощённый подход, объединяя несколько парсеров в единый интерфейс, позволяя пользователям выполнять разбор PDF-документов всего в несколько строк кода. Библиотека объединяет три движка: Docling, PyMuPDF и Llama Parse, обеспечивая гибкое извлечение текста, таблиц и изображений. Основные особенности ParseStudio: модульная архитектура, возможность одновременного извлечения разных типов контента, лаконичный API, автоматическое преобразование таблиц в формат Markdown, включение метаданных при извлечении изображений, а также поддержка пакетной обработки нескольких PDF-файлов. Для разработчиков с базовым знанием Python ParseStudio является полезным инструментом.
Основные особенности ParseStudio
Модульная архитектура: можно выбирать различные бэкенды для парсинга, такие как Docling, PyMuPDF и Llama Parse, в зависимости от потребностей.
Мультимодальный разбор: возможность бесшовного извлечения текста, таблиц и изображений.
Единый синтаксис: упрощает взаимодействие с разными бэкендами благодаря единому интерфейсу.
Расширяемость: поведение парсера можно легко настраивать с помощью дополнительных параметров.
Удобство для пользователя: абстрагирует специфические для бэкенда сложности, позволяя сосредоточиться на извлечении контента.
Установка ParseStudio
Установка с помощью pip:
pip install parsestudio
Установка из исходного кода:
git clone https://github.com/chatclimate-ai/ParseStudio.git
cd ParseStudio
pip install .
Быстрый старт с ParseStudio
Импорт и инициализация парсера:
from parsestudio.parse import PDFParser
# Инициализация с нужным бэкендом парсера
parser = PDFParser(parser="docling")  # Варианты: "docling", "pymupdf", "llama"
Разбор PDF-файла:
outputs = parser.run(["path/to/file.pdf"], modalities=["text", "tables", "images"])
# Доступ к текстовому содержимому
print(outputs[0].text)
# Доступ к таблицам
for table in outputs[0].tables:
    print(table.markdown)
# Доступ к изображениям
for image in outputs[0].images:
    image.image.show()
    metadata = image.metadata
    print(metadata)
Поддерживаемые парсеры
Docling: подходит для детального анализа макета сложных документов, поддерживает OCR и точное извлечение таблиц.
PyMuPDF: лёгкий и эффективный, подходит для быстрой обработки.
LlamaParse: облачное и усиленное ИИ извлечение, подходит для сценариев, требующих расширенных возможностей.
GitHub: https://github.com/chatclimate-ai/ParseStudio









