
 Помощник сценариста▸
 AI Приложения
 AI Новости
AniSora: открытая модель генерации анимационных видео от Bilibili
小编 ·

AniSora: открытая модель генерации анимационных видео от Bilibili
Что такое AniSora?
AniSora — это система генерации ИИ-анимационных видео, открытая компанией Bilibili 12 мая 2025 года. Она способна легко создавать аниме-видео в самых разных стилях, таких как фрагменты аниме-сериалов, оригинальные китайские анимации, экранизации манги, контент VTuber, аниме-PV, а также мем-видео (guichu). Эта система отлично справляется с сохранением внешности персонажей и плавности движений и на сегодняшний день является одной из самых передовых моделей генерации анимационного видео.
Функции AniSora
Генерация из изображения в видео: создание связного анимационного видео на основе одного изображения, что позволяет расширять статичные кадры в динамичные сцены.
Интерполяция кадров: поддерживает интерполяцию ключевых кадров за счёт генерации промежуточных кадров для плавных переходов, сокращая объём ручной работы при создании анимации.
Локальное управление изображением: позволяет пользователю указывать конкретные области для генерации анимации.
Пространственно-временное управление: сочетает управление во времени и пространстве, поддерживая управление по первому кадру, последнему кадру, нескольким кадрам и другие методы, обеспечивая точное создание анимации.
Особенности модели AniSora
Целевая оптимизация: по сравнению с натуральными видео анимационные видео обладают большей стилистической выразительностью и абстрактностью, и традиционные модели генерации часто не способны точно воспроизвести выражения персонажей, ритм движений и преувеличенную операторскую работу. AniSora оптимизирована с учётом этих особенностей, стремясь повысить эффективность генерации видео без ущерба для творческого самовыражения.
Поддержка разнообразных стилей: способна одним нажатием генерировать видеофрагменты в различных стилях, включая аниме-сериалы, оригинальную китайскую анимацию, экранизации манги, контент VTuber, аниме-PV и даже мем-контент (guichu).
Низкий порог входа: для частных лиц или студий с реальными производственными задачами AniSora является чрезвычайно привлекательным инструментом для творчества.
Основные модули AniSora
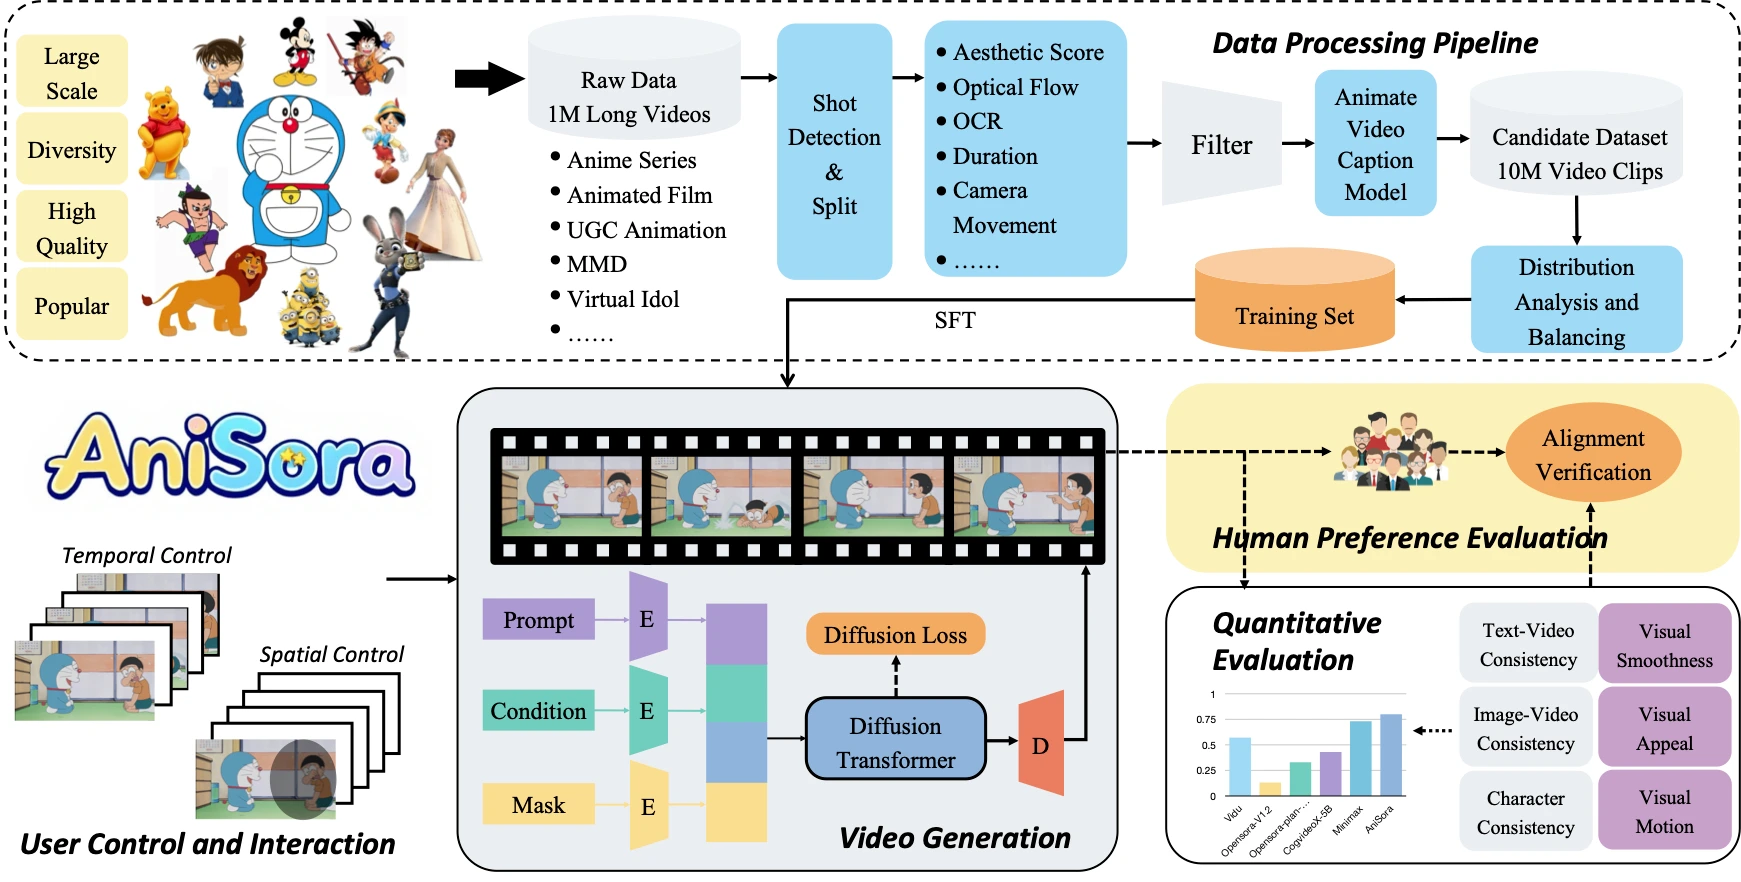
Конвейер обработки данных: предобработка более 10 миллионов пар высококачественных данных «текст — видео», обеспечивающая прочную основу для обучения.
Управляемая модель генерации: введён модуль пространственно-временных масок, поддерживающий функции генерации видео из изображений, интерполяции ключевых кадров, локального управления изображениями и другие, способные удовлетворить разнообразные творческие потребности.
Система оценки: создан набор данных для оценки, содержащий 948 разнообразных анимационных фрагментов, в сочетании с двойным слепым рецензированием людьми и системой оценки VBench, для выставления баллов по таким параметрам, как согласованность персонажей и плавность движений.
Технические принципы AniSora
Диффузионная модель (Diffusion Model): основана на архитектуре диффузионной модели, которая постепенно удаляет шум для генерации высококачественного видеоконтента.
Модуль пространственно-временных масок (Spatiotemporal Mask Module): позволяет модели управлять определёнными временными и пространственными областями в процессе генерации, например, указывать с помощью масок, какие кадры или области требуют генерации анимации, обеспечивая локальное управление и интерполяцию ключевых кадров.
3D-причинный вариационный автокодировщик (3D Causal VAE): используется для кодирования и декодирования пространственно-временных характеристик видео, сжимая видео в низкоразмерное скрытое пространство, что снижает вычислительную сложность при сохранении ключевой пространственно-временной информации.
Архитектура Transformer: в сочетании с мощными возможностями моделирования Transformer, на основе механизма внимания улавливает сложные пространственно-временные зависимости в видео, позволяя модели обрабатывать длинные последовательности данных и генерировать более связный видеоконтент.
Контролируемое дообучение (Supervised Fine-Tuning): на основе предварительного обучения выполняется контролируемое дообучение с использованием большого объёма анимационных видеоданных, а также применяются различные стратегии (такие как стратегия обучения «от слабого к сильному», многозадачное обучение и т.д.) для повышения обобщающей способности и качества генерации модели.
Конвейер обработки данных: на основе методов обнаружения сцен, оптического потока, оценки эстетичности и других технологий из большого объёма исходных анимационных видео отбираются высококачественные обучающие данные, что обеспечивает их качество и разнообразие.
Адреса открытого исходного кода
https://github.com/bilibili/Index-anisora/tree/main
https://huggingface.co/IndexTeam/Index-anisora
https://www.modelscope.cn/organization/bilibili-index









