
 Помощник сценариста▸
 AI Приложения
 AI Новости
Simple Subtitling: инструмент автоматической генерации субтитров для видео
小编 ·

Simple Subtitling: инструмент автоматической генерации субтитров для видео
Что такое Simple Subtitling?
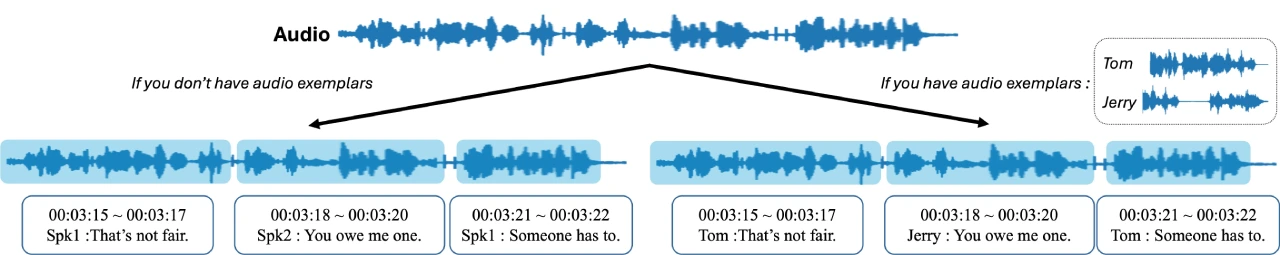
Simple Subtitling — это aiинструмент, который автоматически генерирует субтитры для аудиовизуальных произведений. Он использует технологию WhisperX для преобразования аудиофайлов в файлы субтитров (SRT) с временными метками и идентификаторами говорящих. Затем с помощью извлечения и кластеризации вложений говорящих присваиваются идентификаторы говорящих, а при наличии аудиопримера можно присвоить точные имена говорящих. Конкретно, он сначала преобразует аудио в текст с временными метками; затем извлекает характеристики каждого говорящего, группирует их методом агломеративной иерархической кластеризации (AHC) и в итоге присваивает говорящим идентификаторы. Если пользователь предоставляет образцы голоса актёров, инструмент также способен присваивать говорящим имена. Этот инструмент создан для того, чтобы сделать генерацию субтитров проще, а просмотр аудиовизуальных произведений — удобнее.
Функциональные возможности Simple Subtitling
Распознавание речи и генерация временных меток: использование технологии WhisperX обеспечивает точное пословное и пофразное распознавание аудиоконтента и формирование текста с временными метками.
Идентификация говорящих: путём извлечения вложений говорящих на уровне предложений и применения агломеративной иерархической кластеризации (AHC) для группировки вложений присваиваются идентификаторы говорящих.
Поддержка нескольких языков: поддерживается ввод аудио на разных языках с возможностью генерации соответствующих субтитров.
Пользовательские настройки: пользователь может указать каталог с аудиопримерами, чтобы присвоить говорящим точные имена.
Высокоточное распознавание речи и кластеризация: обеспечивается высокоточное распознавание речи и кластеризация, точное преобразование речи в текст и классификация речи разных говорящих, что повышает точность и читаемость субтитров.
Установка и использование Simple Subtitling
Шаги установки
Создайте и активируйте conda-окружение с именем simplesub, указав версию Python 3.11.
В этом окружении установите необходимые пакеты Python с помощью команды pip install -r requirements.txt.
Также необходимо установить ffmpeg; конкретные способы установки см. в соответствующей документации.
Использование
Базовое использование
Выполните команду python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH], например python main.py --input_file data/friends.wav --output_file result/friends.srt — это позволит сгенерировать файл субтитров на основе входного аудиофайла.
Использование аудиопримеров для указания имён говорящих
Сначала организуйте каталог --exemplar_dir в определённой структуре: каждая вложенная папка представляет одного говорящего и содержит аудиопримеры этого говорящего.
Затем выполните команду python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH] --exemplar_dir [PATH_OF_EXEMPLARS], например python main.py --input_file data/friends.wav --output_file result/friends_exemplars.srt --exemplars exemplars.
Описание параметров
input_file: путь к входному аудиофайлу.
output_file: путь к выходному файлу субтитров (в формате SRT).
whisper_model_type: тип модели Whisper, по умолчанию 'medium'; доступные варианты можно посмотреть в соответствующей документации.
language: код языка (две буквы, например 'en' для английского); если значение None, Whisper определит язык по первым 30 секундам; по умолчанию None.
embedding_model: экстрактор вложений говорящих, доступны варианты 'ecapatdnn' или 'wespeaker'; по умолчанию 'wespeaker'.
n_cluster: если количество говорящих известно, можно задать этот параметр; по умолчанию None.
distance_threshold: если n_cluster не указан, это порог расстояния для AHC (агломеративной иерархической кластеризации); по умолчанию 0.8.
exemplar_dir: путь к каталогу, содержащему аудиопримеры; по умолчанию None.
exemplar_threshold: порог косинусного сходства, используемый для отнесения говорящего к «неизвестным»; по умолчанию 0.2.
Github: https://github.com/JaesungHuh/simple-subtitling









