
 Помощник сценариста▸
 AI Приложения
 AI Новости
ContextGem: AI-инструмент для извлечения структурированных данных из документов
小编 ·

ContextGem: AI-инструмент для извлечения структурированных данных из документов
Что такое ContextGem?
ContextGem — это AIинструмент для извлечения структурированных данных из документов, основная возможность которого заключается в автоматическом понимании намерений пользователя на основе указанной информации для извлечения и точном определении соответствующего содержимого в документе, особенно хорошо справляясь с глубоким анализом.
Он отлично подходит для сценариев, требующих интенсивного чтения документов, например для извлечения ключевых пунктов из контрактов, важных данных из отчётов, основных выводов из научных статей и т. д., помогая пользователям эффективно выполнять тщательное чтение.
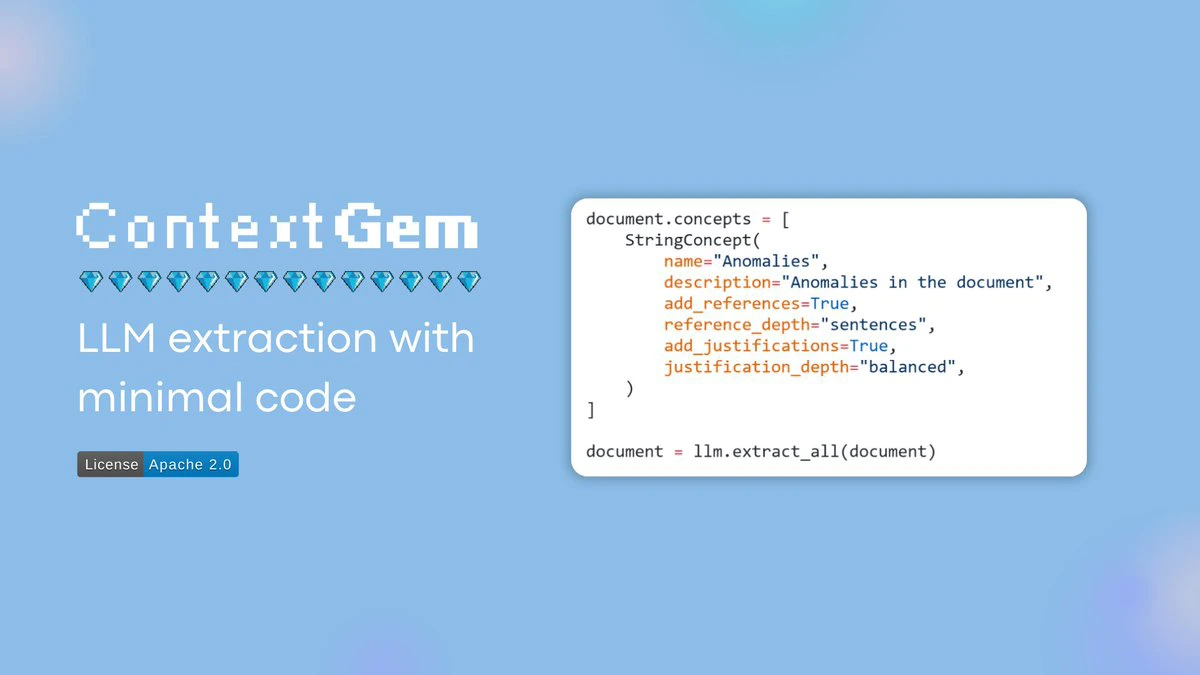
ContextGem не только способен находить информацию и сообщать вам, в каком именно абзаце или предложении она находится, но и объяснять причины извлечения этой информации и процесс рассуждения. Он позволяет выполнять сложные задачи извлечения с помощью нескольких строк кода, обладает высокой степенью автоматизации, а многие сложные операции уже упакованы в готовые решения. Он может автоматически генерировать промпты, автоматически выполнять проверку данных и автоматическое разбиение на сегменты, что значительно упрощает процесс работы пользователя.
Основные функции ContextGem
Автоматические динамические промпты: автоматически генерирует индивидуальные исчерпывающие промпты в соответствии с потребностями извлечения, без необходимости вручную составлять и поддерживать промпты.
Автоматическое создание моделей данных и валидаторов: автоматически создаёт модели данных Pydantic и логику валидации на основе определений, избавляя от повторного написания шаблонного кода.
Точное сопоставление извлечённого содержимого: автоматически точно сопоставляет извлечённые данные с их местоположением в исходном документе (с точностью до абзаца или предложения), обеспечивая проверяемость и прослеживаемость результатов.
Предоставление обоснования извлечения: автоматически включает текстовое обоснование или доказательства, подтверждающие каждый извлечённый фрагмент данных, повышая прозрачность и достоверность результатов.
Интеллектуальное разбиение документов: использует самые современные модели нейронной сегментации (SaT) для точного разбиения документов на абзацы и предложения с поддержкой множества языков.
Унифицированный процесс извлечения: позволяет определить весь рабочий процесс извлечения в одной декларативной и многократно используемой конфигурации конвейера, включая вложенный контекст и LLM с определённой ролью.
Поддержка извлечения вложенного контекста: автоматически обрабатывает иерархическое извлечение информации в соответствии с определением конвейера (например, документ > раздел > подраздел > сущность), упрощая анализ сложных документов.
Встроенная параллельная обработка: с помощью простого переключателя use_concurrency=True включает параллельную обработку I/O, ускоряя ресурсоёмкие рабочие процессы извлечения, связанные с множественными вызовами LLM.
Автоматическое отслеживание использования и затрат: позволяет отслеживать вызовы LLM, использование токенов и связанные с ними затраты в рабочем процессе без какой-либо дополнительной настройки.
Встроенная логика резервирования и повторных попыток: встроенный механизм повторных попыток и возможность лёгкой настройки резервных LLM для повышения отказоустойчивости.
Многоязычная поддержка: поддержка ввода и вывода на нескольких языках без необходимости в дополнительных промптах.
Поддержка нескольких поставщиков LLM: поддержка облачных LLM (таких как OpenAI, Anthropic, Google, Azure OpenAI и др.) и локальных LLM (таких как Ollama, LM Studio и др.) с унифицированным интерфейсом для удобства переключения.
Стратегии оптимизации: предоставляются стратегии оптимизации точности, скорости и стоимости, а также рекомендации по обработке длинных документов и выбору подходящих LLM.
Сериализация результатов: возможность сохранения и загрузки объектов документов, конвейеров и конфигураций LLM во избежание повторных вызовов дорогостоящих LLM.
Конвертер документов
ContextGem предоставляет встроенный конвертер документов, который может преобразовывать файлы DOCX в данные, пригодные для использования LLM. Он способен извлекать информацию, которую часто не могут захватить другие инструменты с открытым исходным кодом, такую как смещённые таблицы, примечания, сноски, текстовые поля, колонтитулы и встроенные изображения, сохраняя при этом структуру документа и расширенные метаданные для лучшего анализа с помощью LLM.
Сценарии применения ContextGem
ContextGem специализируется на глубоком и точном анализе отдельных документов, используя расширенное контекстное окно и возможности современных LLM. Он подходит для сценариев, в которых требуется извлечение точных данных и выводов из конкретных документов, например для анализа юридических контрактов, обработки финансовых документов и т. д. Однако в настоящее время он не поддерживает запросы по нескольким документам или поиск по всему корпусу документов; для этих случаев использования могут лучше подойти современные системы RAG (такие как LlamaIndex, Haystack).
Ссылка на проект ContextGem
https://github.com/shcherbak-ai/contextgem









