
 Помощник сценариста▸
 AI Приложения
 AI Новости
Insert Anything: открытый фреймворк редактирования изображений с заменой лиц, одежды и не только
小编 ·

Insert Anything: открытый фреймворк редактирования изображений с заменой лиц, одежды и не только
Обзор Insert Anything
Insert Anything — это унифицированный фреймворк для вставки изображений, совместно разработанный Чжэцзянским университетом, Гарвардским университетом и Наньянским технологическим университетом. Он позволяет бесшовно интегрировать объекты из референсного изображения в целевую сцену и поддерживает множество практических сценариев применения, таких как художественное творчество, реалистичная замена лиц, построение кинематографических сцен, виртуальная примерка одежды, кастомизация аксессуаров и замена цифровых реквизитов.
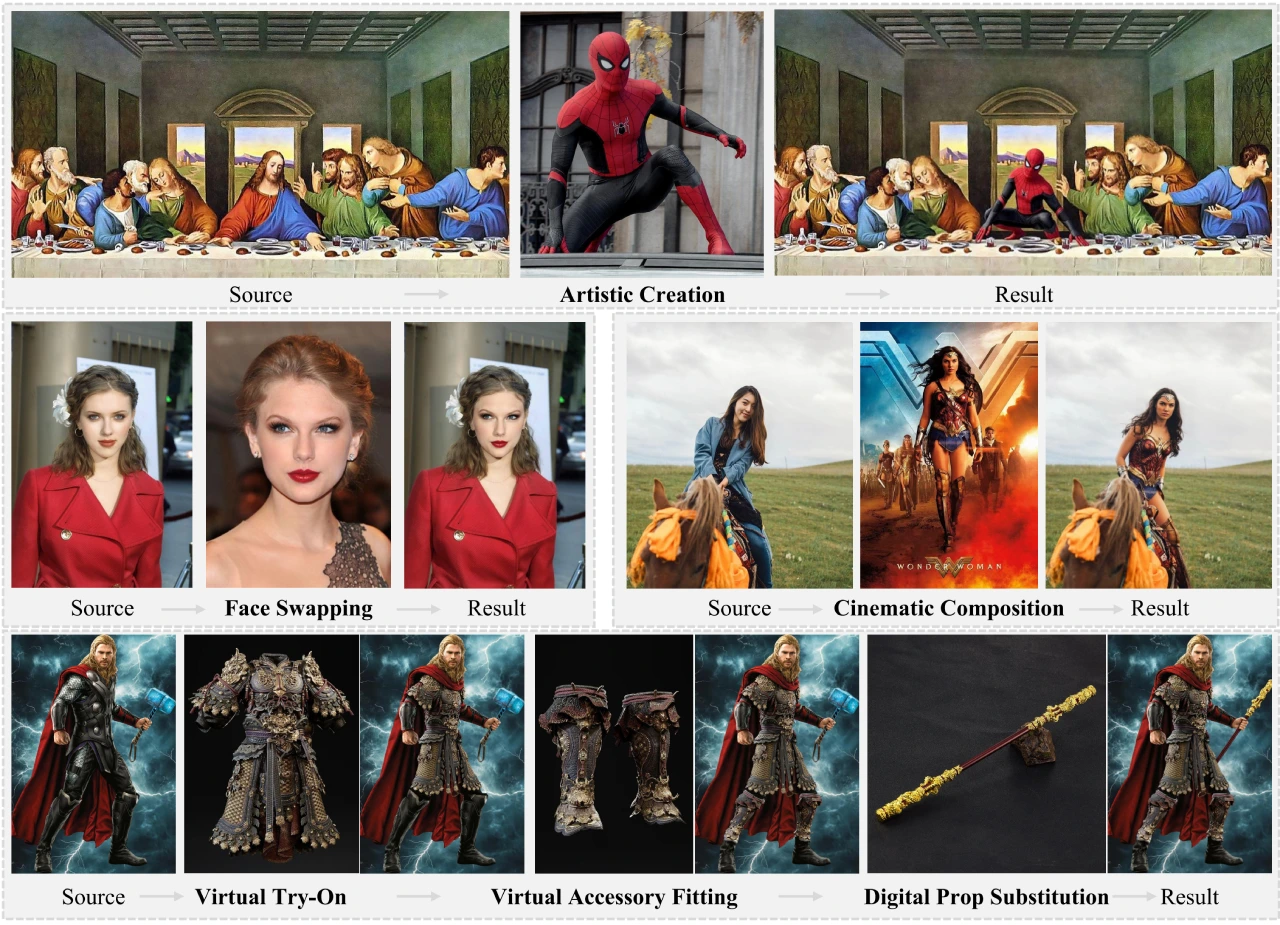
Технические принципы Insert Anything
1. Набор данных AnyInsertion
Масштаб и содержание: фреймворк основан на наборе данных AnyInsertion, содержащем 120 тысяч пар «подсказка-изображение», который охватывает такие задачи, как вставка людей, объектов и одежды.
Множественные режимы управления: набор данных поддерживает два режима управления — масочные подсказки (58 тыс. пар) и текстовые подсказки (101 тыс. пар), что обеспечивает богатый набор обучающих примеров для модели.
2. Diffusion Transformer (DiT)
Мультимодальный механизм внимания: Insert Anything использует мультимодальный механизм внимания DiT, поддерживающий редактирование с управлением по маске и по тексту. Этот механизм обрабатывает визуальные входные данные и текстовые описания через соответствующие ветви — визуальную и текстовую, а затем объединяет эту информацию посредством мультимодального внимания.
Визуальная ветвь: обрабатывает референсное изображение, исходное изображение и маску, извлекает визуальные признаки и объединяет их с шумом.
Текстовая ветвь: кодирует текстовое описание для обеспечения семантического управления.
3. Механизм контекстного редактирования
Стратегии подсказок в формате диптиха и триптиха:
Диптих с масочной подсказкой: слева — референсное изображение, справа — целевое изображение с маской.
Триптих с текстовой подсказкой: слева — референсное изображение, в центре — исходное изображение, справа — результат, сгенерированный по тексту.
Функциональность: этот механизм рассматривает референсное изображение как контекстную информацию и посредством неявного взаимодействия обеспечивает визуальную согласованность вставленного элемента с целевой сценой, сохраняя при этом его уникальные черты.
Преимущества
Универсальность: одна модель способна решать множество задач вставки, избавляя от необходимости обучать отдельную модель для каждой задачи.
Гибкость: поддерживаются два режима управления — по маске и по тексту, что удовлетворяет разнообразные потребности пользователей в редактировании.
Визуальная согласованность: механизм контекстного редактирования обеспечивает естественное слияние вставленного элемента с целевой сценой.
Сценарии применения Insert Anything
Художественное творчество: бесшовная вставка художественных элементов в различные фоны.
Коммерческая реклама: вставка изображений продуктов в рекламные сцены.
Создание контента в поп-культуре: вставка элементов поп-культуры в соответствующие сцены.
Ссылки на проект
Главная страница проекта:https://song-wensong.github.io/insert-anything/
Статья:https://arxiv.org/abs/2504.15009
Github:https://github.com/song-wensong/insert-anything









