
 Помощник сценариста▸
 AI Приложения
 AI Новости
RealtimeVoiceChat: приложение для голосового AI-чата с ответами в реальном времени
小编 ·

RealtimeVoiceChat: приложение для голосового AI-чата с ответами в реальном времени
Что такое RealtimeVoiceChat?
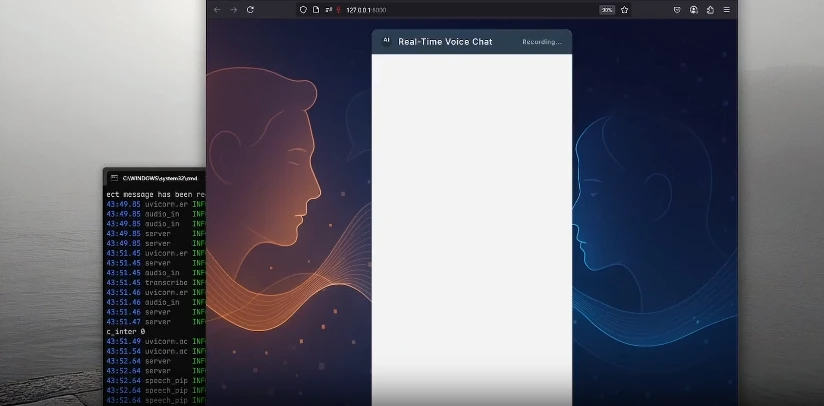
RealtimeVoiceChat — это проект с открытым исходным кодом, который позволяет вам общаться с интеллектуальной системой голосом и получать голосовые ответы в реальном времени. Он передаёт аудиофрагменты по сети, преобразует речь в текст, передаёт его интеллектуальной системе для обработки, а затем снова преобразует текст в речь. Этот проект поддерживает множество интеллектуальных систем (по умолчанию используется Ollama, также можно использовать Openai), а также позволяет гибко выбирать голосовые стили. Он использует клиент-серверную архитектуру, оптимизированную для низкой задержки, интеллектуально определяет очерёдность диалога, делая общение более плавным. Для развёртывания рекомендуется использовать Docker; при наличии графического процессора NVIDIA с поддержкой CUDA производительность будет выше.
Ключевые функции RealtimeVoiceChat
Потоковое голосовое взаимодействие: голос пользователя захватывается браузером, передаётся через WebSockets в Python-бэкенд, в реальном времени транскрибируется в текст, отправляется в LLM для обработки, после чего текстовый ответ преобразуется в речь и потоково возвращается пользователю.
Дизайн с низкой задержкой: оптимизированная архитектура с потоковой передачей аудиоблоков обеспечивает плавный диалог.
Интеллектуальное определение очерёдности: динамическое обнаружение тишины, автоматическое переключение права голоса в зависимости от ритма разговора.
Гибкий AI-бэкенд: поддержка множества LLM-бэкендов (по умолчанию Ollama, также поддерживается OpenAI).
Настраиваемый голос: можно выбирать различные движки преобразования текста в речь (например, Kokoro, Coqui, Orpheus).
Простой веб-интерфейс: пользовательский интерфейс, созданный с помощью Vanilla JS и Web Audio API.
Развёртывание через Docker: рекомендуется использовать Docker Compose для удобного управления зависимостями.
Особенности RealtimeVoiceChat
Взаимодействие в реальном времени: пользователь может вести диалог с AI голосом, а AI отвечает также голосом в реальном времени.
Слаженная работа компонентов: проект включает обработку аудио и взаимодействие UI на фронтенде, а также транскрипцию речи, обработку текста и синтез речи на бэкенде.
Конфигурируемость: поддержка множества движков TTS и моделей LLM, настройка через переменные окружения.
Технологический стек
Бэкенд: Python 3.x, FastAPI
Фронтенд: HTML, CSS, JavaScript (Vanilla JS, Web Audio API, AudioWorklets)
Коммуникация: WebSockets
Контейнеризация: Docker, Docker Compose
Основные библиотеки AI/ML: RealtimeSTT (преобразование речи в текст), RealtimeTTS (преобразование текста в речь), transformers (определение очерёдности, токенизация), torch/torchaudio (фреймворк машинного обучения), ollama/openai (клиенты LLM)
Обработка аудио: numpy, scipy
Установка и развёртывание
Установка через Docker (рекомендуется)
Клонируйте проект и перейдите в его каталог.
Соберите Docker-образ (будут загружены базовые образы, установлены зависимости Python/ML и предварительно загружены модели STT по умолчанию).
Запустите сервисы (App и Ollama).
Загрузите необходимые модели Ollama.
Откройте в браузере http://localhost:8000 и начните голосовой чат.
Ручная установка
Создайте и активируйте виртуальную среду Python.
Установите PyTorch (в зависимости от конфигурации оборудования).
Установите остальные зависимости (requirements.txt).
Запустите сервер FastAPI.
Откройте в браузере http://localhost:8000 и начните голосовой чат.
Настройка и кастомизация
Движок и голос TTS: настраивается в server.py и audio_module.py.
Бэкенд и модель LLM: настраивается в server.py и llm_module.py.
Параметры STT: настраивается в transcribe.py.
Чувствительность определения очерёдности: настраивается в turndetect.py.
SSL/HTTPS: настраивается в server.py.
Адрес проекта
Репозиторий на GitHub:https://github.com/KoljaB/RealtimeVoiceChat









