
 Помощник сценариста▸
 AI Приложения
 AI Новости
Muyan-TTS: открытая обучаемая модель TTS от Muyan для подкастов
小编 ·

Muyan-TTS: открытая обучаемая модель TTS от Muyan для подкастов
Что такое Muyan-TTS?
Muyan-TTS — это открытая и обучаемая модель TTS, выпущенная пекинской компанией Muyan Intelligent Language (沐言智语), разработанная специально для подкастов с бюджетом менее 50 000 долларов США. Muyan-TTS предварительно обучена на более чем 100 000 часов аудиоданных подкастов, поддерживает синтез TTS с нулевым количеством примеров (zero-shot), способна генерировать высококачественную речь, а также поддерживает адаптацию к говорящему с использованием нескольких десятков минут целевой речи.
Особенности модели Muyan-TTS
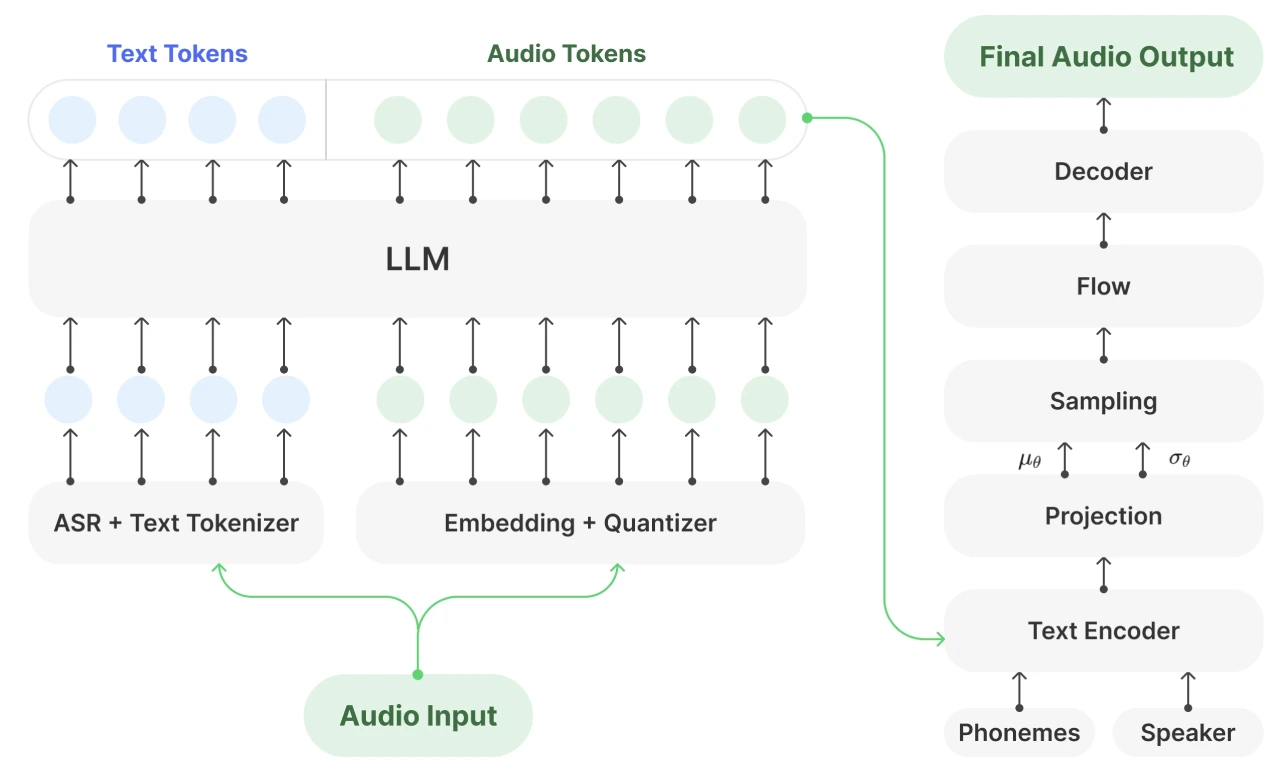
Крупномасштабное предварительное обучение: Muyan-TTS основана на модели Llama-3.2-3B и предварительно обучена на более чем 100 000 часов аудиоданных подкастов, что позволяет осуществлять синтез речи из текста с нулевым количеством примеров (zero-shot) и генерировать высококачественную речь.
Поддержка адаптации к говорящему: с помощью нескольких десятков минут речевых данных целевого говорящего Muyan-TTS может дополнительно адаптироваться к голосовым характеристикам конкретного говорящего, обеспечивая высокоиндивидуализированный синтез речи.
Архитектура: Muyan-TTS использует двухэтапную структуру GPT-SoVITS, где часть языковой модели продолжает предварительное обучение на основе Llama-3.2-3B, а в части декодера применяется архитектура SoVITS, сочетающая возможности семантического моделирования LLM и характеристики модели VITS для преобразования графем в фонемы (G2P), что эффективно снижает явление «галлюцинаций».
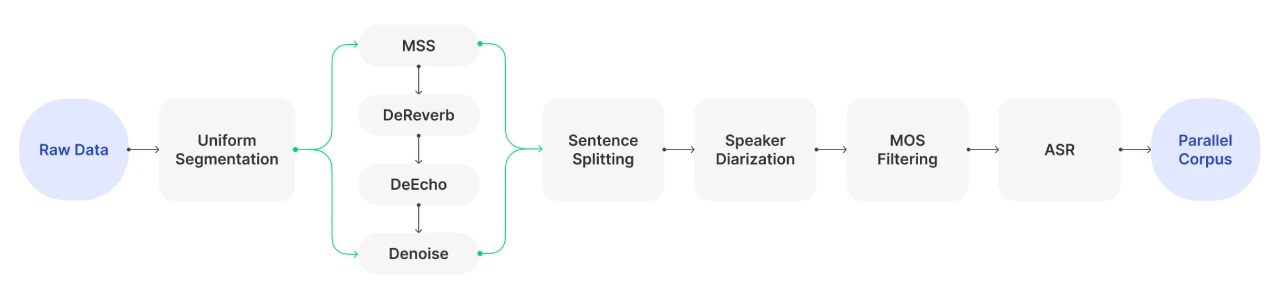
Обработка данных: создан параллельный корпус, содержащий более 100 000 часов высококачественной речи и соответствующих транскрипций, подходящий для обучения TTS в таких сценариях с длинным аудио, как подкасты.
Открытый исходный код и обучение
Информация об открытом исходном коде: Muyan-TTS полностью открыта, предоставляет полный процесс сбора и обработки данных, подробные методы обучения и оптимизированный фреймворк для инференса. Её код и модель доступны на GitHub.
Стоимость обучения: что касается стоимости обучения, при условии, что цена аренды графических процессоров A10 и A100 составляет 0,5 и 1 доллар США в час соответственно, общая стоимость обучения Muyan-TTS составляет примерно 50 540 долларов США.
Производительность
Синтез с нулевым количеством примеров (zero-shot): на наборе данных LibriSpeech Muyan-TTS демонстрирует выдающуюся производительность синтеза с нулевым количеством примеров: её частота ошибок на уровне слов (WER) уступает только CosyVoice2, а средняя оценка мнений (MOS) выше, чем у Spark-TTS и GPT-SoVITS v3.
Модель с дообучением на контролируемых данных: Muyan-TTS-SFT после дообучения превосходит базовую модель по качеству речи и сходству с говорящим, но при этом WER немного увеличивается.
Скорость инференса: Muyan-TTS демонстрирует самую высокую скорость инференса среди всех протестированных моделей — для синтеза 1 секунды речи требуется всего 0,33 секунды, что делает её подходящей для сценариев генерации речи в реальном времени.
Сценарии применения Muyan-TTS
Muyan-TTS подходит для различных форм аудиоконтента, таких как закадровый голос ведущего, воспроизведение интервью, речевые резюме и т. д. Модель сочетает в себе качество синтеза, возможности персонализации и эффективность работы, подходя для сценариев с длинным аудио, таких как подкасты.
Ограничения
Зависимость от модуля G2P в декодере: для синтеза требуется полная последовательность фонем, что делает невозможным потоковый инференс.
Обучающие данные в основном представлены на английском языке, поэтому возможности многоязычного синтеза речи ограничены.
Из-за отсутствия разметки на уровне инструкций в обучающем корпусе Muyan-TTS в настоящее время не поддерживает задачи TTS, управляемые инструкциями.
Установка и использование Muyan-TTS
Шаги установки
1. Клонируйте репозиторий и создайте виртуальную среду:
git clone https://github.com/MYZY-AI/Muyan-TTS.git
cd Muyan-TTS
conda create -n muyan-tts python=3.10 -y
conda activate muyan-tts
make build
2. Установите FFmpeg (система Ubuntu):
sudo apt update
sudo apt install ffmpeg
3. Загрузите модели:
Модели Muyan-TTS и Muyan-TTS-SFT можно загрузить с Hugging Face или ModelScope.
Также необходимо загрузить веса chinese-hubert-base.
Поместите все загруженные модели в каталог pretrained_models.
Использование
Выполните следующую команду для синтеза речи:
python tts.py
Основной код инференса выглядит следующим образом:
async def main(model_type, model_path):
tts = Inference(model_type, model_path, enable_vllm_acc=False)
wavs = await tts.generate(
ref_wav_path="assets/Claire.wav",
prompt_text="Although the campaign was not a complete success, it did provide Napoleon with valuable experience and prestige.",
text="Welcome to the captivating world of podcasts, let's embark on this exciting journey together."
)
output_path = "logs/tts.wav"
with open(output_path, "wb") as f:
f.write(next(wavs))
print(f"Speech generated in {output_path}")
Репозиторий на GitHub:https://github.com/MYZY-AI/Muyan-TTS









