
 Помощник сценариста▸
 AI Приложения
 AI Новости
Xiaomi MiMo: первая открытая LLM Xiaomi, созданная для рассуждений
小编 ·

Xiaomi MiMo: первая открытая LLM Xiaomi, созданная для рассуждений
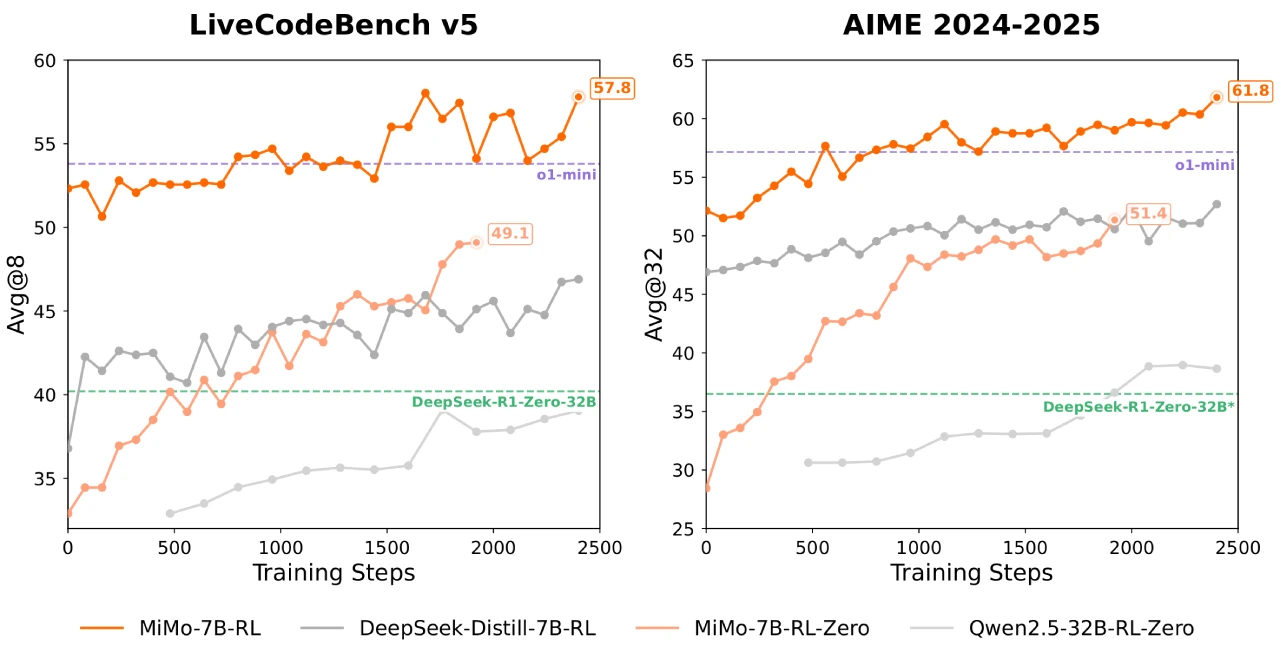
Xiaomi MiMo — это первая большая модель ai, «рождённая для рассуждений», открытый исходный код которой был объявлен компанией Xiaomi 30 апреля 2025 года. Серия моделей MiMo-7B раскрывает потенциал рассуждений языковых моделей в полной мере, уделяя внимание не только пост-обучению, но и стратегиям предварительного обучения, ориентированным на рассуждения. Серия моделей при относительно небольшом масштабе в 7B демонстрирует возможности рассуждений, превосходящие многие модели с 32B параметрами, при этом MiMo-7B-RL показывает результаты в задачах математического и программного рассуждения, сопоставимые с OpenAI o1-mini.
Ключевые особенности MiMo
Предварительное обучение
Оптимизация предварительной обработки данных: улучшен пакет инструментов для извлечения текста, применяется многомерная фильтрация данных, что увеличивает плотность шаблонов рассуждений в данных предварительного обучения.
Генерация синтетических данных: использование различных стратегий для генерации большого объёма разнообразных синтетических данных рассуждений.
Трёхэтапное смешивание данных: при предварительном обучении применяется стратегия трёхэтапного смешивания данных, MiMo-7B-Base проходит предварительное обучение приблизительно на 25 триллионах токенов.
Многотокенное предсказание: введение многотокенного предсказания в качестве дополнительной цели обучения повышает производительность модели и ускоряет логический вывод.
Пост-обучение
Качественные обучающие данные: тщательно отобраны 130K математических задач и задач по программированию в качестве данных для RL-обучения, каждая задача проходит тщательную очистку и оценку сложности, а для обеспечения качества данных используются валидаторы на основе правил.
Механизм вознаграждения за код: для сложных задач по программированию введено вознаграждение, управляемое сложностью тестов, путём назначения детализированных баллов тестовым случаям различной сложности для оптимизации стратегии.
Перевыборка данных: стратегия перевыборки данных для простых задач повышает эффективность скользящей выборки и стабилизирует обновление стратегии.
Инфраструктура RL
Бесшовный движок развёртывания: разработан бесшовный движок развёртывания, объединяющий непрерывное развёртывание, асинхронное вычисление вознаграждений и функцию досрочного завершения, что сокращает время простоя GPU и обеспечивает ускорение обучения в 2,29 раза и валидации в 1,96 раза.
Поддержка MTP: поддержка MTP в vLLM и повышение надёжности движка логического вывода в RL-системе.
Версии моделей MiMo
MiMo-7B-Base: базовая модель с выдающимся потенциалом рассуждений
MiMo-7B-RL-Zero: RL-модель, обученная от базовой модели
MiMo-7B-SFT: SFT-модель, обученная от базовой модели
MiMo-7B-RL: RL-модель, обученная от SFT-модели, производительность сопоставима с OpenAI o1-mini.
Технические детали и инновации
Оптимизация данных предварительного обучения: за счёт многомерной фильтрации данных и генерации синтетических данных рассуждений повышены качество данных предварительного обучения и плотность шаблонов рассуждений.
Модуль MTP: внедрение модуля MTP в предварительное обучение значительно повышает производительность в задачах рассуждения и скорость логического вывода.
RL-инфраструктура: разработан бесшовный движок развёртывания (Seamless Rollout Engine), ускоряющий процессы RL-обучения и валидации, обеспечивающий ускорение в 2,29 и 1,96 раза соответственно.
Механизм вознаграждения, управляемый сложностью тестов: для решения проблемы разреженного вознаграждения в задачах по программированию предложен механизм вознаграждения, основанный на сложности тестов, что повышает эффективность обучения модели на сложных задачах.
Эксперименты и результаты
Производительность предварительно обученной модели
MiMo-7B-Base: превосходит другие открытые модели с 7B параметрами в ряде бенчмарков, таких как BBH, SuperGPQA и других.
Оценка потенциала рассуждений: для оценки потенциала рассуждений используется метрика pass@k, MiMo-7B-Base демонстрирует более высокие значения pass@k во всех бенчмарках.
Производительность моделей после пост-обучения
MiMo-7B-RL-Zero: RL-обучение непосредственно от MiMo-7B-Base демонстрирует мощные способности к рассуждению.
MiMo-7B-RL: RL-обучение от SFT-модели, в итоге превосходит модель OpenAI o1-mini в задачах по математике и программированию.
Конкретные результаты:
В AIME 2025 MiMo-7B-RL набирает 55,4 балла, что на 4,7 балла больше, чем o1-mini.
В LiveCodeBench v5 и v6 MiMo-7B-RL значительно превосходит o1-mini.
Ссылки по теме
Платформа Hugging Face:https://huggingface.co/XiaomiMiMo
Репозиторий GitHub:https://github.com/XiaomiMiMo/MiMo
Технический отчёт:https://github.com/XiaomiMiMo/MiMo/blob/main/MiMo-7B-Technical-Report.pdf









