
 Помощник сценариста▸
 AI Приложения
 AI Новости
No-OCR: инструмент обработки документов без OCR-извлечения текста
小编 ·

No-OCR: инструмент обработки документов без OCR-извлечения текста
Что такое No-OCR?
No-OCR — это инструмент для обработки документов, не требующий сложного извлечения текста с помощью OCR. Достаточно загрузить PDF-файл, чтобы быстро искать или запрашивать содержимое в нескольких коллекциях документов, не полагаясь на традиционные технологии OCR, что повышает эффективность анализа документов. Он поддерживает создание и управление коллекциями PDF/документов с организацией по «кейсам», а также автоматически формирует датасеты в стиле Hugging Face. Кроме того, No-OCR обладает функцией поиска по векторным представлениям страниц PDF и связанных изображений (с использованием LanceDB), а также реализует визуальный вопрос-ответ по изображениям и диаграммам с помощью Qwen2-VL. Поддерживается гибридный поиск по текстовым и визуальным запросам, возможно быстрое развёртывание через Docker с простой настройкой, а также предоставляются подробные инструкции по установке для разработки.
Особенности No-OCR
Без OCR: полностью независим от технологий OCR, подходит для PDF-файлов с насыщенным визуальным содержимым.
Простота использования: после загрузки PDF-файла можно выполнять поиск, поддерживается сложное визуальное содержимое (таблицы, диаграммы, макеты и т.д.).
Открытые модели: поиск и интерпретация содержимого на базе открытых LLM (больших языковых моделей).
Возможность развёртывания: поддержка Docker-развёртывания, подходит для любой корпоративной среды.
Сценарии использования No-OCR
Подходящие сценарии: если документ содержит насыщенное визуальное содержимое (таблицы, диаграммы, макеты и т.д.), No-OCR станет отличным выбором.
Неподходящие сценарии: если документ содержит преимущественно простой текст, более уместным может оказаться традиционный поиск BM25.
Смешанное содержимое: если документ содержит сочетание текста и визуального контента, возможно, потребуется адаптировать решение в зависимости от потребностей.
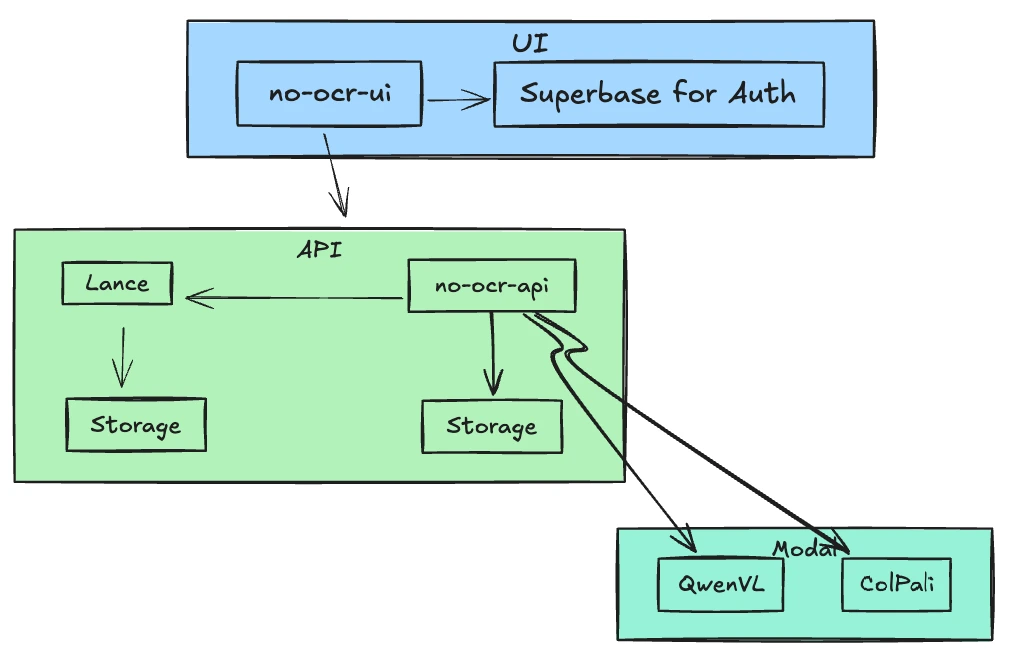
Архитектура No-OCR
Простая архитектура: не зависит от баз данных или очередей сообщений, все операции персистентности основаны на файловой системе.
Основные сервисы:
Modal: для развёртывания LLM.
Qdrant: для многовекторного поиска.
Supabase: для аутентификации и авторизации пользователей.
Создание кейса: пользователь загружает PDF-файл и указывает имя кейса, система преобразует PDF в датасет и загружает его в Qdrant.
Процесс поиска: пользователь вводит поисковый запрос, система с помощью LLM определяет релевантные страницы и интерпретирует содержимое.
Модели LLM в No-OCR
Семейство ColPali: используется для поиска по изображениям, преобразуя изображения в формат, пригодный для поиска.
Семейство Qwen2-VL: используется для логического вывода по визуальному содержимому, в частности модель Qwen2-VL-7B-Instruct, являющаяся одной из самых передовых открытых визуальных моделей на сегодняшний день.
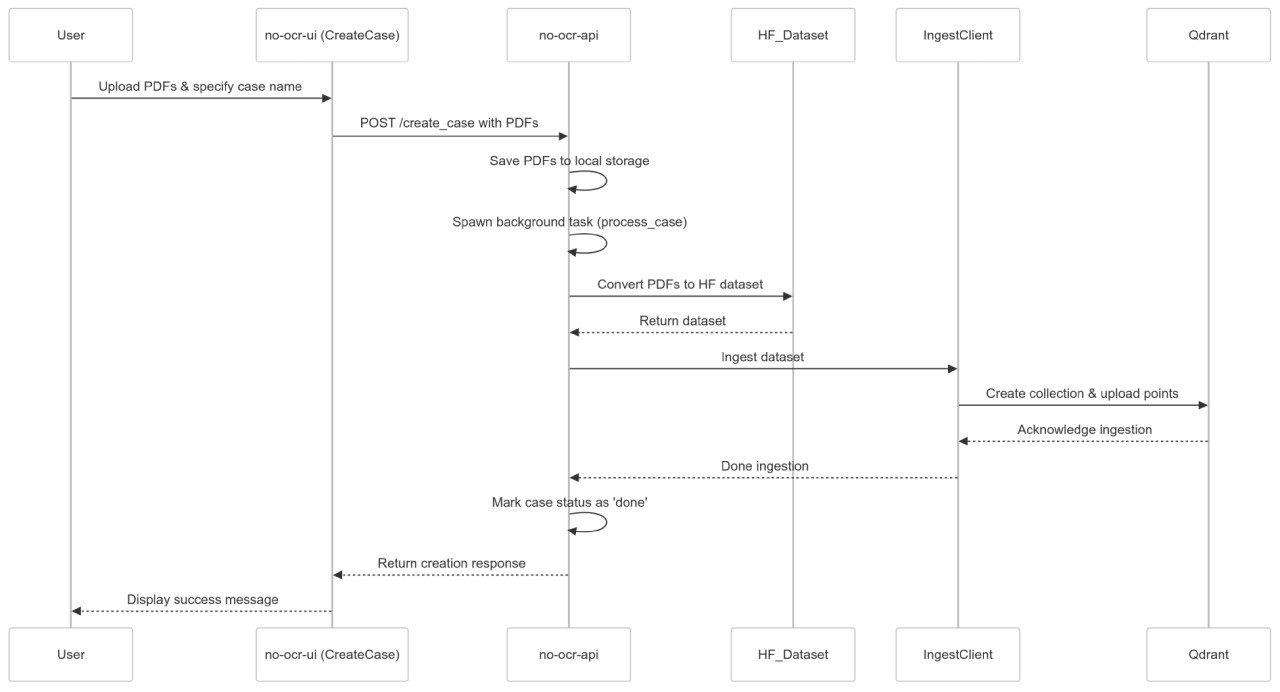
Процесс создания кейса
Принцип работы
Платформа No-OCR использует упрощённый подход RAG: пользователю достаточно загрузить PDF-файлы для создания кейса, система обработает эти файлы и сделает их доступными для поиска. Пользователь может задавать любые вопросы, включая вопросы о визуальных элементах, а платформа будет предоставлять ответы с использованием лучших открытых моделей логического вывода.
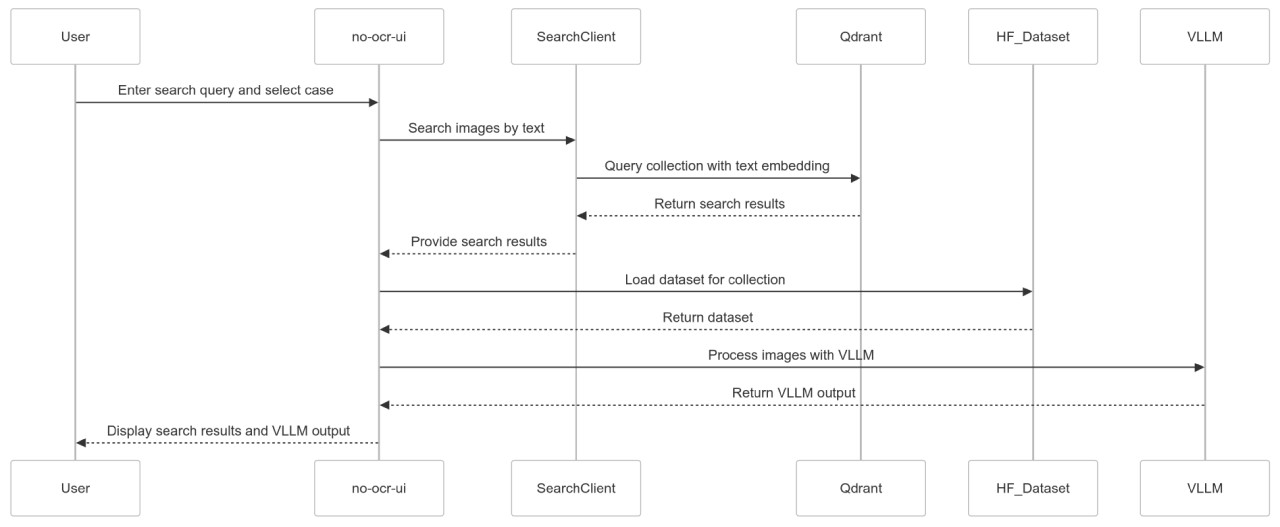
Процесс поиска
Шаги использования No-OCR
Загрузка и обработка сложных PDF: пользователь загружает PDF-файлы со сложной структурой для создания нового кейса, система генерирует эмбеддинги без сложной обработки OCR.
Обеспечение возможности поиска: после обработки пользователь может выполнять текстовые запросы для быстрого поиска релевантных страниц и ссылок, независимо от сложности макета PDF.
Задавание вопросов о визуальном содержимом: платформа быстро находит релевантные страницы, а затем дополнительно уточняет ответ с помощью специализированных открытых визуальных моделей, предоставляя контекстно-зависимые выводы даже при наличии в PDF диаграмм или графиков.
TLDR:https://no-ocr.com/about
Github:https://github.com/kyryl-opens-ml/no-ocr









