
 Помощник сценариста▸
 AI Приложения
 AI Новости
Video-R1: первая в мире модель R1 для видео, совместно представленная CUHK и Университетом Цинхуа
小编 ·

Video-R1: первая в мире модель R1 для видео, совместно представленная CUHK и Университетом Цинхуа
Что такое Video-R1?
Video-R1 — это первая в мире модель R1 для видео, совместно разработанная Китайским университетом Гонконга и Университетом Цинхуа. Она способна улучшать возможности видео-рассуждений мультимодальных больших языковых моделей (MLLM) с помощью обучения с подкреплением.
Функции Video-R1
Рассуждения с учётом времени: Video-R1 представляет алгоритм T-GRPO, который, сравнивая видеокадры на переупорядоченных и последовательных входных данных, побуждает модель использовать временную информацию для рассуждений, обеспечивая лучшее понимание временных связей в видео.
Обучение на смешанных данных: для решения проблемы нехватки высококачественных данных для видео-рассуждений Video-R1 использует набор данных, объединяющий изображения и видео, включая Video-R1-COT-165k (для холодного старта SFT) и Video-R1-260k (для обучения с подкреплением), что позволяет модели переносить способности к рассуждению на основе статических изображений на динамическое видео.
Разнообразные типы вывода: Video-R1 поддерживает различные типы вывода ответов, включая множественный выбор, числовые значения, OCR, свободную форму и регрессию.
Поведение саморефлексии при рассуждениях: в процессе рассуждений модель выполняет саморефлексию, корректируя направление рассуждений для получения более точных выводов. Такой «момент эврики» указывает на то, что модель активно осуществляет внутреннюю обратную связь.
Технология Video-R1
Алгоритм T-GRPO с учётом времени: этот алгоритм усиливает способность модели понимать временные последовательности, позволяя ей глубоко анализировать причинно-следственные связи между событиями. По сравнению с традиционным алгоритмом GRPO, T-GRPO связывает понимание времени через механизм вознаграждения, благодаря чему модель получает награду только тогда, когда доля правильных ответов на последовательных входных данных выше.
Смешанный набор данных изображений и видео: исследователи создали два высококачественных набора данных: Video-R1-COT-165k (преимущественно изображения) и Video-R1-260k (с упором на высококачественное видео), что решает проблему нехватки данных для видео-рассуждений. Такой смешанный подход к обучению позволяет модели перейти от «описания картинки» к «глубокому осмыслению видео», обеспечивая полноценное мультимодальное понимание.
Стратегия обучения с подкреплением: Video-R1 обучается с помощью обучения с подкреплением, в ходе которого модель постепенно отказывается от неоптимальных шаблонов рассуждений и формирует более эффективные и логичные пути выражения.
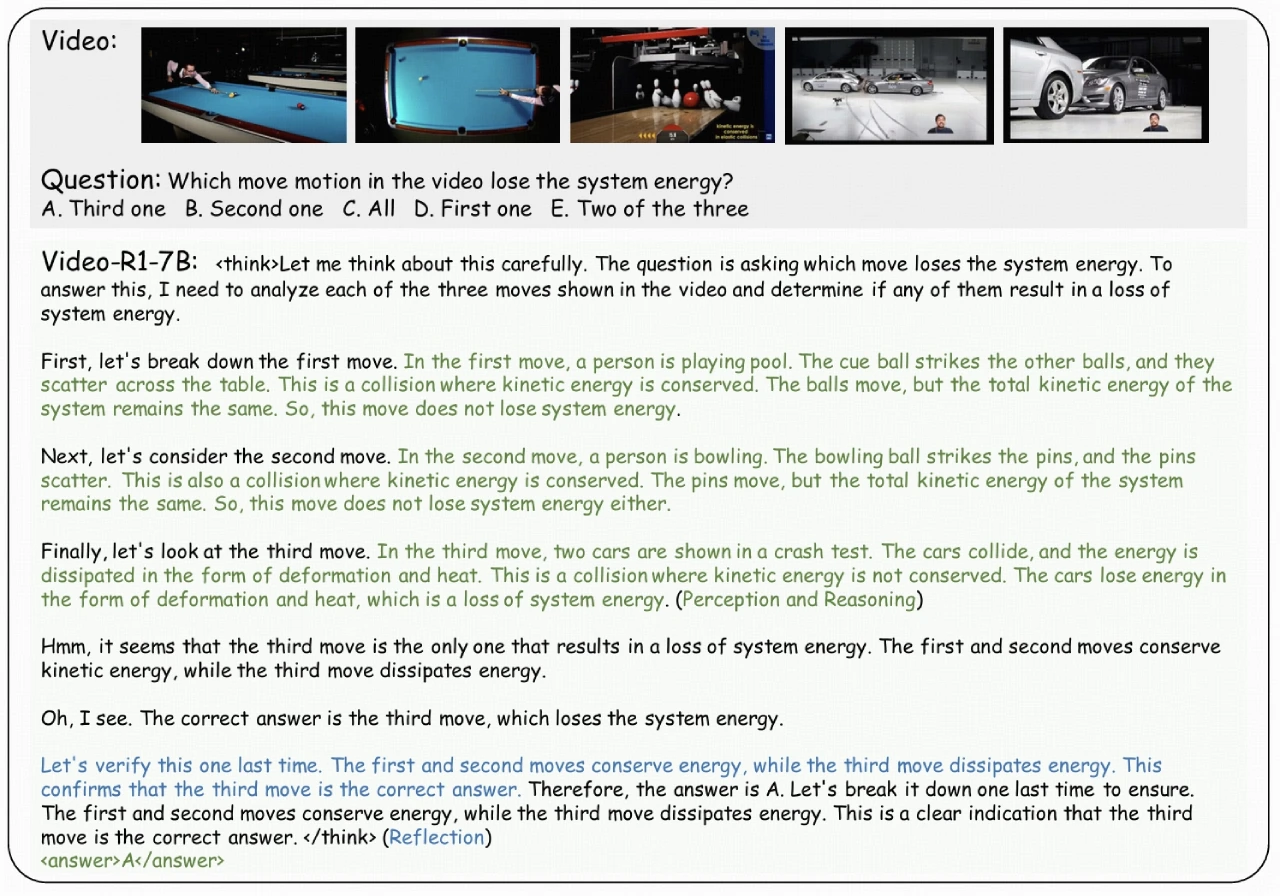
Применение Video-R1
Анализ видеоконтента: Video-R1 способен эффективно анализировать и понимать динамический контент в видео, что может использоваться для автоматической генерации ключевых видеофрагментов, распознавания действий и интеллектуального создания тегов.
Поиск и рекомендации видео: благодаря глубоким рассуждениям Video-R1 может более точно понимать потребности пользователей и предлагать видеоконтент, соответствующий их интересам.
Визуальное понимание в автономном вождении: модель способна понимать временные связи и причинно-следственную логику в видео, что помогает системам автономного вождения лучше воспринимать и прогнозировать дорожную обстановку.
Видеонаблюдение и безопасность: Video-R1 может применяться для анализа видео с камер наблюдения в реальном времени, быстрого распознавания аномального поведения или событий и повышения общественной безопасности.
Образование и подготовка кадров: в сфере образования Video-R1 может использоваться в интеллектуальных системах репетиторства, которые анализируют содержание учебных видео и предоставляют учащимся персонализированные рекомендации по обучению.
Умный дом: модель можно интегрировать в системы умного дома, где с помощью видеоанализа осуществляется более интеллектуальное восприятие окружающей среды и автоматизированное управление.
Адрес на GitHub:https://github.com/tulerfeng/Video-R1
Статья:https://arxiv.org/abs/2503.21776









