
 Помощник сценариста▸
 AI Приложения
 AI Новости
WeClone: дообучение LLM на истории чатов WeChat для создания персонального цифрового двойника
小编 ·

WeClone: дообучение LLM на истории чатов WeChat для создания персонального цифрового двойника
Что такое WeClone?
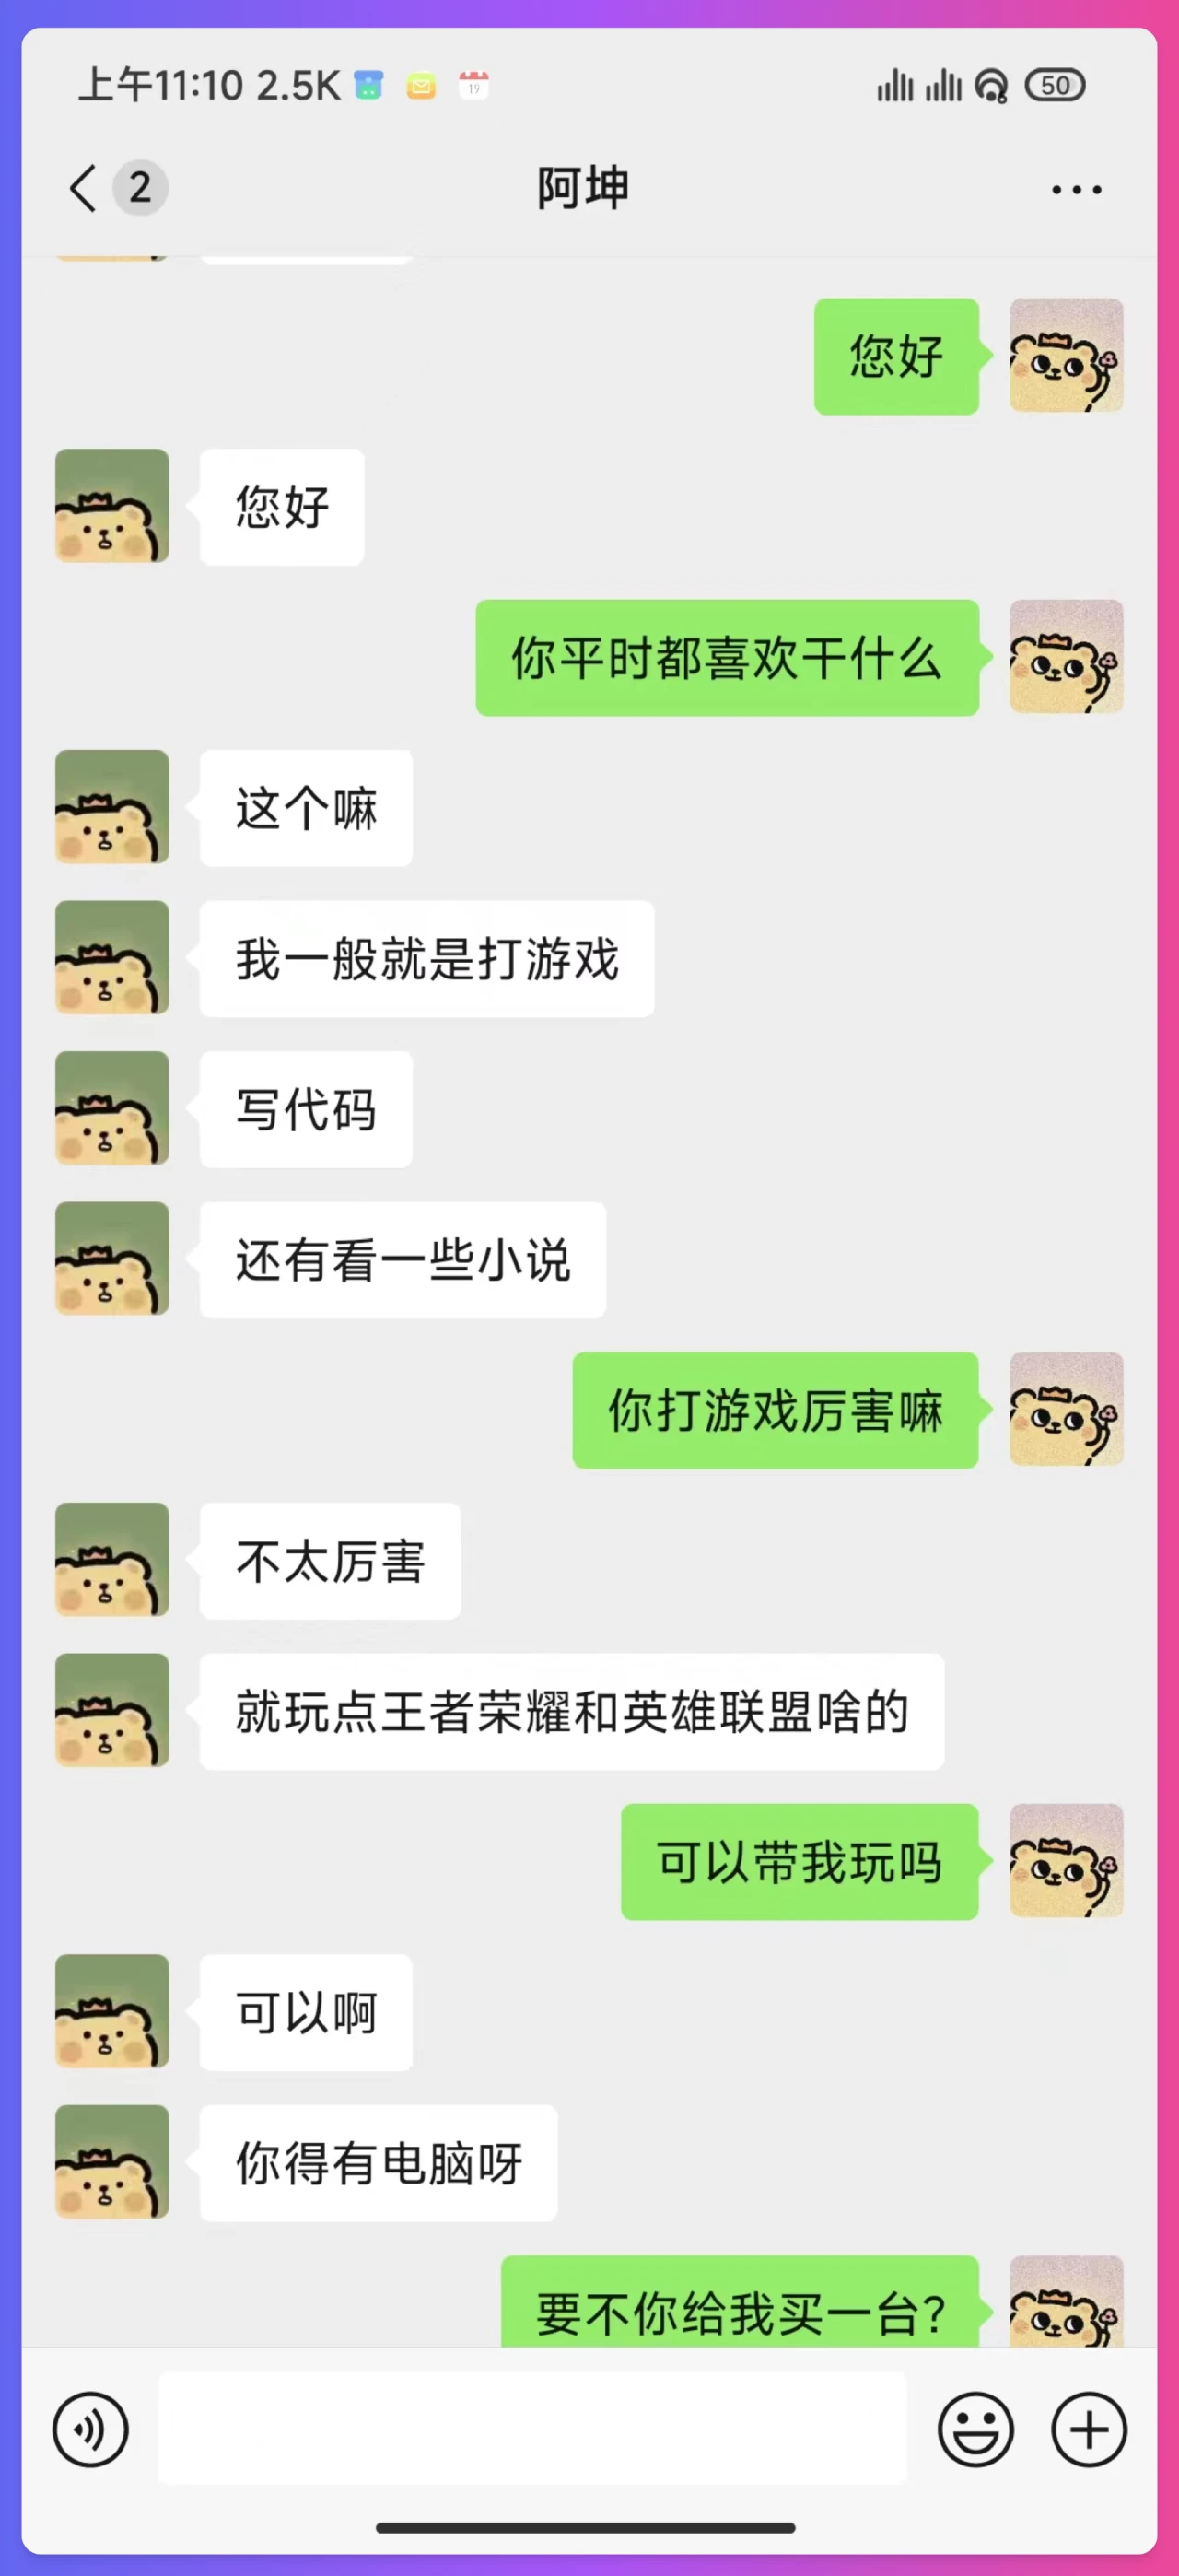
WeClone — это проект с открытым исходным кодом, предназначенный для тонкой настройки больших языковых моделей (LLM) на основе истории чатов WeChat, а также для реализации высококачественного клонирования голоса с использованием голосовых сообщений WeChat и большой модели, с возможностью последующей привязки к WeChat-боту для создания персонального AI-цифрового двойника.
Функции WeClone
Тонкая настройка LLM с использованием истории чатов WeChat: модель дообучается на собственной истории чатов пользователя, чтобы лучше соответствовать индивидуальному стилю и привычкам речи.
Высококачественное клонирование голоса: объединение голосовых сообщений WeChat с моделью 0.5B обеспечивает высококачественное клонирование голоса.
Привязка к WeChat-боту: дообученная модель привязывается к WeChat-боту для реализации автоматических ответов и других функций, формируя персонального цифрового двойника.
Особенности WeClone
Требования к оборудованию: по умолчанию используется модель chatglm3-6b, для тонкой настройки методом LoRA требуется около 16 ГБ видеопамяти. Другие модели и методы можно настроить самостоятельно.
Требования к программному обеспечению: рекомендуется Python 3.10, а также определённые версии библиотек PyTorch, Transformers и других.
Настройка среды: клонирование проекта через Git, создание окружения с помощью Conda и установка зависимостей.
Подготовка данных: использование PyWxDump для извлечения истории чатов WeChat и экспорт в формат CSV.
Предварительная обработка данных: удаление конфиденциальной информации, поддержка нескольких способов обработки данных.
Загрузка модели: рекомендуется загружать модель ChatGLM3 с Hugging Face или сообщества魔搭 (ModelScope).
Тонкая настройка модели: изменение параметров конфигурации в файле settings.json для обучения на одной или нескольких GPU.
Инференс и тестирование: предоставляются демо-версия в браузере и функции инференса через API, поддерживается тестирование типовых вопросов чата.
Развёртывание WeChat-бота: вход через сканирование QR-кода, поддержка взаимодействия с ботом в личных и групповых чатах.
Шаги по использованию WeClone
Настройка среды
Клонирование проекта: выполните следующую команду в терминале, чтобы клонировать проект WeClone локально.
git clone https://github.com/xming521/WeClone.git
Создание и активация виртуального окружения: создайте новое окружение Python с помощью Conda и активируйте его.
conda create -n weclone python=3.10
conda activate weclone
Установка зависимостей: перейдите в каталог проекта и установите необходимые пакеты зависимостей.
cd WeClone
pip install -r requirements.txt
Подготовка данных
Извлечение истории чатов WeChat: используйте программу PyWxDump для извлечения истории чатов WeChat. Загрузите и установите эту программу, после расшифровки базы данных нажмите «Резервное копирование чата» (聊天备份), выберите тип экспорта CSV. Можно экспортировать историю чатов нескольких контактов или групповых чатов.
Размещение данных: папку csv, экспортированную из wxdump_tmp/export, поместите в каталог ./data проекта, то есть папки с историей чатов разных людей вместе поместите в ./data/csv. Пример данных находится в data/example_chat.csv.
Предварительная обработка данных
Удаление конфиденциальной информации: проект по умолчанию удаляет из данных номера телефонов, идентификационные номера, адреса электронной почты, URL-адреса и другую конфиденциальную информацию. Кроме того, предоставляется словарь стоп-слов blocked_words, в который можно добавлять слова и фразы, требующие фильтрации; программа по умолчанию будет удалять целые предложения, содержащие стоп-слова.
Обработка формата данных: выполните скрипт ./make_dataset/csv_to_json.py для обработки данных. В случае, когда один и тот же человек подряд отвечает несколькими предложениями, можно выбрать один из следующих трёх способов обработки:
Использование csv_to_json.py: объединение нескольких ответов запятыми.
Использование csv_to_json-单句回答.py (устарело): выбирается только самый длинный ответ в качестве итоговых данных.
Использование csv_to_json-单句多轮.py: несколько ответов помещаются в 'history' промпта.
Загрузка модели
Предпочтительно Hugging Face: загрузите модель ChatGLM3 с Hugging Face. Если при загрузке модели с Hugging Face возникнут проблемы, можно использовать модель из сообщества 魔搭 (ModelScope).
Использование сообщества 魔搭 (ModelScope): если вы выбираете модель из сообщества 魔搭, сначала выполните следующую команду для использования модели из сообщества 魔搭.
export USE_MODELSCOPE_HUB=1 # В Windows используйте `set USE_MODELSCOPE_HUB=1`
git lfs install
git clone https://www.modelscope.cn/ZhipuAI/chatglm3-6b.git
Примечание: файл modeling_chatglm.py из сообщества 魔搭 необходимо заменить на версию с Hugging Face.
Настройка параметров и тонкая настройка модели
Изменение конфигурационного файла: конфигурация, связанная с обучением и инференсом, находится в файле settings.json. При необходимости можно изменить следующие параметры:
Измените per_device_train_batch_size и gradient_accumulation_steps для регулировки использования видеопамяти.
Измените параметры num_train_epochs, lora_rank, lora_dropout и другие в зависимости от количества и качества набора данных.
(Необязательно) Измените settings.json, чтобы выбрать другую локально загруженную модель.
Обучение на одной GPU: выполните следующую команду для тонкой настройки на этапе sft.
python src/train_sft.py
Автор говорит, что его собственное значение loss снизилось только примерно до 3,5; чрезмерное снижение может привести к переобучению, он использовал около 20 000 интегрированных валидных данных.
Обучение на нескольких GPU: при наличии нескольких видеокарт можно использовать deepspeed для обучения на нескольких GPU. Сначала установите deepspeed, затем выполните следующую команду.
pip install deepspeed
deepspeed --num_gpus=количество_используемых_видеокарт src/train_sft.py
Инференс и тестирование
Простой инференс с использованием браузерного демо: проект предоставляет браузерное демо для простого тестирования инференса.
Инференс с использованием API: выполните следующую команду для запуска API-сервиса.
python ./src/api_service.py
Тестирование типовых вопросов чата: выполните следующую команду для тестирования типовых вопросов чата.
python ./src/test_model.py
Развёртывание WeChat-бота
Запуск API-сервиса: сначала выполните следующую команду для запуска API-сервиса.
python ./src/api_service.py
Запуск скрипта WeChat-бота: затем выполните следующую команду для запуска WeChat-бота.
python ./src/wechat_bot/main.py
По умолчанию QR-код отображается в терминале, отсканируйте его для входа. Можно использовать в личных сообщениях или путём @-упоминания бота в групповых чатах.
Примечания: существует риск блокировки аккаунта WeChat, рекомендуется использовать дополнительный аккаунт, кроме того, для использования необходимо привязать банковскую карту.
errer noopener">модуль клонирования голоса (WeClone-audio)
Решение Spark-TTS (рекомендуется):
Импортируйте необходимые модули.
import SparkTTS
from SparkTTS import SparkTTS
Инициализируйте модель.
model = SparkTTS("WeClone-audio/pretrained_models/Spark-TTS-0.5B", "cuda")Выполните инференс клонирования голоса.
with torch.no_grad():
wav = model.inference(
text="要生成的文本内容",
prompt_speech_path="示例音频路径",
prompt_text="示例音频对应的文本",
)
Решение Llasa:
Импортируйте необходимые модули.
from text_to_speech import TextToSpeech
Инициализируйте и выполните инференс.
tts = TextToSpeech(sample_audio_path, sample_audio_text)
result = tts.infer("要生成的文本内容")
Адрес на Github:https://github.com/xming521/WeClone









