
 Помощник сценариста▸
 AI Приложения
 AI Новости
PDF Document Layout Analysis: сервис анализа макета PDF и PDF OCR на базе Docker
小编 ·

PDF Document Layout Analysis: сервис анализа макета PDF и PDF OCR на базе Docker
Что такое PDF Document Layout Analysis?
PDF Document Layout Analysis — это сервис на базе Docker, предназначенный для анализа макета PDF-документов. Он способен выполнять сегментацию и классификацию различных частей страниц PDF, точно автоматически распознавая в страницах PDF такие элементы, как текст, заголовки, изображения, таблицы и т. д., а также определяя правильный порядок этих элементов.
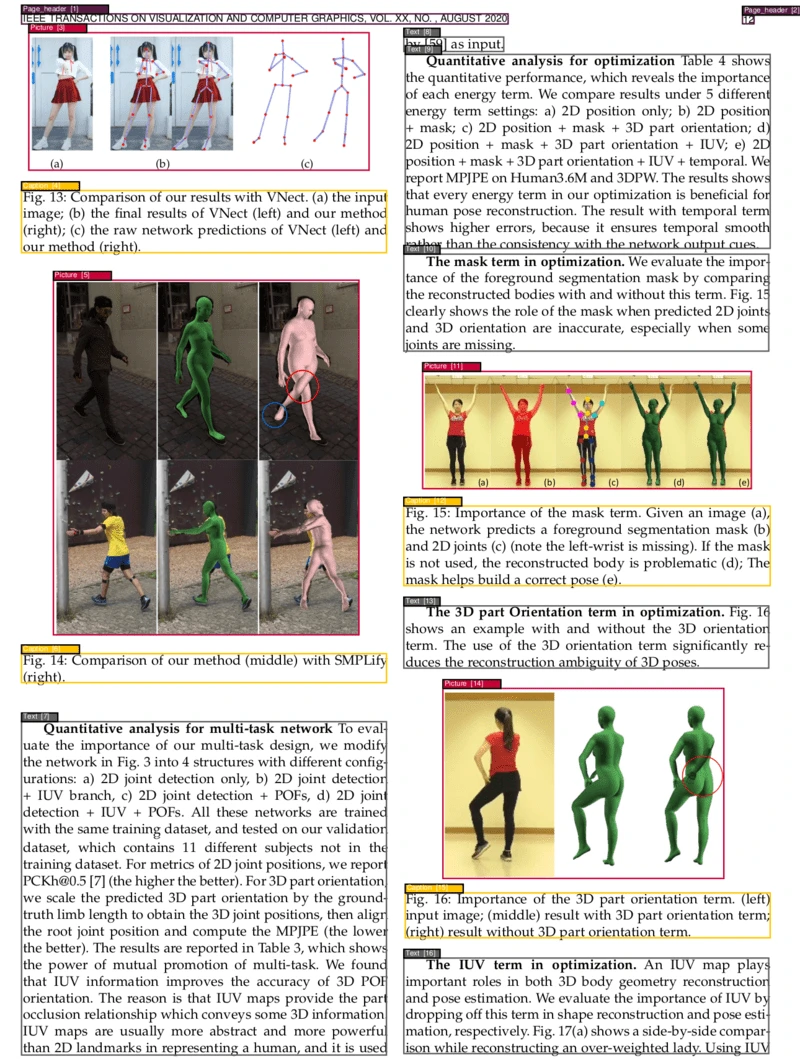
Функциональные возможности PDF Document Layout Analysis
1. Функция OCR
Многоязычная поддержка: поддерживается OCR для множества языков; пользователи могут обрабатывать PDF-документы на разных языках, указывая параметр языка.
Извлечение текста: преобразование изображений или неиндексируемого текста в PDF в индексируемый текстовый формат, удобный для последующей обработки и анализа.
2. Сегментация и классификация страниц
Распознавание множества элементов: способен распознавать и классифицировать в страницах PDF следующие элементы:
Текст: обычное текстовое содержимое.
Заголовки: заголовки и подзаголовки документа.
Изображения: изображения на странице.
Таблицы: содержимое таблиц.
Формулы: математические формулы с поддержкой вывода в формате LaTeX.
Элементы списков: нумерованные или маркированные списки.
Колонтитулы: верхние и нижние колонтитулы страницы.
Сноски: сноски в документе.
Прочее: например, подписи к изображениям, заголовки таблиц и т. д.
Точная классификация: использование передовых визуальных моделей (например, Vision Grid Transformer — VGT) и моделей машинного обучения (например, LightGBM) обеспечивает высокую точность результатов классификации.
3. Упорядочивание элементов
Логический порядок: на основе макета страницы и типа элементов автоматически определяется логический порядок элементов, благодаря чему выходной результат соответствует порядку чтения документа.
Настраиваемые правила сортировки: элементы сортируются с учётом исходного порядка чтения Poppler и типов абзацев, что обеспечивает логичность и связность вывода.
4. Визуализация результатов
Визуализированный PDF: поддерживается визуализация результатов анализа в виде нового PDF-файла, что позволяет наглядно просматривать результаты сегментации и классификации.
Функция аннотирования: в визуализированном выводе элементы разных типов выделяются различными цветами или стилями для удобства различения.
5. Извлечение таблиц и формул
Извлечение таблиц: поддерживается извлечение таблиц в различных форматах, таких как Markdown, LaTeX или HTML, для дальнейшей обработки и анализа.
Извлечение формул: формулы выводятся в формате LaTeX, что удобно для использования в академических и технических документах.
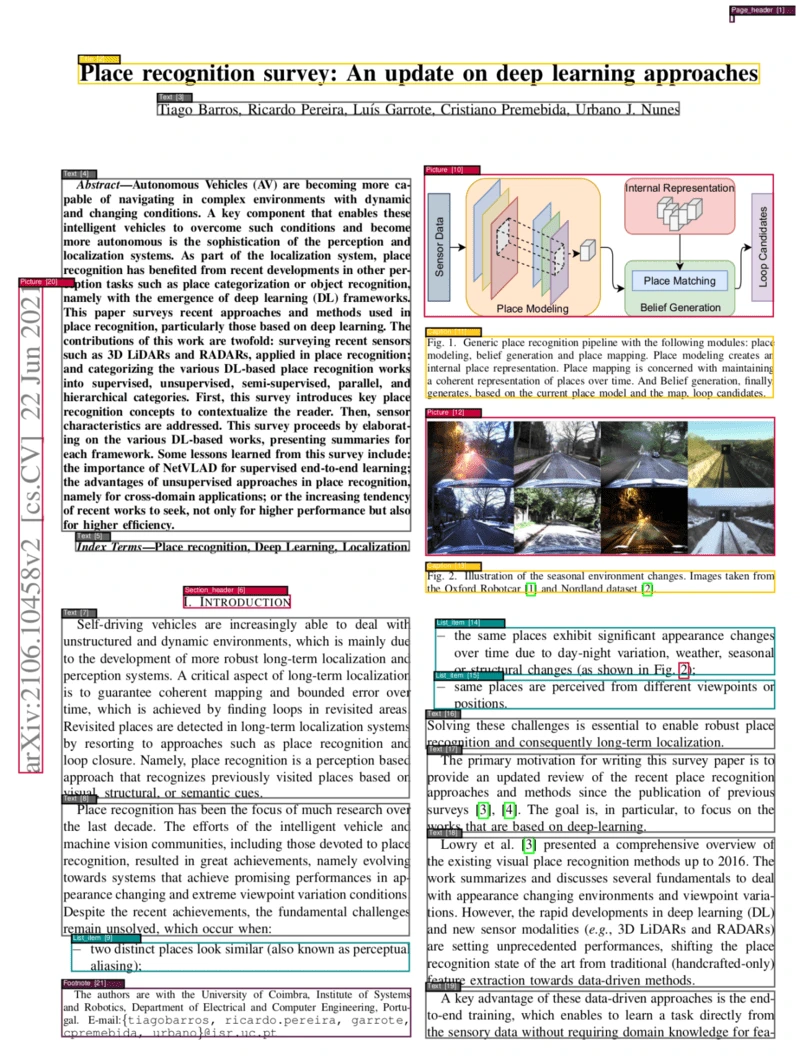
Сценарии применения PDF Document Layout Analysis
Академические исследования: извлечение и организация текста, рисунков, таблиц и списков литературы из научных статей, что удобно для обзоров литературы и анализа данных.
Анализ юридических документов: анализ и структурирование юридических документов, контрактов и материалов дел.
Бизнес-отчёты: автоматическое извлечение финансовых данных, диаграмм и ключевых показателей для формирования выводов и кратких отчётов.
Архивы и оцифровка: оцифровка и систематизация исторических документов, рукописей и архивов с сохранением в удобном для поиска формате.
Издательская деятельность и медиа: организация и форматирование содержимого рукописей, статей и отчётов для обеспечения единообразия и качества.
Быстрый старт
Запуск сервиса: поддерживаются режимы с GPU и без GPU.
Функция OCR: поддерживается множество языков, вызов осуществляется через команды curl.
Получение результатов сегментации: отправка PDF-файла через команды curl для получения результатов сегментации.
Остановка сервиса: предоставляются команды для остановки сервера.
Зависимости и требования
Docker Desktop: требуется установленный Docker Desktop версии 4.25.0 или выше.
Поддержка GPU: при необходимости ускорения на GPU требуется установка соответствующего программного обеспечения поддержки GPU.
Требования к оборудованию: требуется не менее 2 ГБ оперативной памяти; при использовании GPU — 5 ГБ видеопамяти.
Модели
Визуальная модель (Vision Grid Transformer — VGT): модель по умолчанию, обученная исследовательской группой Alibaba, поддерживает более сложный анализ макета, но требует больше ресурсов.
Модель LightGBM: не визуальная модель, использующая XML-информацию, извлечённую Poppler, для классификации и сегментации; работает быстрее и потребляет меньше ресурсов.
Данные
Обучающие данные: используется набор данных DocLayNet, содержащий 11 категорий, таких как заголовки, сноски, формулы, элементы списков и т. д.
Как пользоваться
Базовая команда: отправка PDF-файла через команды curl с выбором визуальной или не визуальной модели.
Визуализация результатов: поддерживается визуализация результатов анализа в виде PDF-файла.
Извлечение таблиц и формул: поддерживается извлечение таблиц и формул в различных форматах (таких как LaTeX, Markdown).
Порядок вывода
Правила сортировки: сортировка выполняется на основе исходного порядка чтения Poppler и типов абзацев, что обеспечивает логичный порядок вывода.
Производительность и скорость
Производительность: модель VGT показывает отличные результаты на наборе данных PubLayNet, средняя точность превышает 96%.
Скорость: не визуальная модель обрабатывает одну страницу на CPU за 0,42 секунды; визуальная модель — за 1,75 секунды на GPU и за 13,5 секунды на CPU.
Полезные ссылки
GitHub:https://github.com/huridocs/pdf-document-layout-analysis
DockerHub:https://hub.docker.com/r/huridocs/pdf-document-layout-analysis









