
 Помощник сценариста▸
 AI Приложения
 AI Новости
UNO: модель генерации изображений с множеством субъектов по условию от ByteDance
小编 ·

UNO: модель генерации изображений с множеством субъектов по условию от ByteDance
Что такое UNO?
UNO — это модель генерации изображений по условию нескольких объектов, разработанная исследовательской командой ByteDance. Используя возможности контекстной генерации диффузионного трансформера, она создаёт высококонсистентные парные данные с несколькими объектами.
Основные особенности UNO
Генерация по условию нескольких изображений: поддерживает генерацию изображений с одним или несколькими объектами на основе одной или нескольких референсных картинок.
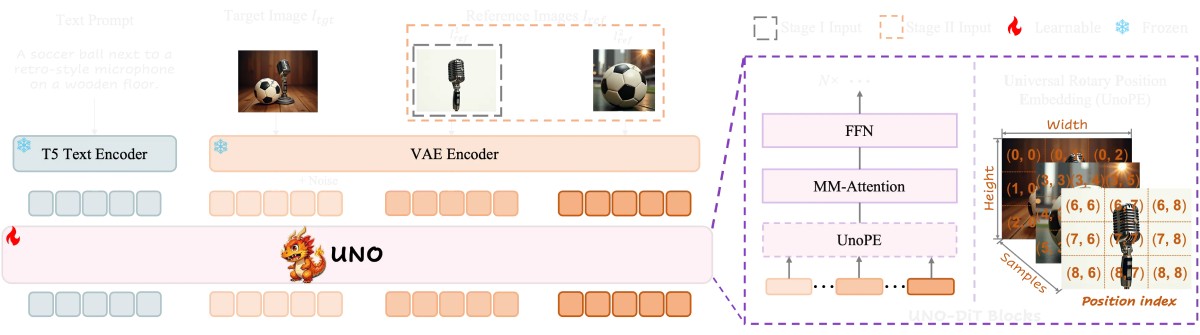
Прогрессивное кросс-модальное выравнивание: повышение консистентности генерации за счёт пошагового выравнивания различных модальностей (например, текста и изображений). Процесс состоит из двух этапов. На первом этапе предобученная модель «текст-в-изображение» дообучается на данных контекстной генерации с одним объектом, превращаясь в модель «объект-в-изображение»; на втором этапе обучение продолжается на сгенерированных парах данных с несколькими объектами.
Универсальные вращающиеся позиционные эмбеддинги: поддерживают генерацию изображений с различными разрешениями и соотношениями сторон, эффективно смягчая проблему перепутывания атрибутов при расширении визуального контроля объектов.
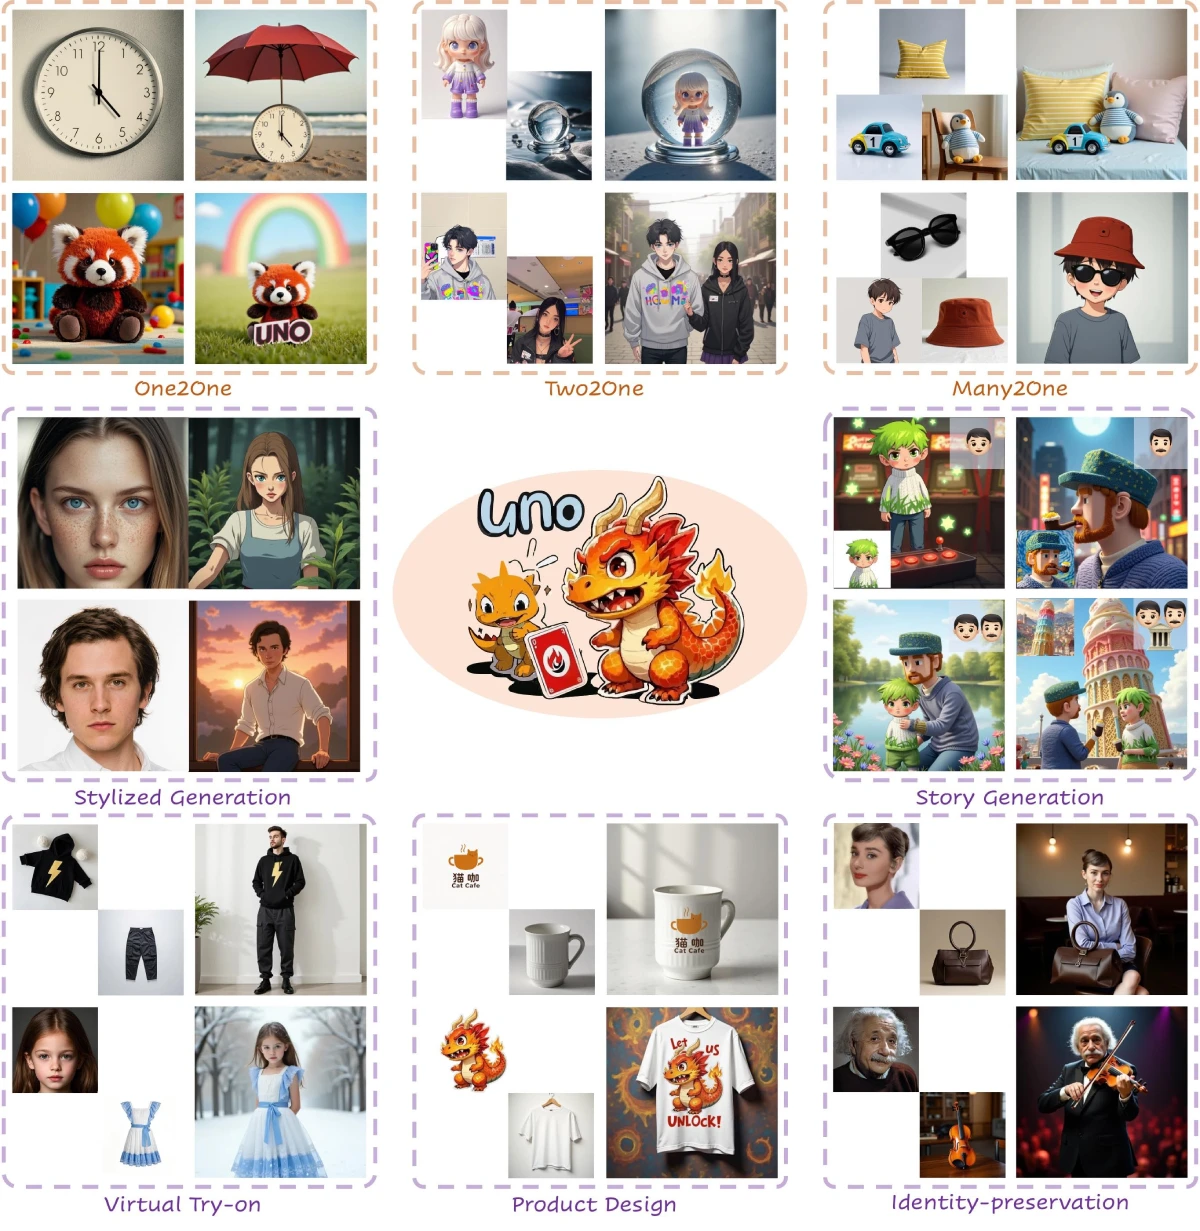
Ключевые механизмы UNO:
Прогрессивное кросс-модальное выравнивание (Progressive Cross-Modal Alignment): состоит из двух этапов. На первом этапе предобученная модель «текст-в-изображение» дообучается на данных контекстной генерации с одним объектом, превращаясь в модель «объект-в-изображение»; на втором этапе обучение продолжается на сгенерированных парах данных с несколькими объектами.
Универсальные вращающиеся позиционные эмбеддинги (Universal Rotary Position Embedding, UnoPE): эффективно смягчают проблему перепутывания атрибутов при расширении визуального контроля объектов и поддерживают генерацию изображений с различными разрешениями и соотношениями сторон.
Принцип работы UNO
UNO использует возможности контекстной генерации диффузионного трансформера для создания высококонсистентных парных данных с несколькими объектами. Модель итеративно обучается на основе модели «текст-в-изображение», и благодаря уникальным механизмам прогрессивного кросс-модального выравнивания и универсальных вращающихся позиционных эмбеддингов обеспечивает высокую консистентность и управляемость как при генерации с одним объектом, так и при генерации с несколькими объектами.
Сценарии применения UNO
Генерация с одним объектом: создание изображения на основе одного референса — например, по фотографии часов можно сгенерировать часы на пляже.
Генерация с несколькими объектами: создание изображения на основе нескольких референсов — например, используя изображения куклы и хрустального шара в качестве референсов, можно сгенерировать куклу внутри хрустального шара.
Контекстная генерация: создание высококонсистентных изображений с помощью контекстных подсказок. Например, по подсказке «часы на пляже под красным солнечным зонтом» в сочетании с референсным изображением часов генерируется картинка, соответствующая описанию.
Как использовать UNO
Настройка окружения:
Создайте виртуальное окружение и установите зависимости:
python -m venv uno_env
source uno_env/bin/activate
pip install -r requirements.txt
Загрузите веса модели: автоматическая загрузка (код загрузит их сам при запуске скрипта инференса) либо вручную через huggingface-cli в указанную директорию.
Пример инференса: выполните следующую команду для генерации изображения:
python inference.py --prompt "A clock on the beach is under a red sun umbrella" --image_paths "assets/clock.png" --width 704 --height 704
Обучение: запустите скрипт обучения:
accelerate launch train.py
Полезные ссылки
Страница проекта: https://bytedance.github.io/UNO
Репозиторий на GitHub: https://github.com/bytedance/UNO
Статья на arXiv: https://arxiv.org/abs/2504.02160
Демонстрация: https://huggingface.co/spaces/bytedance-research/UNO-FLUX









