
 Помощник сценариста▸
 AI Приложения
 AI Новости
Cloudflare представила AutoRAG: полностью управляемый конвейер RAG
小编 ·

Cloudflare представила AutoRAG: полностью управляемый конвейер RAG
Что такое AutoRAG
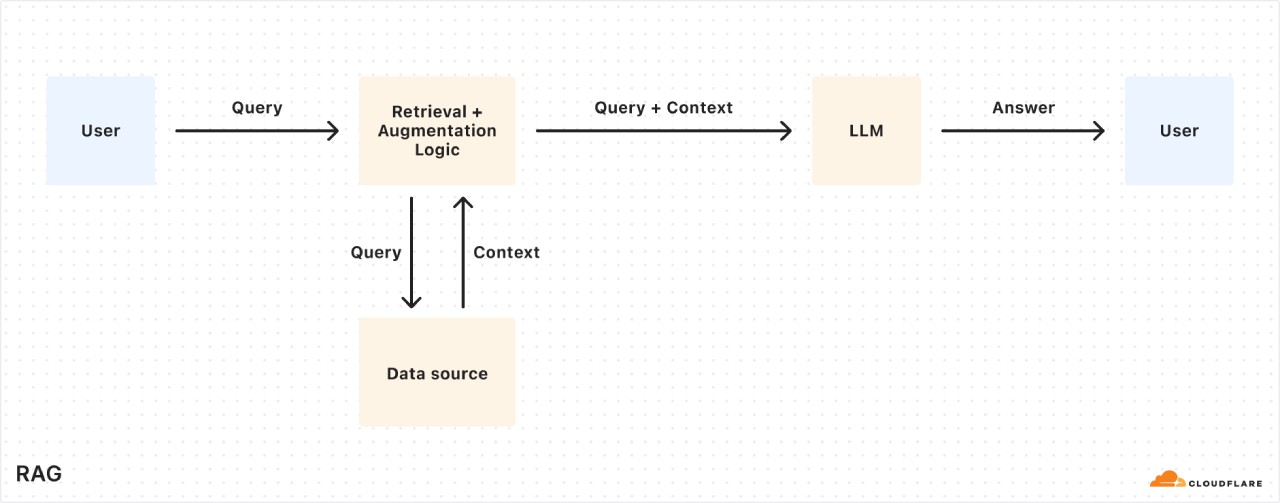
AutoRAG — это полностью управляемый конвейер RAG, работающий на базе Cloudflare. RAG — это метод, при котором информация извлекается из собственных данных пользователя и предоставляется большой языковой модели (LLM) для генерации более точных и релевантных ответов.
Болевые точки традиционных конвейеров RAG
Создание конвейера RAG требует объединения множества инструментов и сервисов, таких как хранилища данных, векторные базы данных, модели эмбеддингов, LLM и т. д., и по мере изменения данных необходимо вручную переиндексировать и перегенерировать эмбеддинги для поддержания релевантности и производительности системы. Появление AutoRAG призвано устранить эту сложность, предоставляя всего за несколько кликов полностью управляемый сквозной конвейер RAG — от приёма данных, автоматического разбиения на фрагменты и создания эмбеддингов до хранения векторов в базе данных Vectorize от Cloudflare, выполнения семантического поиска и генерации высококачественных ответов с помощью Workers ai. AutoRAG также будет непрерывно отслеживать источники данных и индексировать их в фоновом режиме, поддерживая актуальность ИИ без каких-либо ручных усилий.
Причины использовать RAG
Ограничения LLM : Хотя LLM, такие как Llama 3.3 от Meta, мощны, их знания ограничены данными, на которых они были обучены, и им часто трудно давать точные ответы на новую, собственную или специфическую для предметной области информацию. Предоставление релевантной системной подсказки помогает, но увеличивает размер ввода и ограничено размером контекстного окна. Дообучение модели обходится дорого и требует постоянного переобучения для поддержания актуальности.
Преимущества RAG : RAG может извлекать релевантную информацию из источников данных во время запроса, объединять её с входным запросом пользователя, а затем передавать всё вместе в LLM для генерации ответа на основе данных пользователя. Это делает RAG идеально подходящим для таких сценариев использования, как ИИ-поддержка ботов, внутренних помощников на основе знаний, семантического поиска по документам и т. д., где реальные источники информации постоянно меняются.
Как работает AutoRAG
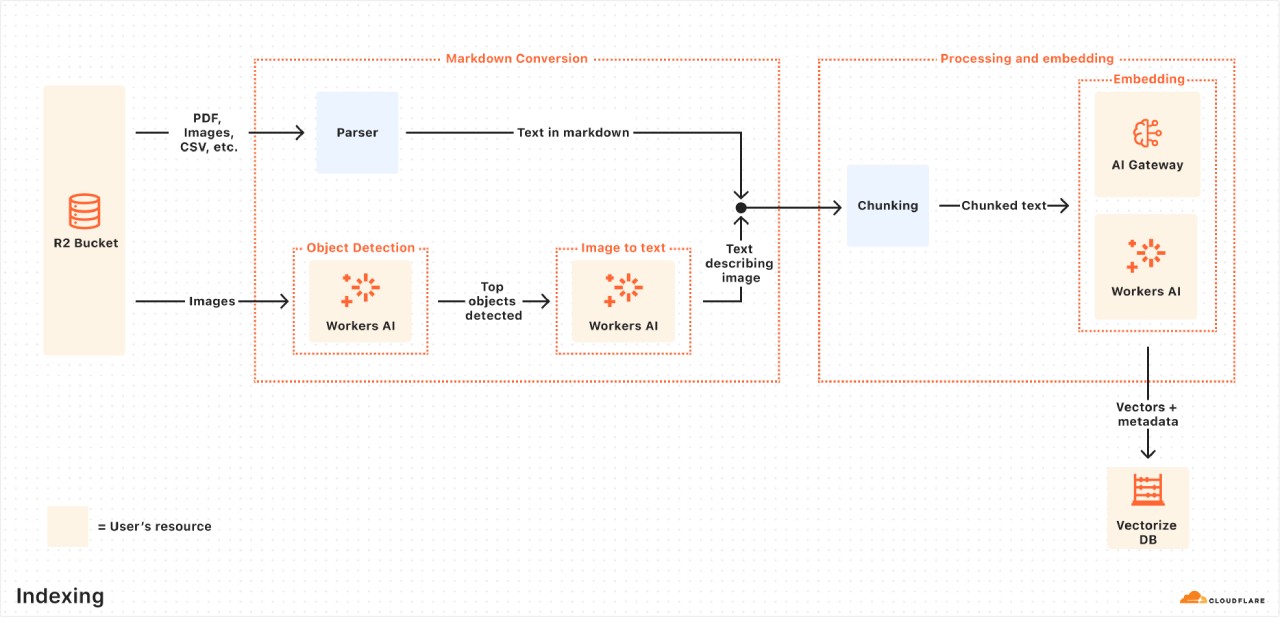
Процесс индексирования : Это асинхронный процесс, выполняемый в фоновом режиме. Он запускается автоматически с момента создания AutoRAG и циклически повторно обрабатывает новые или обновлённые файлы после завершения каждой предыдущей задачи. В процессе индексирования содержимое преобразуется в векторы, оптимизированные для семантического поиска.
Приём файлов : AutoRAG считывает файлы напрямую из источников данных. В настоящее время поддерживается интеграция с Cloudflare R2, где в R2 могут храниться документы различных форматов, таких как PDF, изображения, текст, HTML, CSV и т. д., для последующей обработки.
Преобразование в Markdown : Используется функция преобразования в Markdown от Workers AI для преобразования всех файлов в структурированный формат Markdown, что обеспечивает единообразие между разными типами файлов. Для изображений с помощью Workers AI выполняется обнаружение объектов, а затем преобразование визуального контента в текст, чтобы преобразовать изображения в текст Markdown.
Разбиение на фрагменты : Извлечённый текст разбивается на более мелкие фрагменты для повышения гранулярности извлечения.
Эмбеддинг : Каждый фрагмент преобразуется в эмбеддинг с помощью модели эмбеддингов Workers AI, превращая содержимое в вектор.
Хранение векторов : Полученные векторы вместе с метаданными (такими как исходное расположение и имя файла) хранятся в базе данных Vectorize от Cloudflare, которая создаётся в вашем аккаунте.
Процесс запроса : Это синхронный процесс, который запускается при отправке пользователем поискового запроса.
Получение запроса от API AutoRAG : Рабочий процесс запроса начинается, когда вы отправляете запрос к конечной точке AI Search или Search AutoRAG.
Переформулировка запроса (опционально) : AutoRAG предоставляет возможность переформулировать входной запрос с помощью одной из LLM Workers AI, преобразуя исходный запрос в более эффективный поисковый запрос для повышения качества извлечения.
Эмбеддинг запроса : Переформулированный (или исходный) запрос преобразуется в вектор с помощью той же модели эмбеддингов, которая использовалась для эмбеддинга данных, чтобы можно было сравнить его с уже векторизованными данными и найти наиболее релевантные совпадения.
Векторный поиск в Vectorize : Вектор запроса сравнивается с векторами, хранящимися в базе данных Vectorize, связанной с AutoRAG.
Извлечение метаданных и содержимого : Vectorize возвращает наиболее релевантные фрагменты вместе с их метаданными, а исходное содержимое извлекается из бакета R2. Это содержимое передаётся модели генерации текста.
Генерация ответа : С помощью модели генерации текста Workers AI генерируется ответ на основе извлечённого содержимого и исходного запроса пользователя.
Руководство по использованию AutoRAG
Использование Browser Rendering API : Если содержимое находится не в бакете R2, а по-прежнему на веб-странице или требует динамического отображения через интерфейс, можно использовать Browser Rendering API для сканирования собственного веб-сайта и получения контента для RAG. Browser Rendering REST API теперь полностью доступен и предоставляет эндпоинты для распространённых операций браузера, включая извлечение HTML-содержимого, создание скриншотов и генерацию PDF. Кроме того, в скором времени появится эндпоинт для сканирования, что сделает получение содержимого веб-сайта ещё удобнее.
Шаг 1: Создание Worker для сканирования веб-страниц и загрузки в R2
Создайте новый проект Worker с именем browser-r2-worker и выберите соответствующие параметры для настройки.
Установите @cloudflare/puppeteer для управления экземпляром браузерного рендеринга.
Создайте новый бакет R2 с именем html-bucket.
Добавьте соответствующие конфигурации в файл конфигурации Wrangler, чтобы Worker мог использовать браузерный рендеринг и новый бакет R2.
Замените содержимое в src/index.ts, написав код скрипта для сканирования веб-страниц и сохранения их в бакет R2.
Разверните Worker в аккаунте Cloudflare.
Протестируйте Worker с помощью запроса cURL, чтобы HTML-файл веб-страницы был загружен в бакет html-bucket.
Шаг 2: Создание AutoRAG и мониторинг индексирования
В панели управления Cloudflare перейдите в раздел AI > AutoRAG.
Выберите создание AutoRAG и завершите процесс настройки, включая выбор бакета R2, содержащего базу знаний, модели эмбеддингов, LLM, AI Gateway, присвоение имени AutoRAG, а также выбор или создание сервисного API-токена.
После создания AutoRAG автоматически создаст базу данных Vectorize в вашем аккаунте и начнёт индексировать данные. Вы можете отслеживать ход выполнения задач индексирования на странице обзора AutoRAG.
Шаг 3: Тестирование и добавление в приложение
После завершения индексирования можно начинать задавать вопросы AutoRAG. Можно задавать вопросы на вкладке Playground экземпляра AutoRAG, например: «Что такое AutoRAG?».
Если результаты в Playground вас устраивают, можно интегрировать AutoRAG напрямую в разрабатываемое приложение. Если приложение создаётся с помощью Worker, AutoRAG можно вызвать напрямую через привязку AI.
На этапе открытого бета-тестирования AutoRAG бесплатен. Вычислительные операции индексирования, извлечения и дополнения на этом этапе не тарифицируются дополнительно.
Официальное подробное описание:https://blog.cloudflare.com/introducing-autorag-on-cloudflare/









