
 Помощник сценариста▸
 AI Приложения
 AI Новости
Crawl4AI: краулер и скрапер с открытым исходным кодом, дружественный к ИИ
小编 ·

Crawl4AI: краулер и скрапер с открытым исходным кодом, дружественный к ИИ
Что такое Crawl4ai?
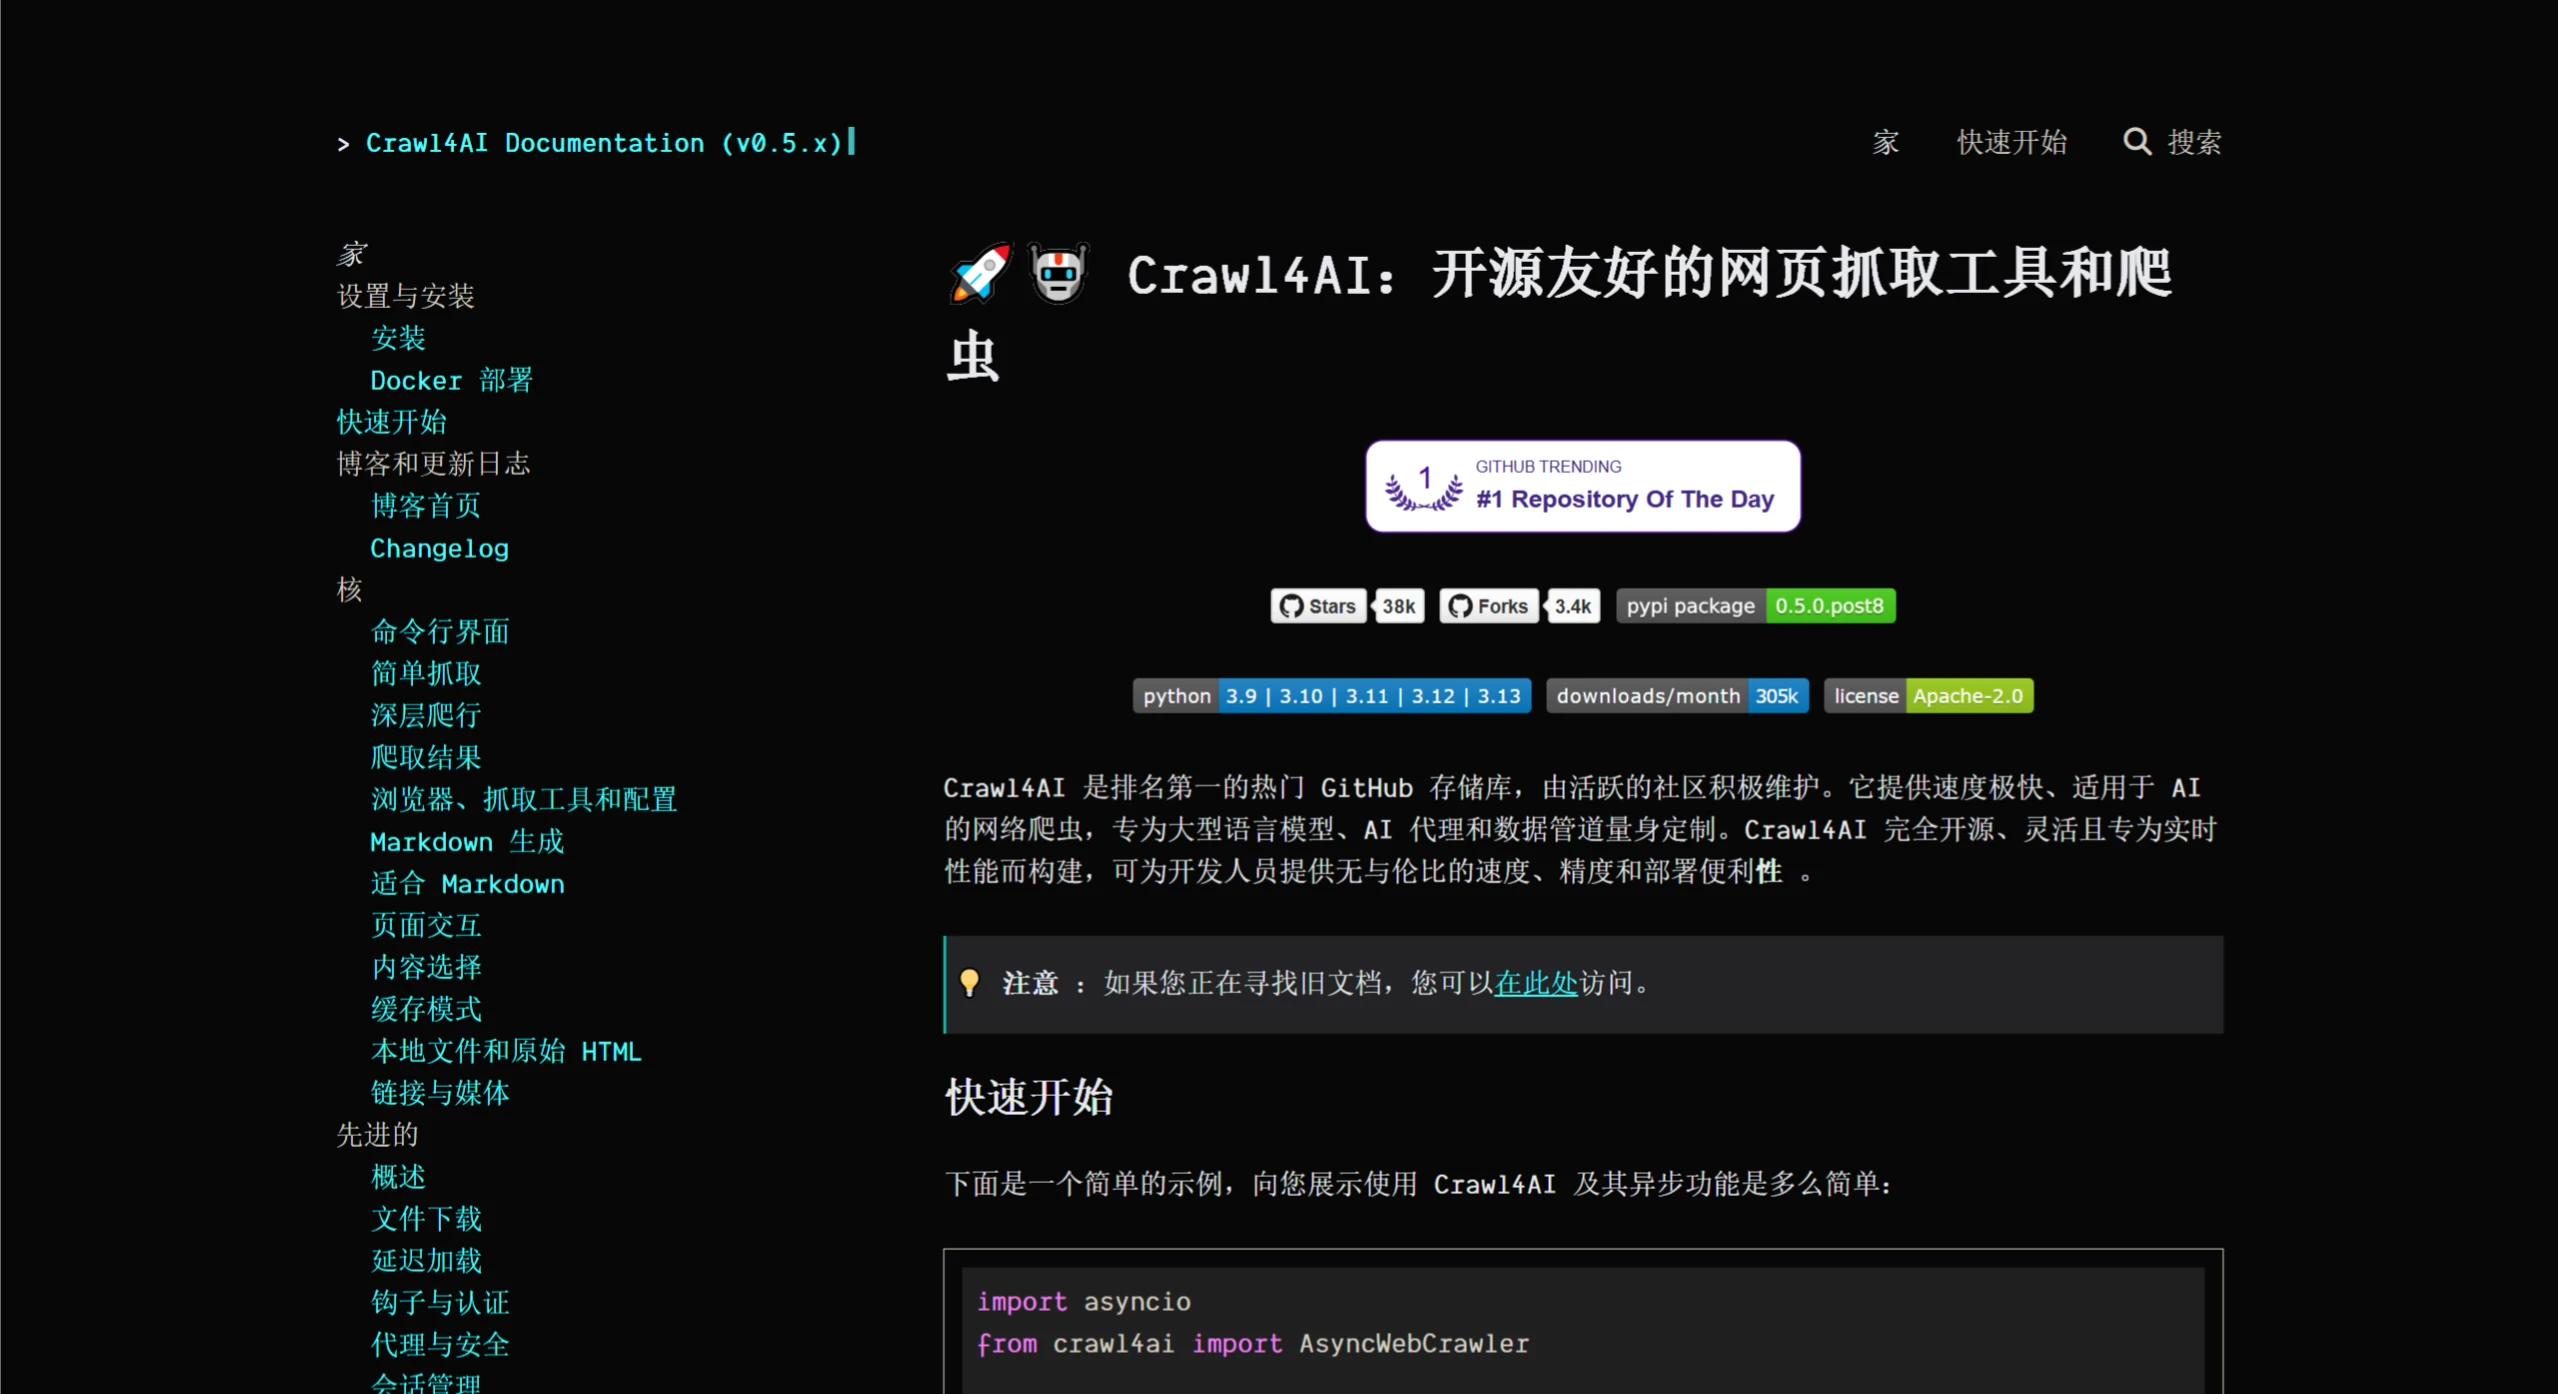
Crawl4AI — это открытый веб-краулер и скрапер, дружественный к ИИ, популярный проект на GitHub, разработанный специально для LLM, ИИ-агентов и конвейеров данных. Он поддерживает быстрое и гибкое извлечение веб-данных, генерирует данные в формате Markdown, подходящем для LLM, и обладает такими возможностями, как структурированное извлечение данных, интеграция с браузером и обработка динамического контента.
Функции Crawl4AI
Генерация Markdown
Чистый Markdown: генерирует структурированный и точно отформатированный текст Markdown.
Адаптированный Markdown: на основе эвристических алгоритмов отфильтровывает шум и нерелевантный контент, создавая Markdown, подходящий для обработки ИИ.
Цитаты и ссылки: преобразует ссылки страниц в нумерованный список ссылок и предоставляет чёткие цитаты.
Пользовательские стратегии: пользователи могут создавать собственные стратегии генерации Markdown для удовлетворения конкретных потребностей.
Алгоритм BM25: фильтрует контент на основе алгоритма BM25, извлекая ключевую информацию и удаляя нерелевантное.
Структурированное извлечение данных
Извлечение на основе LLM: поддерживает все LLM (как открытые, так и проприетарные) для структурированного извлечения данных.
Стратегии разбиения на фрагменты: реализует разбиение на фрагменты по темам, регулярным выражениям и на уровне предложений.
Косинусное сходство: находит релевантные блоки контента на основе пользовательских запросов, обеспечивая семантическое извлечение.
Извлечение на основе CSS: использует XPath и CSS-селекторы для быстрого шаблонного извлечения данных.
Определение схем: определяет пользовательские схемы для извлечения структурированных данных JSON из повторяющихся шаблонов.
Интеграция с браузером
Собственный браузер: использует собственный браузер пользователя, чтобы избежать обнаружения в качестве краулера.
Удалённое управление браузером: подключается к удалённым браузерам через протокол Chrome DevTools для массового извлечения данных.
Профили браузера: создание и управление постоянными профилями для сохранения состояния аутентификации, файлов cookie и настроек.
Управление сеансами: сохранение и повторное использование состояния браузера для поддержки многоэтапного сканирования.
Поддержка прокси: бесшовное подключение к прокси с аутентификацией для обеспечения безопасного доступа.
Полный контроль над браузером: изменение заголовков запросов, файлов cookie, пользовательских агентов и т. д. для настройки параметров сканирования.
Поддержка нескольких браузеров: совместимость с Chromium, Firefox и WebKit.
Динамическая настройка области просмотра: автоматическая настройка области просмотра браузера в соответствии с содержимым страницы для обеспечения полного рендеринга и захвата всех элементов.
Сканирование и сбор данных
Поддержка медиа: извлечение изображений, аудио, видео и адаптивных форматов изображений (таких как srcset и picture).
Динамическое сканирование: выполнение JavaScript и ожидание асинхронного или синхронного контента для извлечения динамического содержимого.
Скриншоты: захват скриншотов страниц в процессе сканирования для отладки или анализа.
Сканирование необработанных данных: прямая обработка необработанного HTML (raw:) или локальных файлов (file://).
Полное извлечение ссылок: извлечение внутренних, внешних ссылок и встроенного содержимого iframe.
Пользовательские хуки: определение хуков на каждом этапе для настройки поведения сканирования.
Кэширование: кэширование данных для повышения скорости и предотвращения повторного сбора.
Извлечение метаданных: извлечение структурированных метаданных с веб-страниц.
Извлечение содержимого iframe: бесшовное извлечение встроенного содержимого iframe.
Обработка отложенной загрузки: ожидание полной загрузки изображений, чтобы не пропустить контент из-за ленивой загрузки.
Полное сканирование страницы: имитация прокрутки для загрузки и захвата всего динамического контента, подходит для страниц с бесконечной прокруткой.
Другие функции
Режим скрытности: имитация поведения реальных пользователей, чтобы избежать обнаружения в качестве краулера.
Извлечение контента на основе тегов: уточнение сканируемого контента в соответствии с пользовательскими тегами, заголовками или метаданными.
Анализ ссылок: извлечение и анализ всех ссылок для детального исследования данных.
Обработка ошибок: мощное управление ошибками для обеспечения бесперебойного выполнения.
CORS и статический сервинг: поддержка кэширования на основе файловой системы и кросс-доменных запросов.
Понятная документация: упрощённые руководства по началу работы и расширенному использованию.
Преимущества Crawl4AI
Создан для LLM: генерирует умный и краткий Markdown, подходящий для приложений RAG и дообучения.
Высочайшая производительность: производительность в реальном времени с экономией затрат, в 6 раз быстрее, чем традиционные методы.
Гибкое управление браузером: обеспечивает управление сеансами, поддержку прокси и пользовательские хуки для бесшовного доступа к данным.
Эвристический интеллект: использует передовые алгоритмы для эффективного извлечения контента, снижая зависимость от дорогостоящих моделей.
Открытый исходный код и возможность развёртывания: полностью открытый исходный код, не требует API-ключей, поддерживает Docker и облачную интеграцию.
Сценарии применения Crawl4AI
ИИ и машинное обучение: предоставление высококачественных обучающих данных для LLM, поддержка обработки естественного языка и построения графов знаний.
Конвейеры данных: построение эффективных конвейеров данных для извлечения и обработки веб-данных в реальном времени.
Извлечение контента: извлечение текста, изображений, видео и другого мультимедийного контента с веб-страниц для систем управления контентом.
Академические исследования: помощь исследователям в извлечении научных работ и данных исследований с веб-страниц для поддержки научной работы.
Бизнес-аналитика: извлечение рыночных данных, информации о продуктах и отзывов пользователей для поддержки принятия бизнес-решений.
Новостные СМИ: быстрый сбор новостного контента для поддержки агрегации новостей и анализа контента.
Руководство по установке и использованию Crawl4AI
Установка
Базовая установка:
pip install crawl4ai
crawl4ai-setup  # Настройка браузера
Установка предрелизной версии:
pip install crawl4ai --pre
Установка для разработки:
git clone https://github.com/unclecode/crawl4ai.git
cd crawl4ai
pip install -e .  # Базовая установка
pip install -e ".[all]"  # Установка всех дополнительных функций
Адрес на Github:https://github.com/unclecode/crawl4ai
Документация Crawl4AI:https://docs.crawl4ai.com/
Discord:https://discord.com/invite/jP8KfhDhyN









