
 Помощник сценариста▸
 AI Приложения
 AI Новости
Versatile-OCR-Program: OCR для извлечения структурированных данных из сложных материалов, таких как экзаменационные работы
小编 ·

Versatile-OCR-Program: OCR для извлечения структурированных данных из сложных материалов, таких как экзаменационные работы
Что такое Versatile-OCR-Program?
Versatile-OCR-Program — это система OCR, оптимизированная специально для обучения моделей машинного обучения. Она способна извлекать структурированные данные из сложных учебных материалов (например, экзаменационных работ) и выводить их в формате JSON или Markdown. Поддерживает японский, корейский и английский языки, может работать с другими языками, математическими формулами, таблицами, диаграммами и графиками, а также выполнять семантическое аннотирование, генерируя описания на естественном языке.
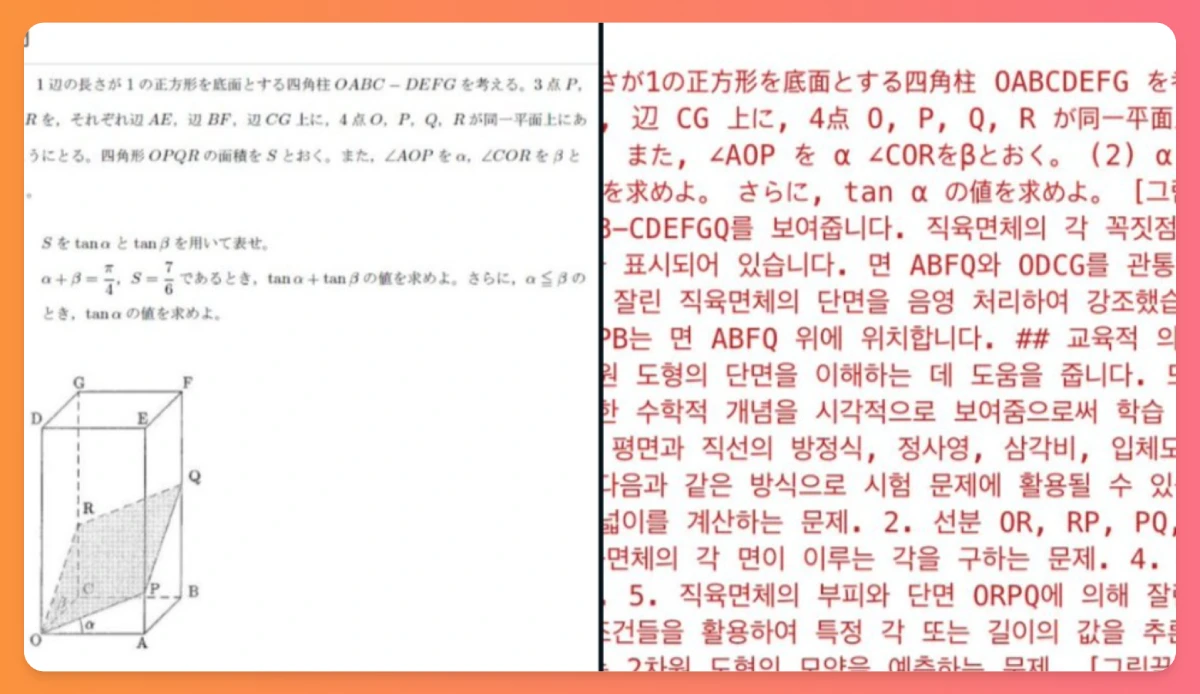
Основные особенности Versatile-OCR-Program
Оптимизация для обучения машинного обучения: извлечённые элементы (такие как графики, таблицы и диаграммы) проходят семантическое аннотирование, включая автоматическую генерацию описаний визуального контента на естественном языке, для улучшения обучения downstream-моделей.
Многоязычная поддержка: поддерживает японский, корейский и английский языки, а также легко настраивается для других языков.
Структурированный вывод: генерирует готовый для ai вывод в формате JSON или Markdown, включая удобочитаемые описания математических выражений, сводки таблиц и подписи к графикам.
Высокая точность: на реальных академических наборах данных, таких как биология EJU и математика Токийского университета, точность достигает 90% - 95%.
Поддержка сложной компоновки: способна точно обрабатывать PDF в стиле экзаменационных работ, содержащие плотный научный контент, абзацы с большим количеством формул и богатые визуальные элементы.
Техническая реализация: используются технологии DocLayout-YOLO, Google Vision API, Gemini Pro Vision, MathPix OCR, OpenAI API, OpenCV и другие.
Примеры вывода
Предоставлены реальные примеры вывода, включая входные изображения и преобразованные выходные изображения по математике и биологии, а также семантический контекст перевода на английский язык и извлечённые данные.
Пример по математике: демонстрирует, как из изображения, содержащего геометрические фигуры и углы, извлекается информация и генерируются соответствующие описания и задачи.
Пример по биологии: демонстрирует, как из изображения, показывающего процесс митоза в клетках кончика корня лука, извлекается информация и генерируются соответствующие описания и задачи.
Процесс использования Versatile-OCR-Program
Шаг 1: Первичное OCR-извлечение: запуск скрипта ocr_stage1.py для извлечения исходных элементов (текст, таблицы, графики и т.д.) из входного PDF, выполнения обнаружения компоновки и сохранения промежуточных результатов.
Шаг 2: Семантическая интерпретация и финальный вывод: запуск скрипта ocr_stage2.py для обработки промежуточных данных и преобразования их в структурированный, удобочитаемый вывод, включая генерацию объяснений на естественном языке, сводок и организации контента в готовом для AI формате (JSON/Markdown).
Техническая реализация
Оптимизация обработки таблиц: для обнаружения областей таблиц используется DocLayout-YOLO, для обработки таблиц — Google Vision OCR (лучше работает с японским текстом), а структура таблиц сохраняется в структурированном формате JSON.
Обработка изображений и специальных областей: для обработки областей изображений используются функции анализа изображений Google Vision API, для генерации описаний изображений — Google Cloud Vision API, для обработки диаграмм/графиков — функция анализа документов Google Cloud Vision API, а результаты обработки сохраняются в структурированном формате JSON.
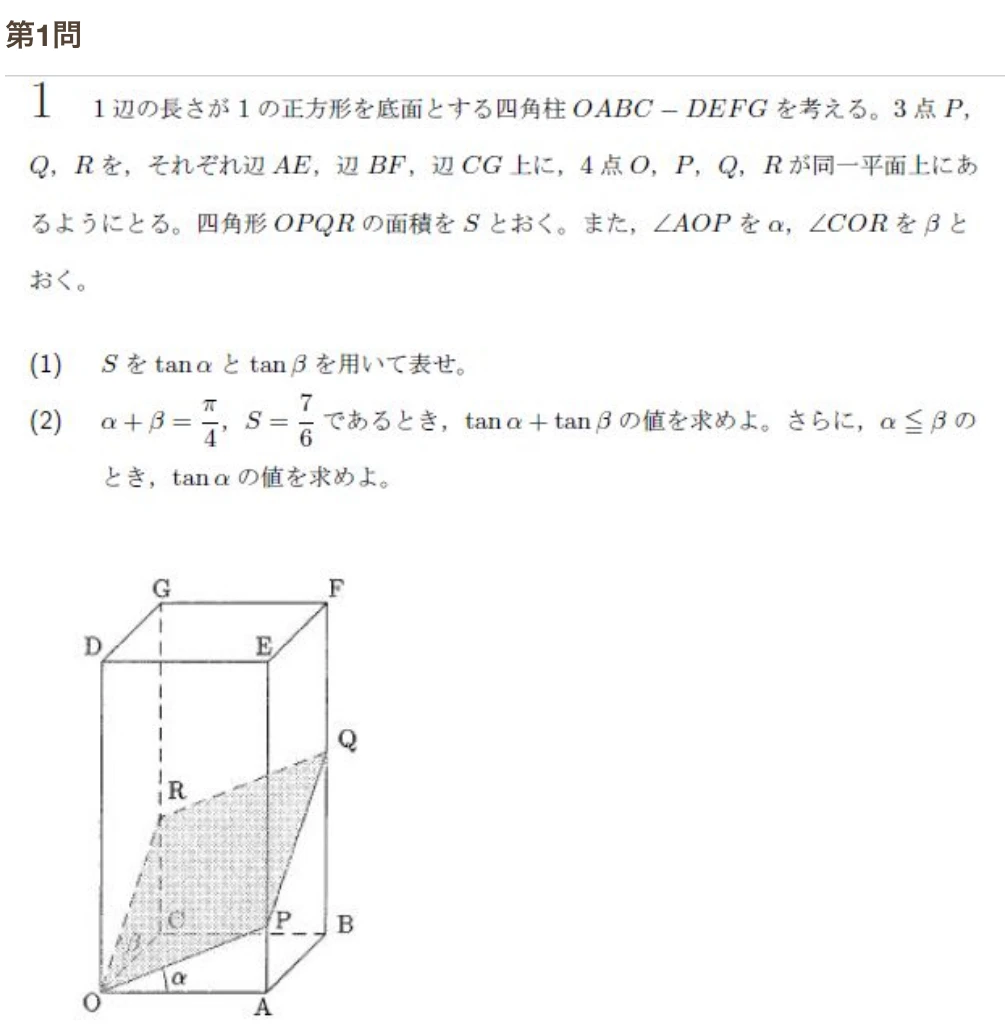
Эффект ввода
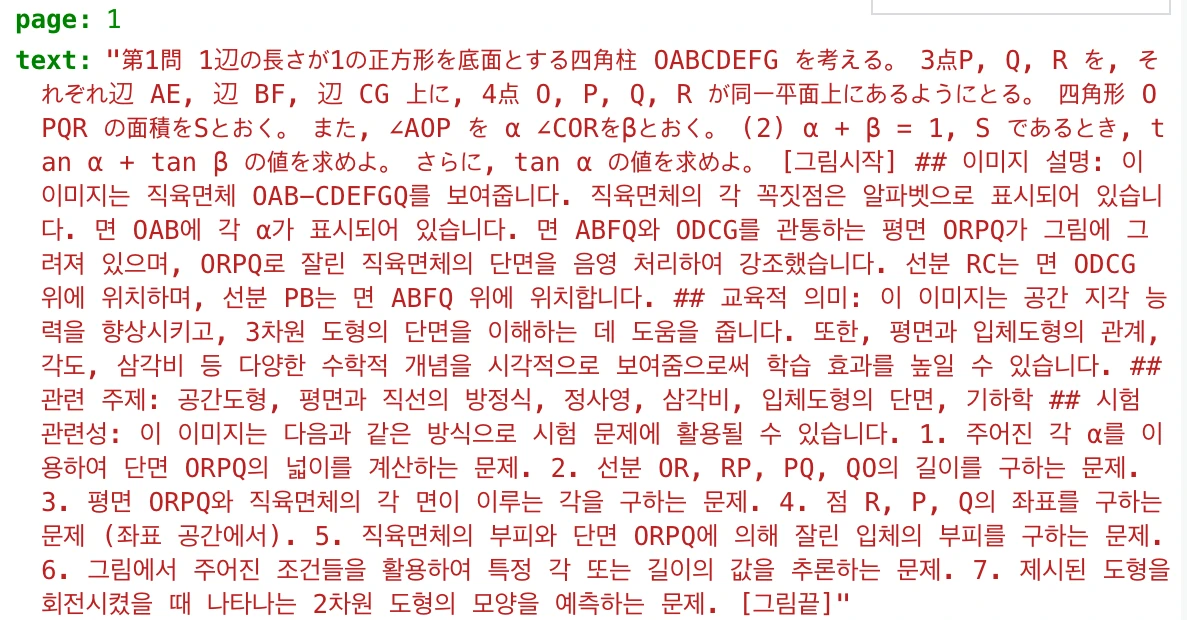
Эффект вывода
Применение Versatile-OCR-Program
Образовательная сфера: используется для извлечения и систематизации данных из экзаменационных работ, научных статей и других учебных материалов, обеспечивая поддержку образовательных исследований и обучения.
Обучение машинного обучения: генерация высококачественных обучающих наборов данных для обучения моделей машинного обучения, особенно в образовательной сфере.
Обработка многоязычных документов: подходит для сценариев, требующих обработки документов на нескольких языках, таких как международный академический обмен, оцифровка многоязычных учебных материалов и т.д.
Проект на GitHub:https://github.com/ses4255/Versatile-OCR-Program









