
 Помощник сценариста▸
 AI Приложения
 AI Новости
Dolphin: модель автоматического распознавания речи для восточных языков от Datatang и Цинхуа
小编 ·

Dolphin: модель автоматического распознавания речи для восточных языков от Datatang и Цинхуа
Что такое Dolphin?
Dolphin — это модель автоматического распознавания речи, специально разработанная для восточных языков, созданная совместно компанией DataoceanAI и Лабораторией технологий речи и аудио кафедры электронной инженерии Университета Цинхуа.Dolphin поддерживает 40 восточных языков и 22 китайских диалекта. Модель отличается высокой точностью и устойчивостью, способна адаптироваться к различным сложным условиям речи. Dolphin широко применяется в таких сценариях, как преобразование речи в текст, голосовое взаимодействие и анализ голосового контента, поддерживает установку в один клик и различные способы вызова.
Особенности модели Dolphin
Многоязычная поддержка: Dolphin поддерживает 40 восточных языков, включая языки Восточной, Южной, Юго-Восточной Азии и Ближнего Востока, а также 22 китайских диалекта (включая путунхуа).
Языковая адаптация: автоматически определяет язык входной речи без необходимости ручного указания.
Высокая точность: на нескольких тестовых наборах частота ошибок на уровне слов (WER) значительно ниже, чем у аналогичных моделей.
Высокая устойчивость: адаптируется к различным акцентам, темпу речи, фоновому шуму и другим сложным условиям речи.
Высокая производительность: на трёх тестовых наборах — DataoceanAI, Fleurs и CommonVoice — по сравнению с моделями Whisper аналогичного размера WER в Dolphin значительно снижен. Например, у версии base средний WER снижен на 63,1%, а у версии small — на 68,2%.
Открытый исходный код: модели Dolphin версий base и small, а также код для инференса полностью открыты.
Техническая архитектура Dolphin
Сетевая структура: основана на архитектуре CTC-Attention, использует кодировщик E-Branchformer и декодировщик Transformer, а также включает слой с понижением частоты дискретизации в 4 раза. Такая структура сочетает возможности последовательного моделирования CTC и механизма внимания для захвата контекста, что позволяет эффективно повысить точность и эффективность распознавания.
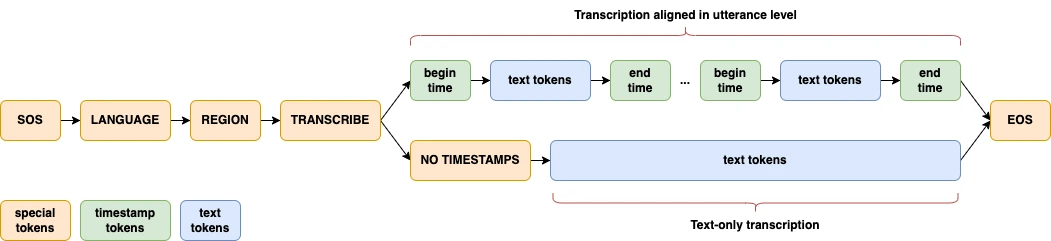
Многозадачный формат: Dolphin заимствовал методы проектирования у Whisper и OWSM, сосредоточившись на ASR и внеся несколько ключевых изменений, таких как удаление previous text и связанных с ним меток, что упростило формат ввода. Кроме того, Dolphin ввёл двухуровневую систему языковых меток для лучшей обработки разнообразия языков и регионов.
Основа данных
Обучающий набор данных Dolphin объединяет собственные данные DataoceanAI и несколько наборов данных с открытым исходным кодом, общий объём превышает 212 000 часов. Из них набор данных DataoceanAI содержит 137 712 часов аудио и охватывает 38 восточных языков.
Сценарии применения
Преобразование речи в текст: подходит для протоколирования совещаний, голосового ввода и других сценариев.
Голосовое взаимодействие: используется в AI-голосовых ассистентах, системах умного дома и других приложениях для улучшения пользовательского опыта.
Анализ голосового контента: быстрая транскрипция и анализ голосового медиаконтента.
Руководство по использованию Dolphin
Установка: пользователи могут установить модель в один клик с помощью команды pip install -U dataoceanai-dolphin.
Вызов из командной строки: например, используйте dolphin audio.wav для распознавания речи, также можно указать версию модели, метку языка и региона.
Вызов из Python: импортировав модуль dolphin , загрузив аудио и модель, можно выполнять распознавание речи.
Ссылки по теме
Адрес на Github: https://github.com/DataoceanAI/Dolphin
Домашняя страница проекта: https://huggingface.co/DataoceanAI









