
 Помощник сценариста▸
 AI Приложения
 AI Новости
SegAnyMo: автоматическое распознавание и точная сегментация движущихся объектов в видео
小编 ·

SegAnyMo: автоматическое распознавание и точная сегментация движущихся объектов в видео
Что такое SegAnyMo?
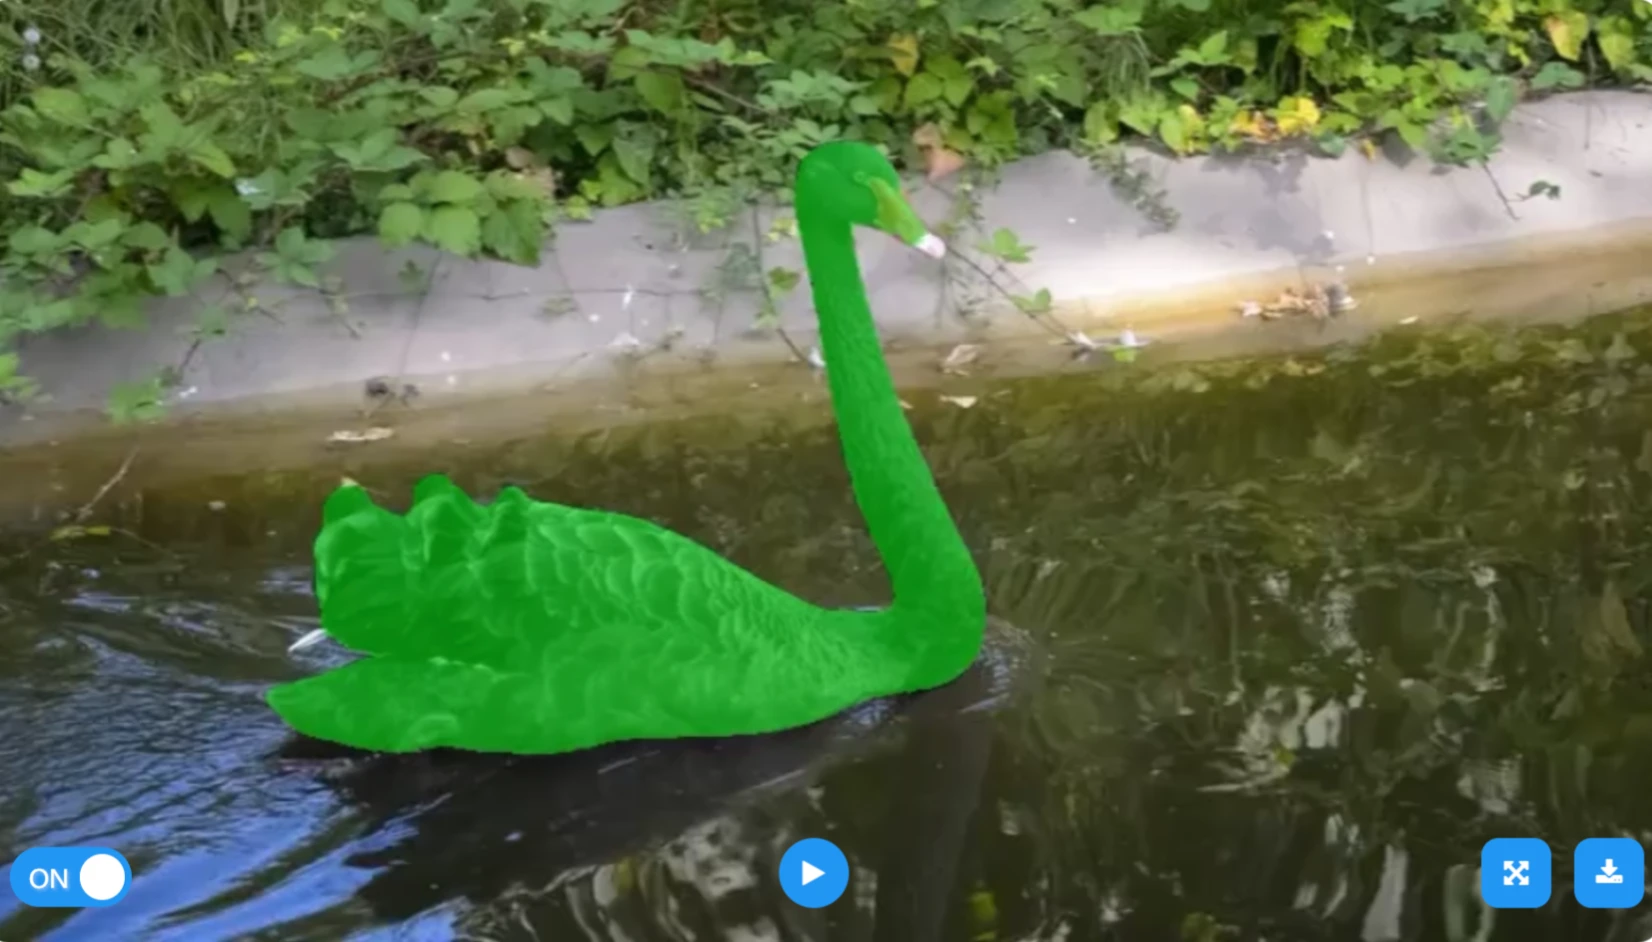
SegAnyMo (Segment Any Motion in Videos) — это интеллектуальный инструмент для «вырезания объектов из видео (ротоскопирования)». Он способен автоматически распознавать и точно сегментировать движущиеся объекты в видео. Разделение нескольких движущихся объектов в видео выполняется без ручной разметки, что позволяет справляться со сценами, где объекты движутся слишком быстро, изображение размыто или фон отличается высокой сложностью.
Предпосылки исследования
Сегментация движущихся объектов является ключевой задачей для высокоуровневого понимания визуальных сцен и имеет множество прикладных применений. Большинство предыдущих исследований опирались на оптический поток для получения информации о движении, однако такой подход часто приводит к неточным результатам при столкновении с такими трудностями, как частичное движение, сложные деформации, размытие движения и помехи фона.
Описание метода
В данном исследовании предложен новый метод сегментации движущихся объектов, объединяющий долгосрочные траекторные признаки движения с семантическими признаками на основе DINO и использующий SAM2 с итеративной стратегией подсказок для попиксельного уплотнения масок. Конкретный процесс выглядит следующим образом:
Обработка входных данных: на вход подаются 2D-траектории и карты глубины, сгенерированные готовыми моделями; с помощью кодировщика движения улавливаются модели движения и формируются траекторные признаки.
Декодирование траекторий: с использованием декодера траекторий, интегрирующего признаки DINO, выполняется декодирование траекторных признаков путём разделения информации о движении и семантической информации, в результате чего получаются динамические траектории.
Генерация масок: SAM2 группирует динамические траектории, принадлежащие одному и тому же объекту, и формирует точные маски движущихся объектов.
Функции SegAnyMo
Обнаружение и сегментация движущихся объектов: автоматическое обнаружение движущихся объектов в видео и создание соответствующих масок сегментации, точно обозначающих контуры и положение движущихся объектов.
Работа в сложных сценах: способность справляться со сложными условиями, такими как частичное движение, сложные деформации, размытие движения и помехи фона, сохраняя при этом точную сегментацию целевых объектов.
Сегментация нескольких объектов: одновременное обнаружение и сегментация нескольких движущихся целей в видео с созданием отдельной маски для каждого объекта, что упрощает их индивидуальную обработку и анализ.
Способность к обобщению: высокая обобщающая способность, позволяющая адаптироваться к различным наборам видеоданных и сценам, сохраняя высокую точность сегментации даже в незнакомых условиях.
Использование семантической информации: за счёт учёта семантической информации более точно сегментируются движущиеся объекты, что позволяет избежать ошибочного распознавания неподвижных объектов как движущихся.
Работа в реальном времени и эффективность: в определённой степени удовлетворяет требованиям обработки в реальном времени и может применяться в сценариях с высокими требованиями к скорости отклика.
Поддержка различных входных данных: поддержка 2D-траекторий, карт глубины и других типов входных данных с возможностью гибкой настройки стратегии сегментации в зависимости от условий.
Масштабируемость: архитектура обладает хорошей масштабируемостью и позволяет повышать производительность или адаптироваться к новым задачам путём добавления или модификации модулей.
Технические преимущества
Механизм внимания на основе пространственно-временных траекторий: благодаря этому механизму модель лучше фокусируется на информации о движении, одновременно используя семантическую поддержку, что обеспечивает точную сегментацию движущихся объектов даже в сложных сценах.
Разделение вложений движения и семантики: предотвращает ошибочные суждения, вызванные чрезмерной зависимостью модели от семантической информации, например, не относит неподвижное дорожное покрытие к динамическим объектам.
Мощная способность к обобщению: обширные испытания на множестве наборов данных показали, что модель демонстрирует превосходные результаты в сложных сценах и при детальной сегментации нескольких объектов.
Сценарии применения
Видеонаблюдение: обнаружение в реальном времени движущихся целей, таких как пешеходы и транспортные средства, сокращение ложных срабатываний и повышение точности систем безопасности.
Автономное вождение: распознавание динамических препятствий на дороге для помощи в принятии решений системой автопилота.
Анализ спортивных видео: сегментация движений спортсменов, поддержка анализа сложных действий и сцен с участием нескольких человек.
Интеллектуальная безопасность: исключение ложных срабатываний на неподвижные объекты, повышение надёжности системы.
Монтаж видео: классификация и обработка различных движущихся объектов для удобства добавления спецэффектов и замены объектов.
Мониторинг дорожного движения: анализ движения нескольких транспортных средств, поддержка управления транспортными потоками.
Робототехническое зрение: использование карт глубины для сегментации движущихся объектов, помощь в навигации и обходе препятствий роботами.
Многоучастниковые видеоконференции: сегментация изображений говорящих для повышения качества взаимодействия.
Академические исследования и разработка: открытый исходный код упрощает воспроизведение результатов и дальнейшую разработку, поддерживает обучение и тестирование на новых наборах данных.
Страница проекта:https://motion-seg.github.io/
Репозиторий на Github:https://github.com/nnanhuang/SegAnyMo









