
 Помощник сценариста▸
 AI Приложения
 AI Новости
MegaTTS 3: система синтеза речи с нулевым примером от ByteDance
小编 ·

MegaTTS 3: система синтеза речи с нулевым примером от ByteDance
Что такое MegaTTS 3?
MegaTTS 3 — это система синтеза речи из текста с нулевым количеством примеров, представленная ByteDance. Она использует легковесную диффузионную модель, которая разлагает речь на такие атрибуты, как содержание, тембр и просодия, и моделирует каждый из них. Система поддерживает клонирование голоса со сверхвысоким качеством, двуязычный синтез, управление интенсивностью акцента и другие функции, и может применяться для синтеза и редактирования речи.
Основная архитектура и технология
Легковесная и эффективная диффузионная модель: ядром MegaTTS 3 является TTS Diffusion Transformer с количеством параметров всего 0,45 млрд, что позволяет генерировать высококачественную речь при сохранении эффективности.
Разложение и моделирование речи: речь разлагается на различные атрибуты, такие как содержание, тембр и просодия, и для каждого атрибута разработан соответствующий модуль моделирования. Например, для моделирования тембра используются глобальные векторы, поскольку тембр является глобальным атрибутом, медленно меняющимся во времени; для генерации спектрограмм применяется акустическая модель на основе VQGAN, а для аппроксимации распределения просодии — языковая модель на основе латентных кодов, поскольку просодия быстро меняется в предложении, и языковая модель способна улавливать локальные и долгосрочные взаимосвязи.
Вокодер: используется вокодер на основе GAN для надлежащего построения фазы без необходимости моделирования фазы языковой моделью.
Функциональные особенности MegaTTS 3
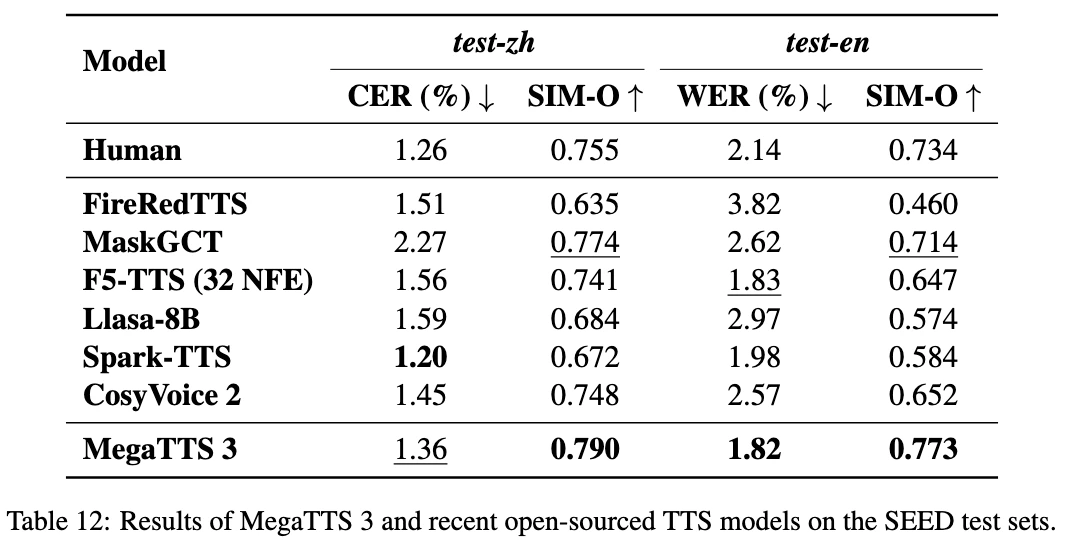
Клонирование голоса со сверхвысоким качеством: способна генерировать речь, очень похожую на голос целевого говорящего.
Двуязычная поддержка: поддерживает китайский и английский языки, а также синтез речи с смешением китайского и английского.
Управляемость: поддерживает управление интенсивностью акцента, а в будущем будет поддерживать более точную настройку произношения и длительности.
Синтез речи с нулевым количеством примеров: способна генерировать речь целевого говорящего без наличия специфических данных его голоса.
Сценарии применения MegaTTS 3
Синтез речи: может использоваться в различных сценариях, где требуется преобразование текста в речь, таких как аудиокниги, голосовые оповещения и т. д.
Редактирование речи: позволяет редактировать и изменять речь для удовлетворения различных потребностей.
Межъязыковой синтез речи: поддерживает задачи межъязыкового синтеза речи.
Руководство по использованию MegaTTS 3
Инструмент командной строки: предоставляется интерфейс командной строки, с помощью которого пользователи могут генерировать синтезированную речь, указывая входной файл голосовой подсказки и текстовое содержимое. Например:
Стандартная команда синтеза речи:
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav 'assets/Chinese_prompt.wav' --input_text "另一边的桌上,一位读书人嗤之以鼻道,'佛子三藏,神子燕小鱼是什么样的人物,李家的那个李子夜如何与他们相提并论?'" --output_dir ./gen
Команда синтеза речи с управлением акцентом:
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav 'assets/English_prompt.wav' --input_text '这是一条有口音的音频。' --output_dir ./gen --p_w 1.0 --t_w 3.0
Web UI: также поддерживает синтез речи через веб-интерфейс.
Установка MegaTTS 3
Требования к среде: требуется среда Python 3.9.
Загрузка модели: контрольные точки предобученной модели можно загрузить с Google Drive или Hugging Face и разместить в указанном каталоге.
Шаги установки:
# 创建 Python 3.9 的 conda 环境
conda create -n megatts3-env python=3.9
conda activate megatts3-env
# 安装依赖
pip install -r requirements.txt
Проект на GitHub: https://github.com/bytedance/MegaTTS3









