
 Помощник сценариста▸
 AI Приложения
 AI Новости
Qwen2.5-Omni: универсальная мультимодальная флагманская модель Alibaba с сквозной архитектурой
小编 ·

Qwen2.5-Omni: универсальная мультимодальная флагманская модель Alibaba с сквозной архитектурой
Что такое Qwen2.5-Omni?
Qwen2.5-Omni — это новая флагманская мультимодальная модель end-to-end из серии Qwen, выпущенная Alibaba. Она специально разработана для всестороннего мультимодального восприятия, то есть способна понимать текст, аудио, изображения, видео, одновременно думать и говорить, а также генерировать текст и синтезировать естественную речь в реальном времени с потоковым выводом — это модель ИИ.
Основные особенности Qwen2.5-Omni
Инновационная архитектура:
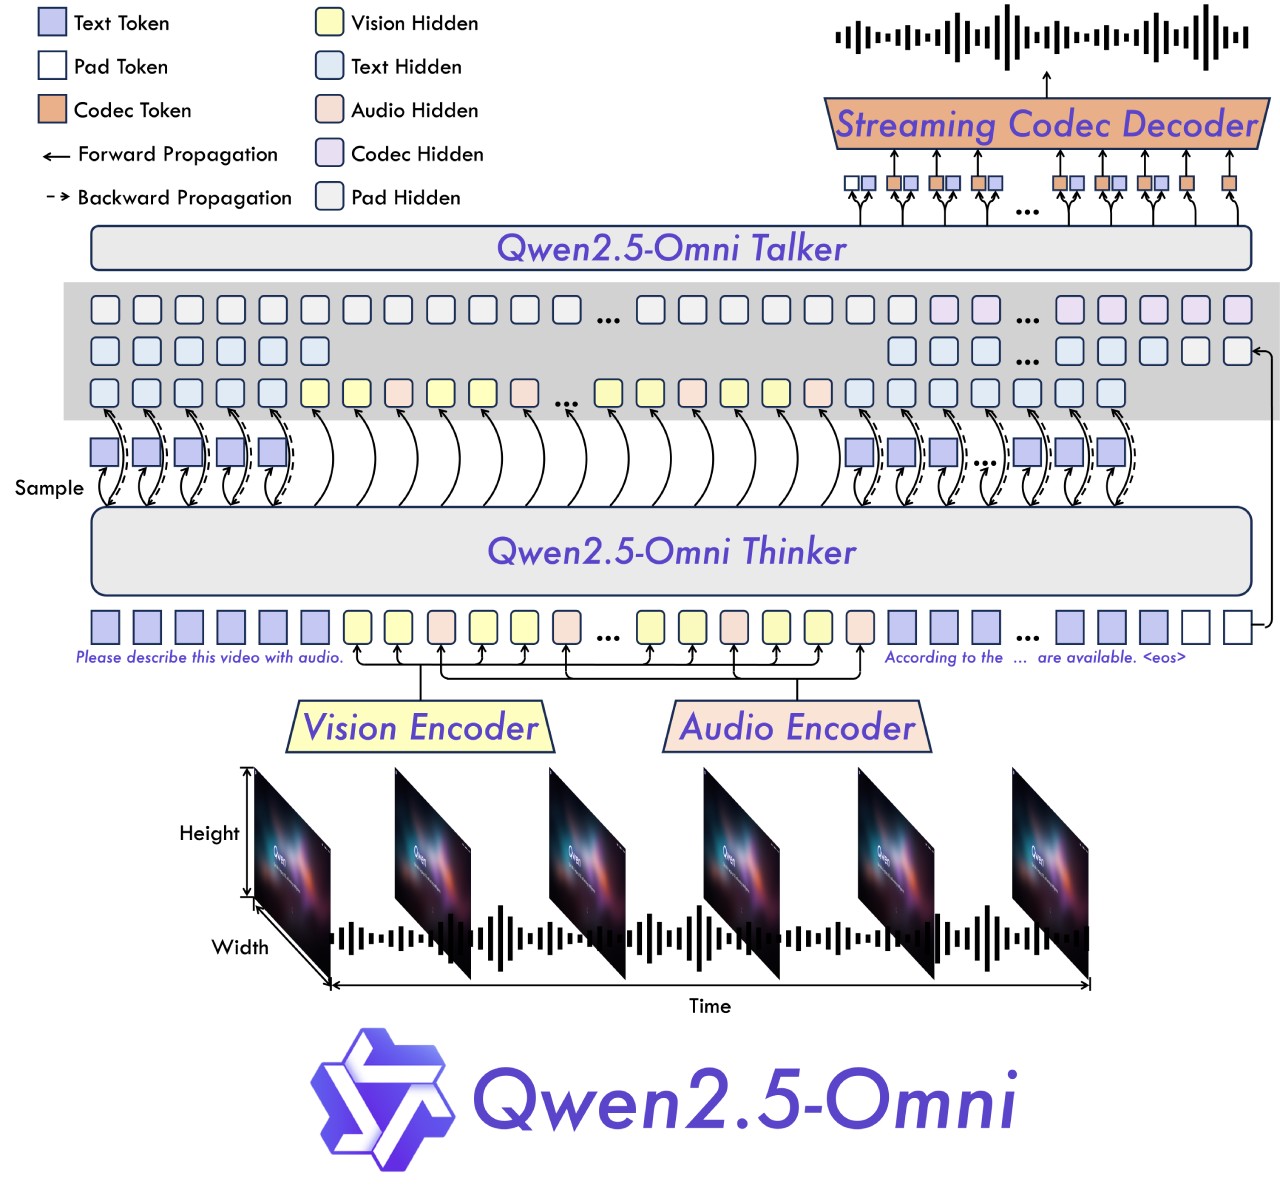
Архитектура Thinker-Talker: Thinker отвечает за обработку и понимание входных данных из текстовой, аудио- и видеомодальностей, генерируя высокоуровневые семантические представления и соответствующий текстовый контент; Talker преобразует этот контент в вывод естественной речи.
Технология TMRoPE: предложен новый метод позиционного кодирования под названием TMRoPE (Time-aligned Multimodal RoPE), предназначенный для синхронизации временны́х меток видеовхода и аудио.
Взаимодействие в реальном времени:
Поддерживается полностью интерактивное взаимодействие в реальном времени с возможностью обработки ввода по частям и мгновенного вывода.
Естественная и плавная генерация речи:
По естественности и стабильности генерации речи превосходит многие существующие потоковые и непотоковые аналоги.
Преимущества во всех модальностях:
Показывает отличные результаты в мультимодальных задачах (таких как OmniBench), а также превосходно справляется с одномодальными задачами (распознавание речи, перевод, понимание аудио, логические рассуждения по изображениям, понимание видео и др.).
Способность следовать голосовым инструкциям end-to-end:
В следовании голосовым инструкциям в режиме end-to-end демонстрирует результаты, сопоставимые с обработкой текстового ввода, и показывает отличные результаты в бенчмарках MMLU и GSM8K.
Архитектура Qwen2.5-Omni
Thinker: подобен мозгу, отвечает за обработку и понимание входных данных из текстовой, аудио- и видеомодальностей, генерируя высокоуровневые семантические представления и соответствующий текстовый контент.
Talker: подобен человеческому рту, принимает высокоуровневые семантические представления и текстовый контент, сгенерированные Thinker, и потоково выводит естественную речь.
Общая архитектура: Thinker представляет собой декодер Transformer, оснащённый энкодерами для аудио и изображений для извлечения информации. Talker — это двуTrackовый авторегрессионный декодер Transformer. Во время обучения и инференса Talker напрямую получает высокоразмерные представления от Thinker и использует всю информацию о контексте, разделяемую с Thinker; вся архитектура обучается и выполняет инференс как единая модель в режиме end-to-end.
Производительность Qwen2.5-Omni
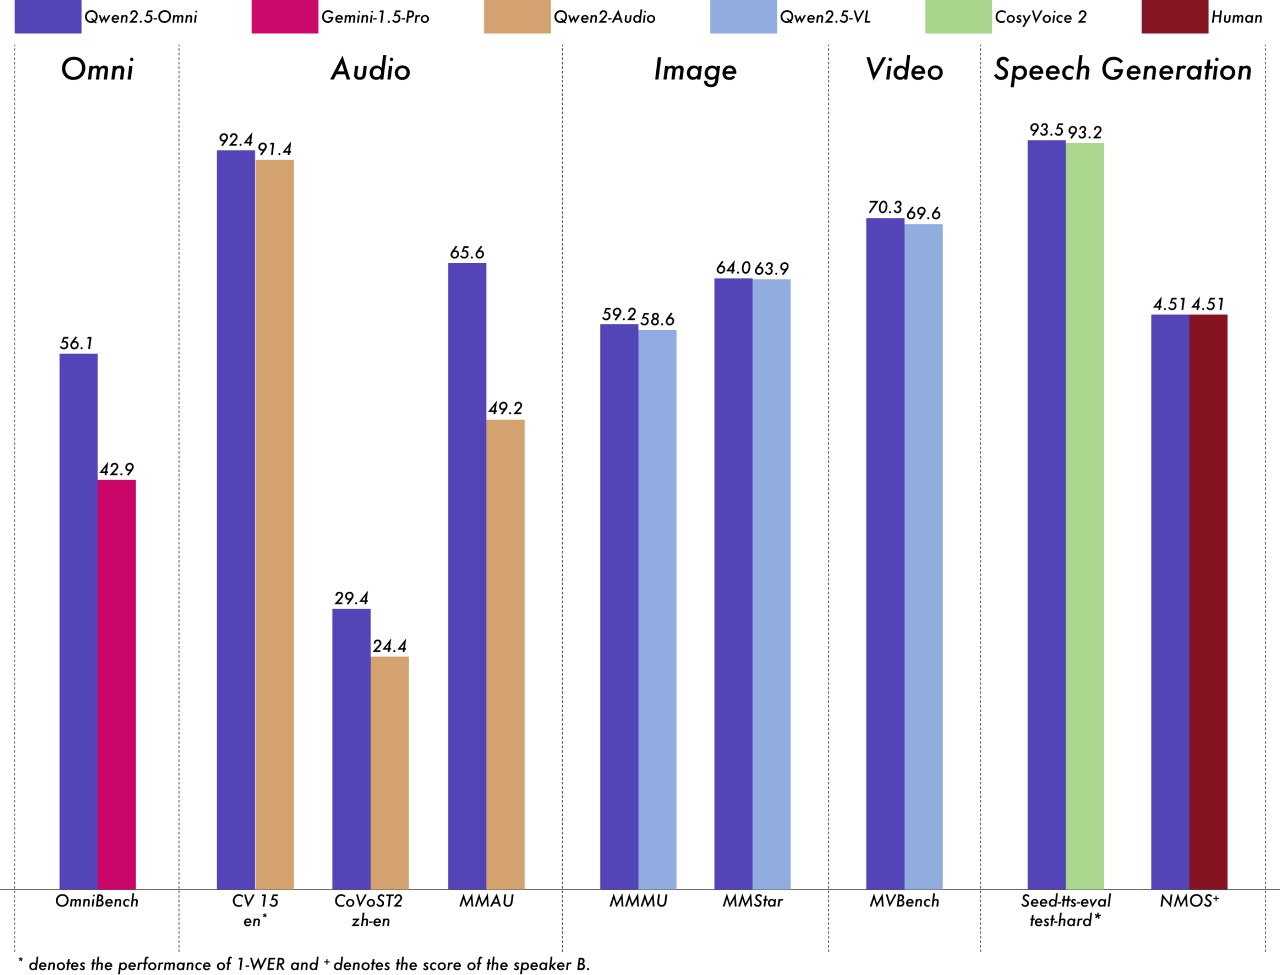
В мультимодальных задачах (таких как OmniBench) Qwen2.5-Omni достигает самых современных результатов.
В одномодальных задачах она показывает выдающиеся результаты в распознавании речи (Common Voice), переводе (CoVoST2), понимании аудио (MMAU), логических рассуждениях по изображениям (MMMU, MMStar), понимании видео (MVBench) и генерации речи (Seed-tts-eval и субъективная оценка естественности).
Полезные ссылки
Qwen Chat:https://chat.qwenlm.ai
Hugging Face:https://huggingface.co/Qwen/Qwen2.5-Omni-7B
ModelScope:https://modelscope.cn/models/Qwen/Qwen2.5-Omni-7B
DashScope:https://help.aliyun.com/zh/model-studio/user-guide/qwen-omni
GitHub:https://github.com/QwenLM/Qwen2.5-Omni
Демо:https://modelscope.cn/studios/Qwen/Qwen2.5-Omni-Demo









