
 Помощник сценариста▸
 AI Приложения
 AI Новости
KDTalker: генерация реалистичных выражений лица и движений по аудио
小编 ·

KDTalker: генерация реалистичных выражений лица и движений по аудио
Что такое KDTalker?
KDTalker — это инструмент для генерации динамических портретов на основе аудио, способный создавать реалистичные выражения лица и движения по входному аудиосигналу. KDTalker обладает такими возможностями, как технология неявных ключевых точек, пространственно-временная диффузионная модель и разнообразие поз. Подходит для виртуальной реальности, социальных сетей, видеоконференций и многих других сценариев. Благодаря простой подготовке окружения и работе через командную строку пользователи могут быстро генерировать высококачественные видео с динамическими портретами.
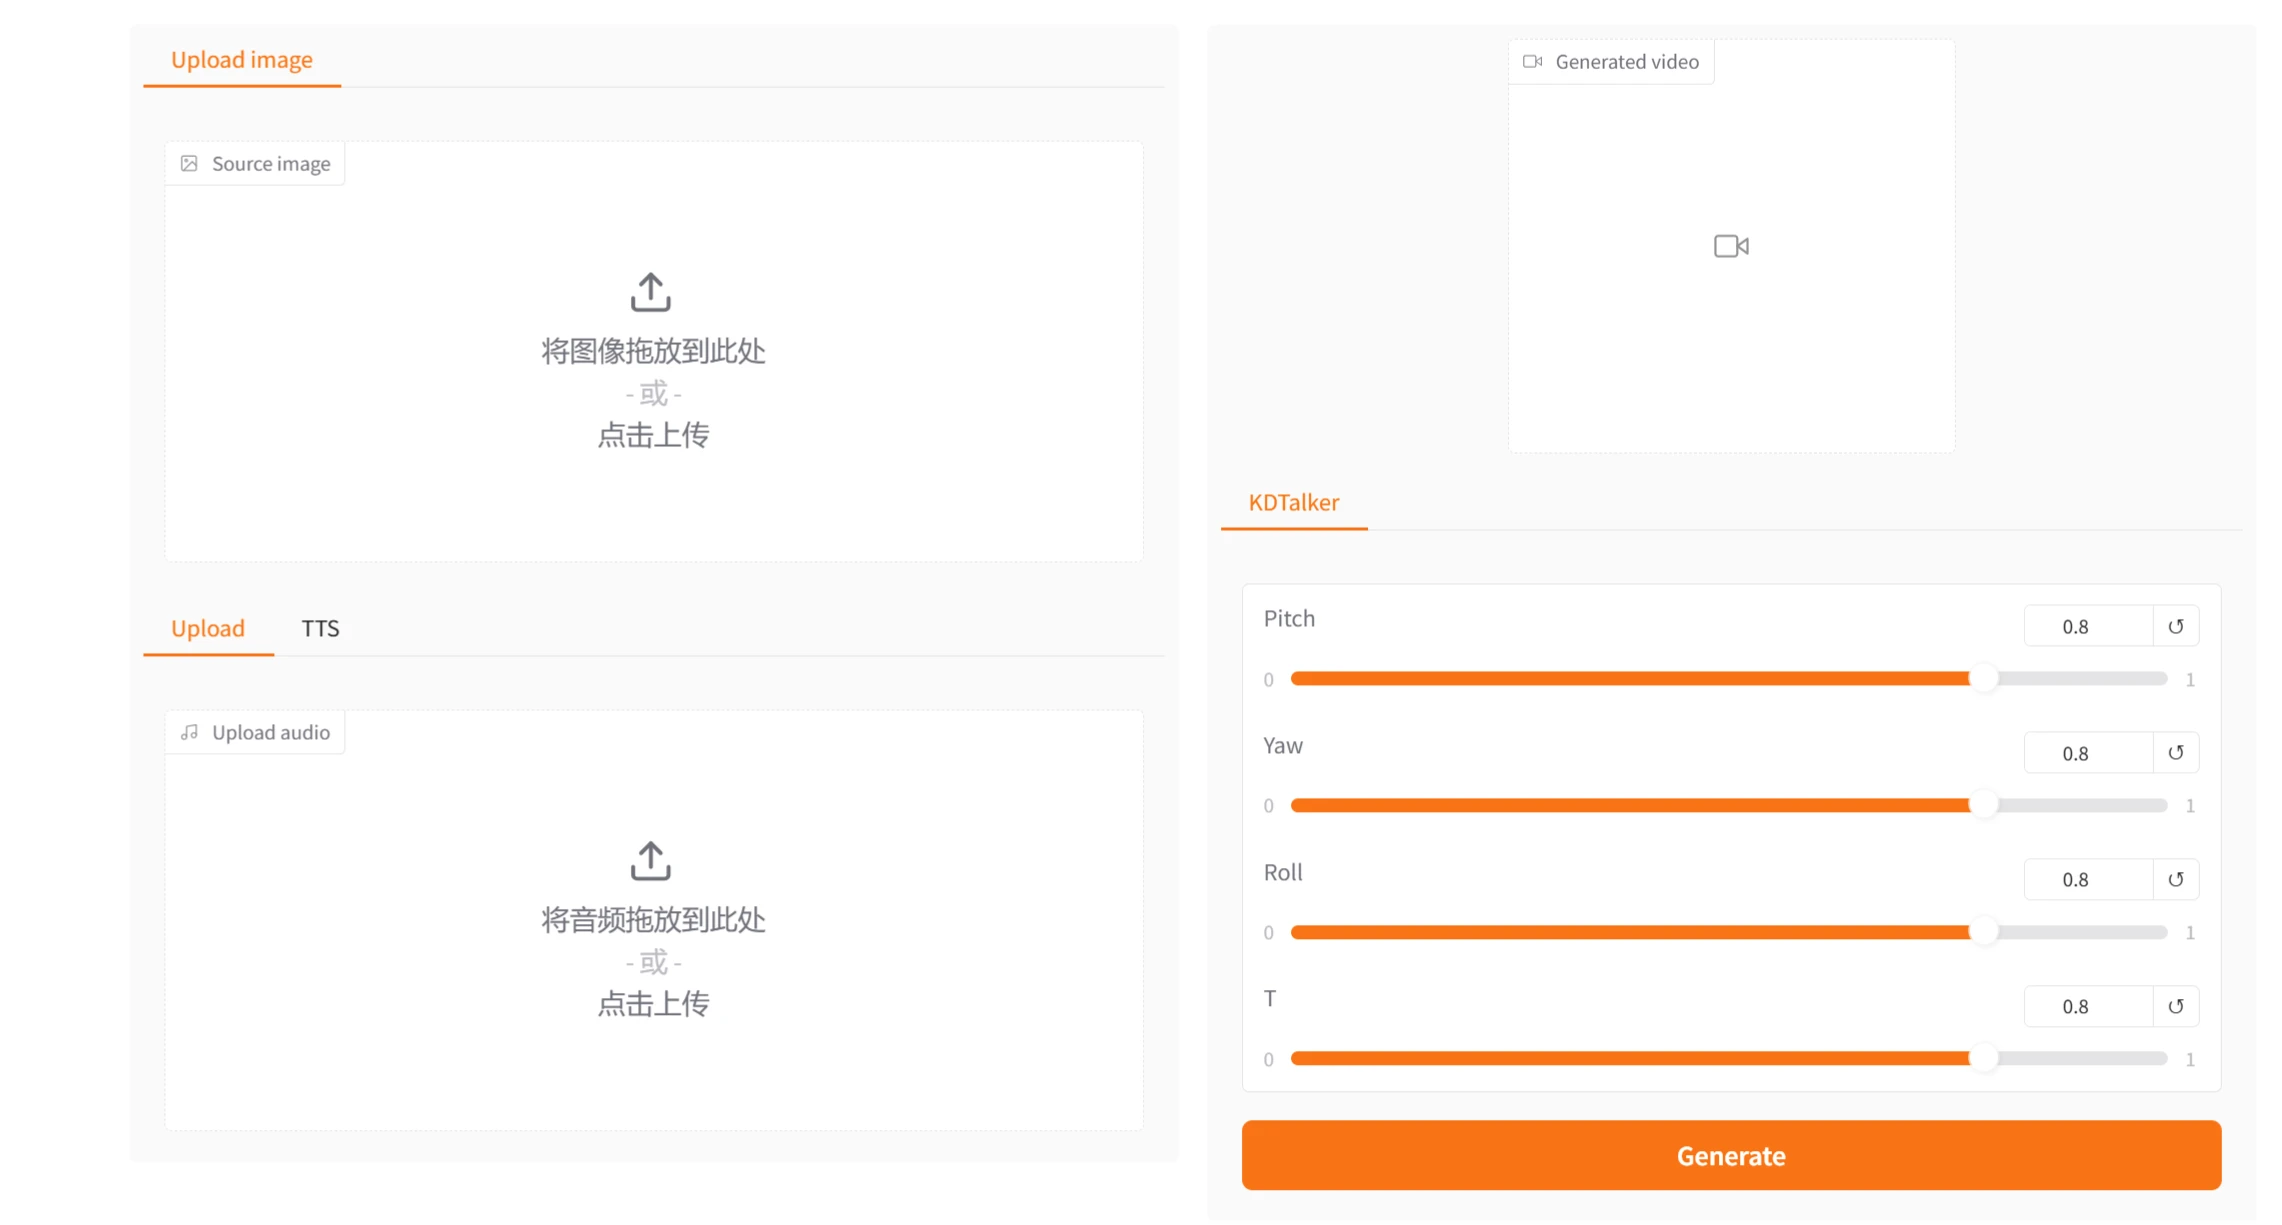
Функциональные особенности KDTalker
Технология неявных ключевых точек:
Использование неявных ключевых точек позволяет улавливать тонкие изменения выражений лица и движений, более естественно отражая связь между аудио и мимикой.
По сравнению с традиционными методами явных ключевых точек, неявные ключевые точки позволяют избежать сложности и погрешностей явной разметки.
Пространственно-временная диффузионная модель:
Сочетание пространственно-временной диффузионной модели обеспечивает более плавные и согласованные динамические эффекты при сохранении качества и стабильности изображения.
Пространственно-временная диффузионная модель обеспечивает лучшую обработку временной непрерывности в видеопоследовательностях.
Разнообразие поз:
Поддержка генерации множества поз с возможностью динамической подстройки положения персонажа в соответствии с аудиоконтентом, что увеличивает разнообразие и естественность результатов.
Пользователи могут задавать различные стили поз для создания более персонализированных динамических портретов.
Высокая эффективность:
Оптимизированная архитектура модели и эффективный вычислительный конвейер позволяют технологии работать на одной видеокарте RTX 4090 или RTX 3090, обеспечивая высокую практичность и масштабируемость.
Подходит для использования на устройствах с ограниченными ресурсами при сохранении высокой скорости генерации.
Высокое качество генерации:
Сгенерированные динамические портреты обладают высоким разрешением и реалистичностью, удовлетворяя требованиям к качественной генерации видео.
Предобученные модели и оптимизированный процесс инференса обеспечивают стабильность и согласованность результатов.
Сценарии применения KDTalker
Виртуальная реальность (VR) и дополненная реальность (AR):
В приложениях VR и AR KDTalker может создавать реалистичные динамические портреты виртуальных персонажей, повышая удобство работы пользователей.
Например, на виртуальных совещаниях пользователи могут с помощью аудио генерировать собственные динамические портреты, делая удалённое общение более естественным.
Социальные сети и создание видеоконтента:
Пользователи могут загрузить свои фотографии и аудио в KDTalker и создавать персонализированные видео с динамическими портретами для публикации в социальных сетях.
Создатели контента могут использовать эту технологию для генерации интересных видео, повышая их привлекательность.
Видеоконференции:
На видеоконференциях нестабильная сеть может вызывать зависания или размытие видео. KDTalker позволяет с помощью аудио генерировать плавные динамические портреты, сохраняя хорошее визуальное качество даже при низкой пропускной способности канала.
Развлечения и игры:
В играх и развлекательных приложениях KDTalker может генерировать динамические выражения лица и движения виртуальных персонажей, усиливая эффект погружения.
Например, в ролевых играх игроки могут с помощью аудио создавать динамические портреты своих персонажей.
Образование и обучение:
В сценариях образования и обучения KDTalker может создавать динамические портреты преподавателей или инструкторов для использования в онлайн-курсах или обучающих видео.
Динамические портреты, сгенерированные по аудио, делают учебный контент более живым и повышают эффективность обучения.
Как пользоваться KDTalker
1. Подготовка окружения
Требования к оборудованию: рекомендуется использовать видеокарту RTX 4090 или RTX 3090.
Программные зависимости:
Установите git, conda и FFmpeg.
Клонируйте репозиторий и создайте окружение Python:
git clone https://github.com/chaolongy/KDTalker
cd KDTalker
# 创建并激活conda环境
conda create -n KDTalker python=3.9
conda activate KDTalker
# 安装PyTorch和其他依赖
conda install pytorch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 pytorch-cuda=11.8 -c pytorch -c nvidia
pip install -r requirements.txt
2. Загрузка весов предобученной модели
Скачайте файлы весов предобученной модели с Google Drive или Hugging Face и поместите их в каталоги ./pretrained_weights и ./ckpts.
Убедитесь, что структура каталогов выглядит следующим образом:
pretrained_weights
├── insightface
│   └── models
│       └── buffalo_l
│           ├── 2d106det.onnx
│           └── det_10g.onnx
└── liveportrait
    ├── base_models
    │   ├── appearance_feature_extractor.pth
    │   ├── motion_extractor.pth
    │   ├── spade_generator.pth
    │   └── warping_module.pth
    ├── landmark.onnx
    └── retargeting_models
        └── stitching_retargeting_module.pth
3. Запуск инференса
Используйте следующую команду для запуска скрипта инференса и генерации видео с динамическим портретом:
python inference.py -source_image ./example/source_image/WDA_BenCardin1_000.png -driven_audio ./example/driven_audio/WDA_BenCardin1_000.wav -output ./results/output.mp4
-source_image: путь к исходному изображению.
-driven_audio: путь к управляющему аудиофайлу.
-output: путь сохранения выходного видео.
Адрес проекта: https://github.com/chaolongy/KDTalker
ДЕМО: https://kdtalker.com/









