
 Помощник сценариста▸
 AI Приложения
 AI Новости
Fin-R1: финансовая рассуждающая большая языковая модель на базе Qwen2.5
小编 ·

Fin-R1: финансовая рассуждающая большая языковая модель на базе Qwen2.5
Что такое Fin-R1?
Fin-R1 — это финансовая рассуждающая большая языковая модель, разработанная совместно командой профессора Чжан Ливэня (张立文) из Школы статистики и науки о данных Шанхайского университета финансов и экономики (SUFE-AIFLM-Lab) и компанией Caiyue Star (财跃星辰). Fin-R1 основан на модели Qwen2.5-7B-Instruct и использует фреймворк DeepSeek-R1 для «дистилляции данных» и «двухэтапной фильтрации качества». Благодаря контролируемому дообучению на высококачественных данных цепочки рассуждений и обучению с подкреплением модель эффективно решает такие проблемы финансовой отрасли, как фрагментация данных, неконтролируемая логика рассуждений и недостаточная способность к обобщению бизнес-задач, обеспечивая мощную поддержку интеллектуальной трансформации финансовой индустрии.
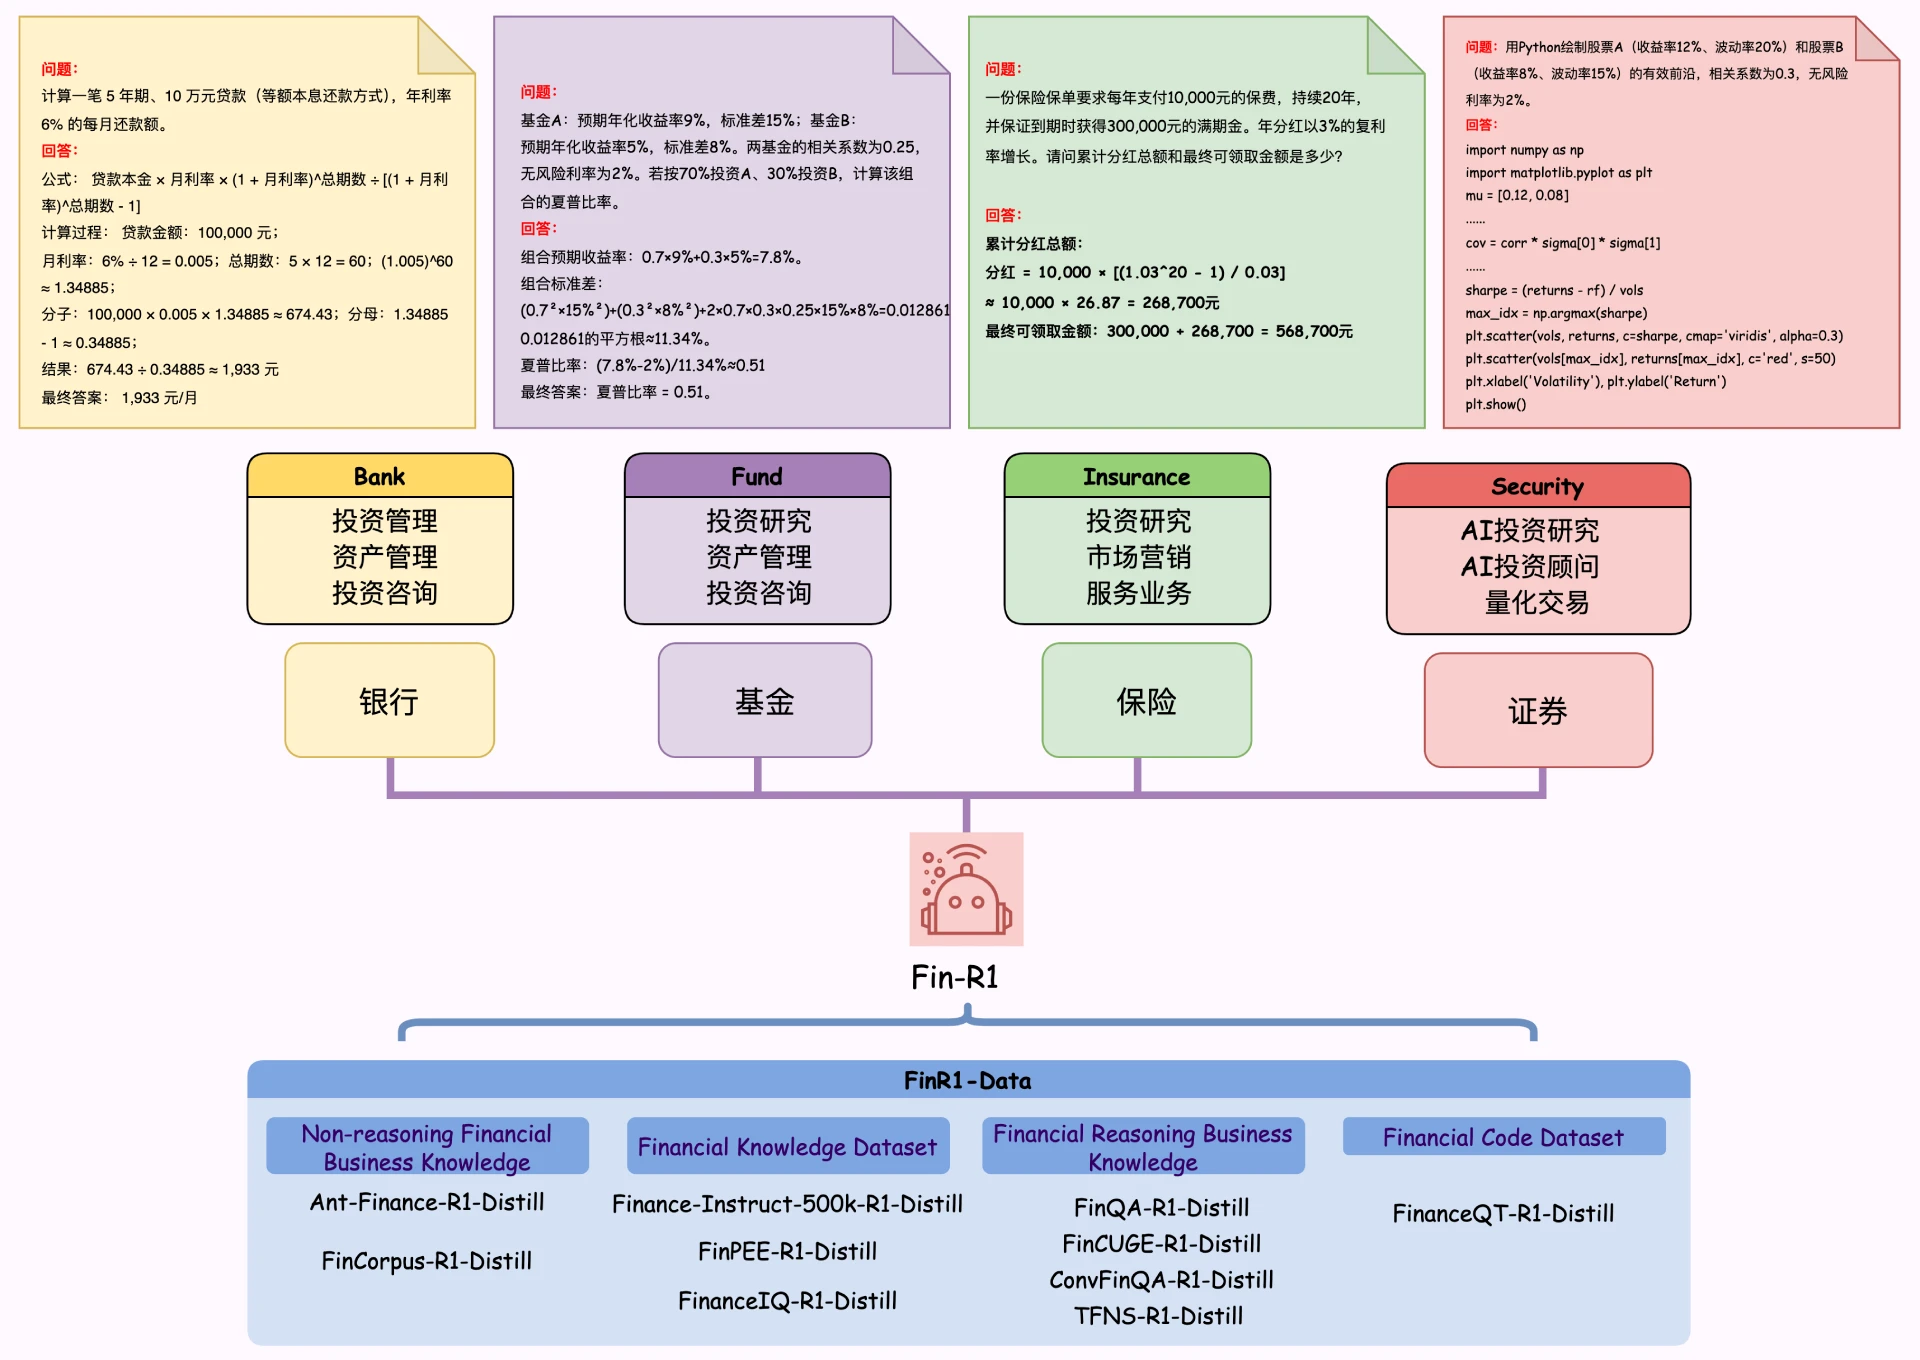
Архитектура модели
Fin-R1 обучается с использованием двухэтапной архитектуры:
Этап генерации данных: с помощью методов дистилляции и фильтрации данных из нескольких авторитетных источников формируется высококачественный набор финансовых рассуждений Fin-R1-Data.
Этап обучения модели: на базе модели Qwen2.5-7B-Instruct обучение проводится с помощью контролируемого дообучения (SFT) и обучения с подкреплением (RL).
Особенности набора данных Fin-R1
Масштаб и качество: Fin-R1-Data содержит около 60 091 полной цепочки рассуждений (CoT) и охватывает многомерные профессиональные знания в финансовой вертикали на китайском и английском языках.
Модульная структура: набор данных разделён на четыре основных модуля — финансовый код, профессиональные финансовые знания, нерассуждающие бизнес-знания в финансах и рассуждающие бизнес-знания в финансах.
Ключевые особенности Fin-R1
Профильная специализация: ориентация на финансовые рассуждения, охват финансового кода, профессиональных знаний, бизнес-знаний и других аспектов.
Управление данными: обучение на высококачественном наборе финансовых рассуждений Fin-R1-Data, содержащем около 60 091 полной цепочки рассуждений.
Метод обучения: сочетание контролируемого дообучения (SFT) и обучения с подкреплением (RL) обеспечивает точность и надёжность модели в задачах финансового рассуждения.
Лёгкая архитектура: количество параметров составляет всего 7 миллиардов, при этом модель демонстрирует высокую производительность.
Показатели производительности
Авторитетные оценки: в авторитетных бенчмарках финансовой отрасли модель набирает в среднем 75,2 балла и занимает второе место.
Результаты по задачам: в задачах FinQA и ConvFinQA модель получает 76,0 и 85,0 балла соответственно, занимая первое место среди участников.
Способность к обобщению: в других финансовых бенчмарках также демонстрирует сильную способность к обобщению между различными задачами.
Применение Fin-R1
Финансовый код: программный код для реализации финансовых моделей, алгоритмов и аналитических задач — программирование.
Финансовые вычисления: выполнение количественного анализа и расчётов для обоснования финансовых решений.
Финансовая безопасность и комплаенс: предотвращение финансовых преступлений и обеспечение соответствия бизнес-операций нормативным требованиям.
Интеллектуальное управление рисками: использование технологий ИИ и больших данных для выявления и управления финансовыми рисками.
ESG-анализ: оценка деятельности компаний в области экологии, социальной ответственности и корпоративного управления.
Шаги по использованию Fin-R1
Загрузка модели: скачайте веса модели со страницы на Hugging Face.
Запуск сервиса: запустите сервис модели с помощью инструмента vllm.
Запуск инференса: вызывайте модель для рассуждений через API в формате OpenAI.
Ссылки по теме Fin-R1
Скачать модель:https://huggingface.co/SUFE-AIFLM-Lab/Fin-R1
Статья:https://arxiv.org/pdf/2503.16252









