
 Помощник сценариста▸
 AI Приложения
 AI Новости
Читу (Chitu): высокопроизводительный фреймворк для инференса LLM с открытым исходным кодом от команды Цинхуа
小编 ·

Читу (Chitu): высокопроизводительный фреймворк для инференса LLM с открытым исходным кодом от команды Цинхуа
Что такое 赤兔 (Chitu)?
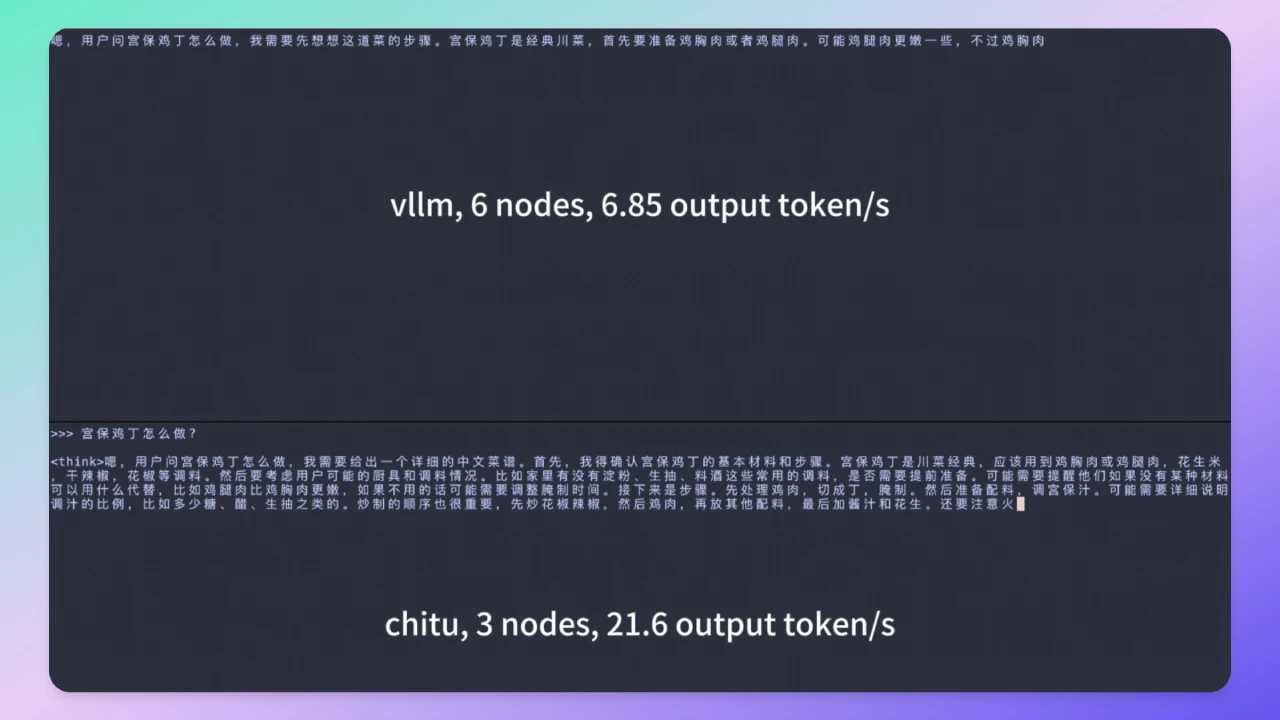
赤兔 (Chitu) — это высокопроизводительный фреймворк инференса для больших языковых моделей с открытым исходным кодом, разработанный командой Университета Цинхуа. Он ориентирован на повышение эффективности инференса, снижение затрат и поддерживает множество аппаратных платформ и сценариев развёртывания. Он позволяет сократить затраты на инференс DeepSeek вдвое при удвоении производительности. Цель 赤兔 (Chitu) — предоставить предприятиям и разработчикам эффективный, гибкий и простой в развёртывании движок инференса, ускоряя внедрение больших языковых моделей (LLM) в реальных приложениях.
Функциональные особенности 赤兔 (Chitu)
Поддержка разнообразных вычислительных ресурсов: поддерживает множество серий продуктов NVIDIA от новейших флагманов до старых моделей, а также обеспечивает оптимизированную поддержку отечественных чипов.
Масштабируемость для любых сценариев: от развёртывания на чистом CPU и одиночном GPU до крупномасштабных кластерных развёртываний — гибкие масштабируемые решения.
Долговременная стабильная работа: подходит для реальных производственных сред, способен стабильно выдерживать параллельную бизнес-нагрузку.
Высокая производительность инференса: в тестах на кластере A800 по сравнению с некоторыми зарубежными фреймворками с открытым исходным кодом при сокращении использования GPU на 50% скорость инференса увеличена в 3,15 раза.
Снижение затрат: за счёт оптимизации использования аппаратных ресурсов снижается порог входа и стоимость развёртывания моделей ai для предприятий.
Сценарии применения 赤兔 (Chitu)
Корпоративные AI-приложения: требующие высокой производительности, низкой задержки и высокой пропускной способности сервисов инференса.
Крупномасштабные кластерные развёртывания: сценарии, требующие эффективной работы в средах с несколькими GPU или узлами.
Среды с ограниченными ресурсами: сценарии, в которых необходимо обеспечить эффективный инференс при ограниченных аппаратных ресурсах.
Адаптация к отечественным чипам: сценарии, в которых необходимо запускать большие языковые модели на отечественных аппаратных платформах.
Как использовать 赤兔 (Chitu)
1. Установка из исходного кода
git clone --recursive https://github.com/thu-pacman/chitu && cd chitu
pip install -r requirements-build.txt
pip install -U torch --index-url https://download.pytorch.org/whl/cu124  # 根据 CUDA 版本调整
TORCH_CUDA_ARCH_LIST=8.6 CHITU_SETUP_JOBS=4 MAX_JOBS=4 pip install --no-build-isolation
2. Инференс на одном GPU
torchrun --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1 infer.pp_size=1 infer.tp_size=8
3. Гибридный параллелизм (TP+PP)
torchrun --nnodes 2 --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 infer.pp_size=2 infer.tp_size=8 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1
4. Запуск сервиса
export WORLD_SIZE=8
torchrun --nnodes 1 \
--nproc_per_node 8 \
--master_port=22525 \
example/serve.py \
serve.port=21002 \
infer.stop_with_eos=False \
infer.cache_type=paged \
infer.pp_size=1 \
infer.tp_size=8 \
models=DeepSeek-R1 \
models.ckpt_dir=/data/DeepSeek-R1 \
keep_dtype_in_checkpoint=True \
infer.mla_absorb=absorb-without-precomp \
infer.soft_fp8=True \
infer.do_load=True \
infer.max_reqs=1 \
scheduler.prefill_first.num_tasks=100 \
infer.max_seq_len=4096 \
request.max_new_tokens=100 \
infer.use_cuda_graph=True
5. Тестирование производительности
python benchmarks/benchmark_serving.py \
--model "deepseek-r1" \
--iterations 10 \
--seq-len 10 \
--warmup 3 \
--base-url http://localhost:21002
Репозиторий на GitHub:https://github.com/thu-pacman/chitu









